pg_textsearch:把 BM25 相关性搜索嵌进 PostgreSQL
阅读时间: 大约 14 分钟
pg_textsearch:把 BM25 相关性搜索嵌进 PostgreSQL
PostgreSQL 自带的全文搜索(tsvector/tsquery)解决了”能不能搜到”的问题,却长期缺少信息检索领域最常用的 BM25 相关性排序:结果只能按布尔匹配或简单权重返回,无法像 Elasticsearch 那样按相关度给文档打分。Timescale(TimescaleDB 母公司)开源的 pg_textsearch 正是为补上这块短板而生:一个以 C 扩展形式嵌入 Postgres 的 BM25 搜索引擎,让开发者不必引入外部搜索引擎,就能在数据库内完成相关性排序检索。本文基于项目官方 README、架构文档与官方自测基准页,对其机制、性能数据与局限做一次客观分析。
一、背景:为什么 Postgres 缺一个 BM25
PostgreSQL 原生全文搜索的工作方式是把文档切分成 lexeme 存入 tsvector,查询用 tsquery 做布尔匹配(AND/OR/NOT、短语、前缀),排序依赖 ts_rank 这个由词频与字段权重拼凑出的简单函数,并非经典 IR 模型。对于”商品搜索、站内文章检索、日志关键词排序”这类需要”最相关的十条排前面”的场景,原生能力不够用,社区传统做法是外挂 Elasticsearch、OpenSearch 或 Meilisearch——多一套集群、多一份数据同步、多一层运维成本。
pg_textsearch 的思路是把 BM25 索引直接做成 Postgres 的一种索引访问方法(AM),用标准 SQL 完成建索引与排序查询,目标是让中小型项目”一个 Postgres 实例搞定搜索”。
二、是什么:库内 BM25 索引与 <@> 操作符
项目把 BM25 封装成一种新的索引类型,建索引语法与普通索引几乎一致:
CREATE EXTENSION pg_textsearch;

CREATE INDEX docs_idx ON documents
  USING bm25(content) WITH (text_config='english');

SELECT * FROM documents
ORDER BY content <@> 'database system' LIMIT 5;<@>是 BM25 打分操作符,返回负分(便于按升序索引扫描),分数越低排名越靠前;- BM25 的两个经典参数
k1(词频饱和,默认 1.2)与b(文档长度归一化,默认 0.75)在建索引时可配置; - 复用 Postgres 自带的文本搜索配置(english、german、french 等),中文可配合
zhparser分词器; - 支持表达式索引(JSONB 字段抽取、多列拼接、数组)、部分索引(
WHERE子集)与分区表; - 布尔过滤仍走 Postgres 的
@@/tsquery语法,可与 BM25 排序组合。
官方要求把扩展加入 shared_preload_libraries,目前支持 PostgreSQL 17 与 18,PostgreSQL 19(beta)为尽力支持,不提供预编译二进制。
三、技术机制:LSM 段、Block-Max WAND 与并行建索引
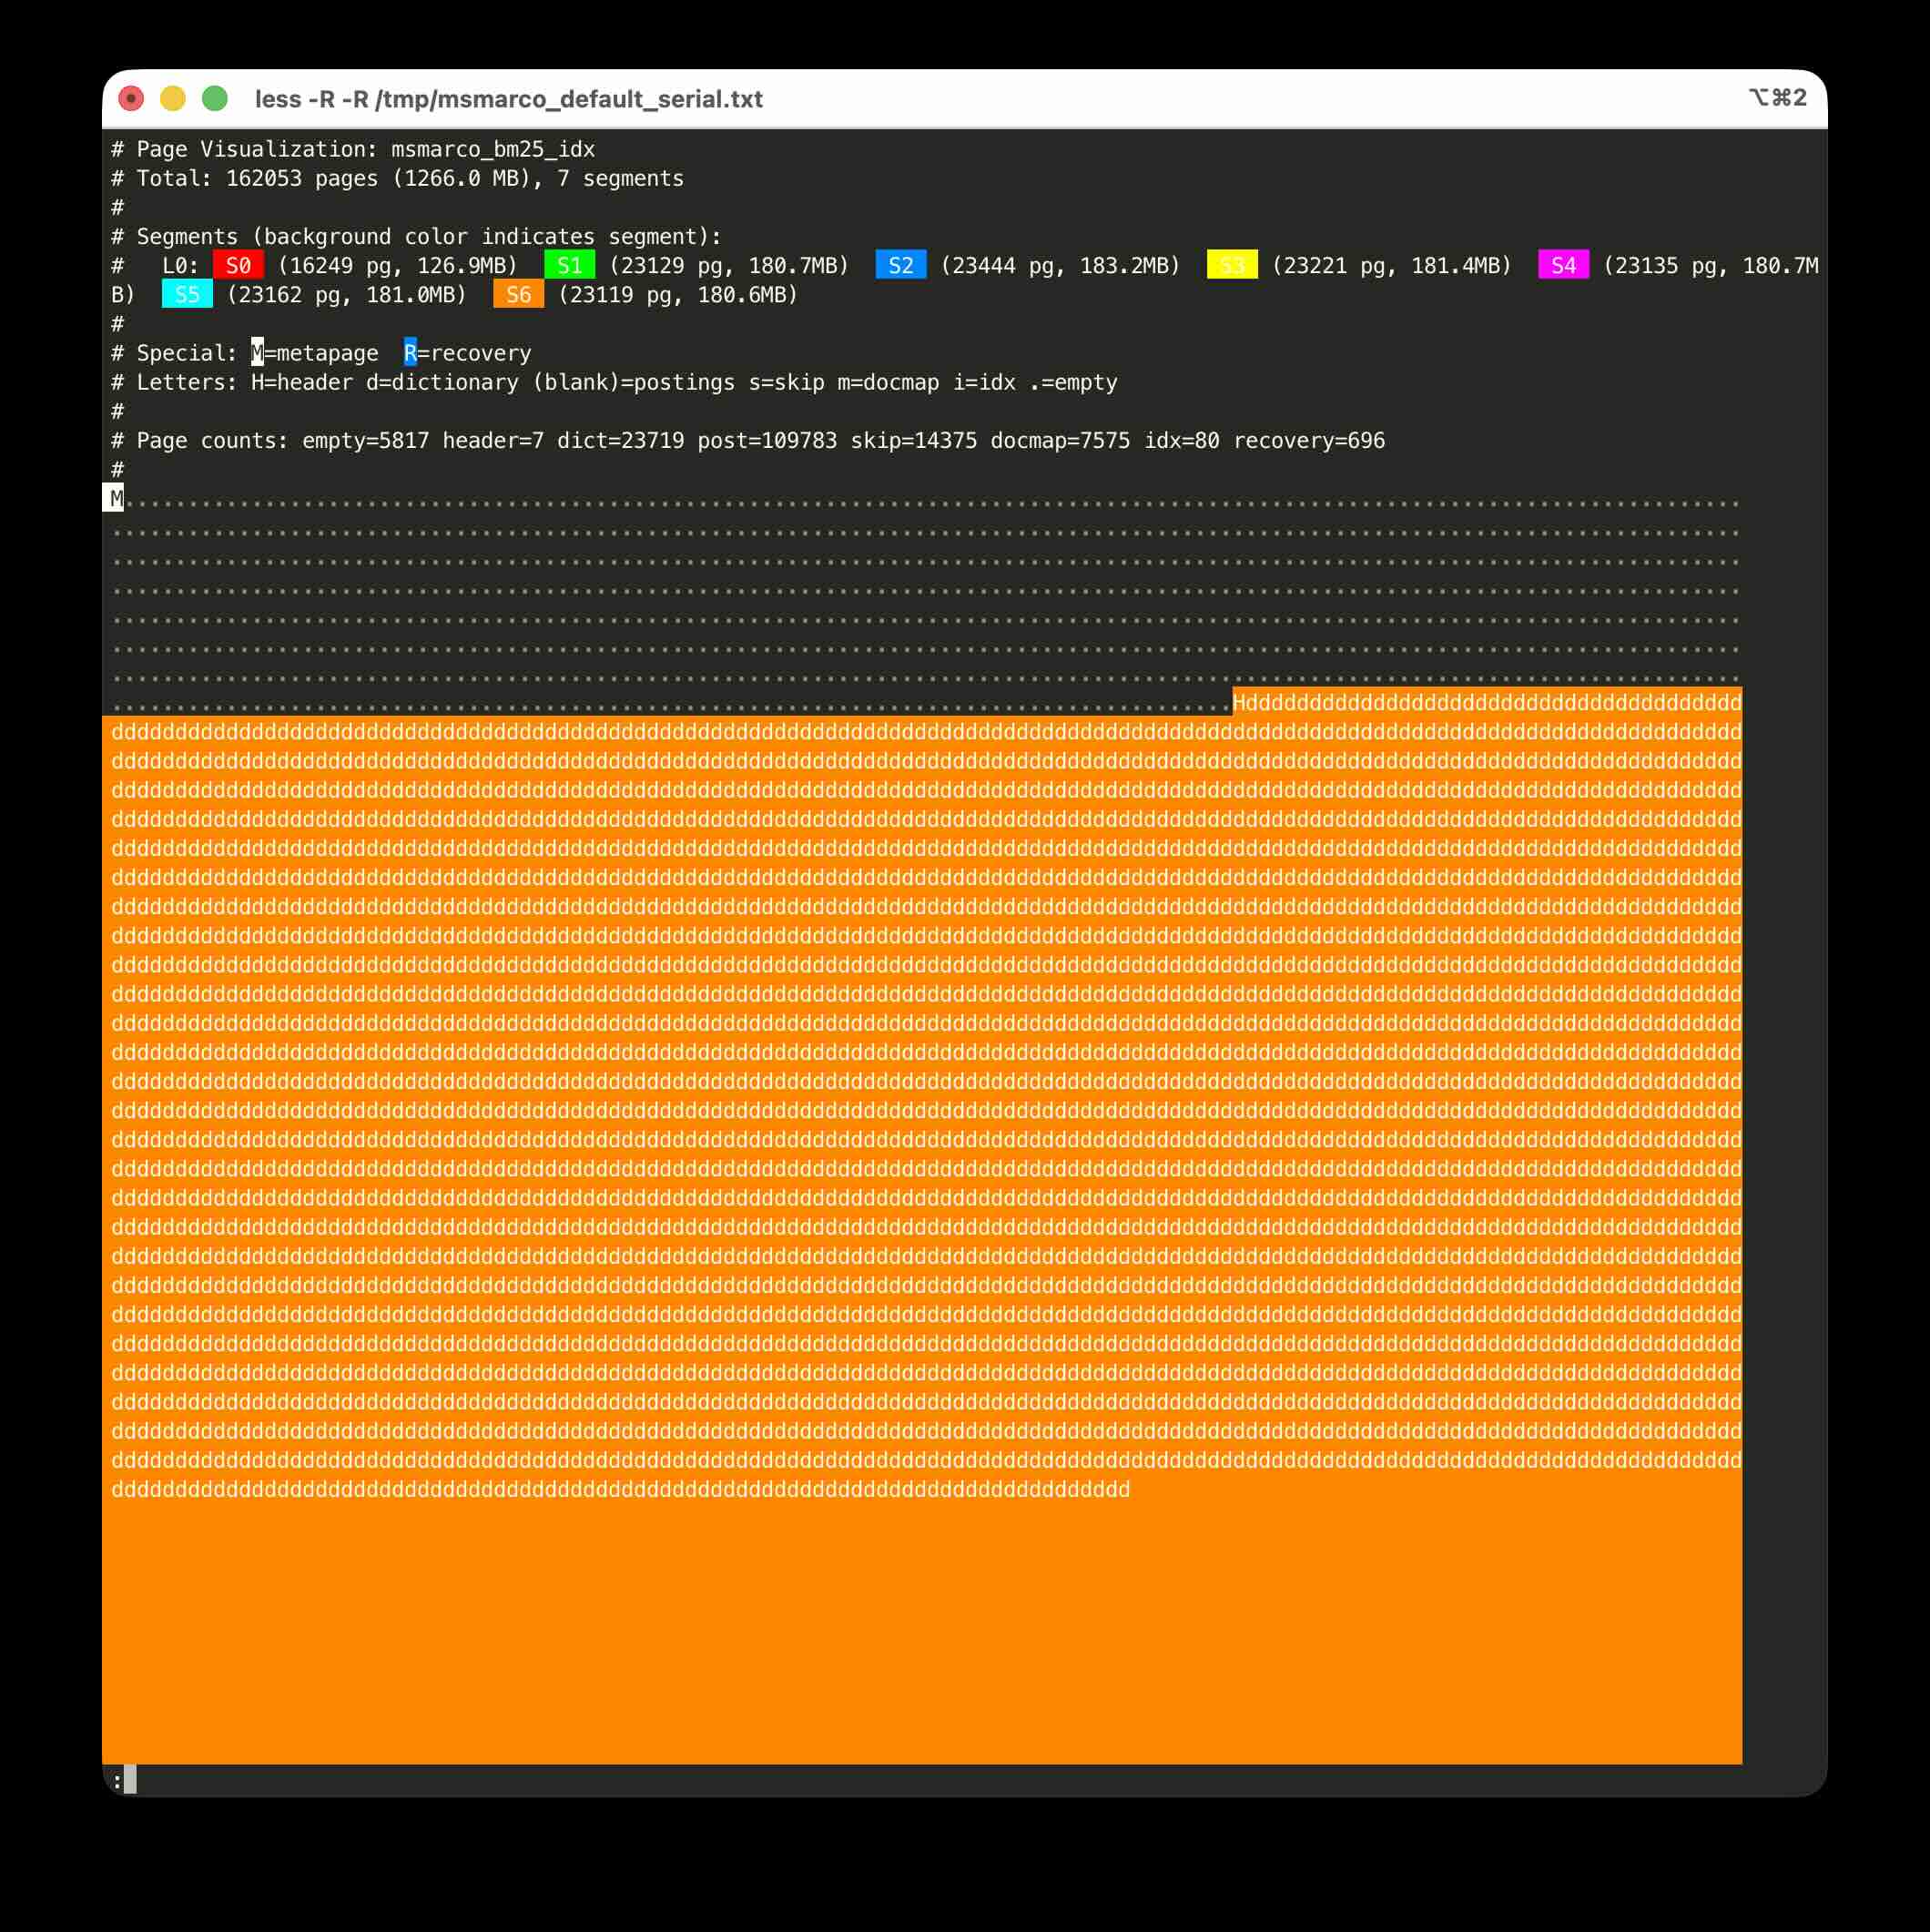
从官方 README 与基准页披露的细节看,其内部是一套类 Lucene/LSM 的倒排索引结构:
- Memtable + 段(segment):写入先进 WAL 记录的内存 memtable,达到阈值(
memtable_pages_threshold默认 64 链页、bulk_load_threshold默认每事务 10 万词项)后 spill 成磁盘段;段内 posting list 做压缩,段之间按层级合并(compaction),segments_per_level默认 8。上面这张官方 pageviz 截图就是 MS MARCO 8.8M 语料索引的真实页面布局:共 162053 页、1266.0MB、7 个段,图中字母d为字典页、p为 posting 页、s为跳过页。 - Block-Max WAND 快速 top-k:当 Postgres 选择 BM25 索引扫描做
ORDER BY ... LIMIT n时,打分采用 Block-Max WAND 算法——利用块级最大得分上界提前跳过不可能进入 top-k 的块,官方基准页还提到缓存 skip entry 与可复用解压缓冲(PR #274)把每块开销降低 20–25%。 - SIMD 解码:位打包(bitpack)解码使用 SIMD 指令(PR #250),配合栈上分配的解码缓冲(PR #253)减少分配开销。
- 并行建索引:大表由 Postgres 并行 worker 分担扫描与分词,
max_parallel_maintenance_workers控制并发;但合并阶段为单线程 I/O 密集(见下文 138M 基准的官方说明)。
四、关键数据:官方自测的 MS MARCO 基准
需要先说明口径:以下数字全部来自项目官方维护的基准页(GitHub Pages),由项目方在 GitHub Actions runner 上自测,对比对象仅为 ParadeDB v0.21.6,使用双方默认配置,且为单次运行,官方自己标注”两次运行间约有 10% 波动”。
MS MARCO v1:880 万段落(2026-03-10,commit f31d1af)
| 指标 | pg_textsearch | ParadeDB v0.21.6 | 差异 |
|---|---|---|---|
| 800 条查询总耗时 | 8.03 秒 | 25.07 秒 | -68%(约 3.1x 吞吐) |
| 平均每查询 | 10.04 ms | 31.33 ms | -68% |
| 索引体积 | 1,215 MB | 1,503 MB | -19% |
| 建索引耗时 | 233.5 秒 | 140.1 秒 | +67%(慢 1.7x) |
p50 中位延迟(毫秒,越低越好)随查询词数变化明显:
| 查询词数 | pg_textsearch p50 | ParadeDB p50 | 差距 |
|---|---|---|---|
| 1 token | 0.70 | 18.84 | -96% |
| 3 tokens | 3.00 | 24.74 | -88% |
| 5 tokens | 7.63 | 29.16 | -74% |
| 8+ tokens | 26.32 | 44.87 | -41% |
MS MARCO v2:1.38 亿段落(另一套硬件,两组数字不可直接比较)
官方另跑了 138,364,158 段落的全量 v2 实验(Intel Xeon Platinum 8375C、123GB 内存、NVMe、Postgres 17.7):加权 p50 延迟快 2.3x、16 客户端并发吞吐高 4.7x、索引 17GB 对 23GB(小 26%);但建索引 17 分 37 秒对 8 分 55 秒(慢 1.9x)。官方解释:并行建索引分扫描/分词(并行)与合并(单线程 I/O 密集)两阶段,该规模下合并阶段占主导,而 ParadeDB 基于 Tantivy 后端、合并策略不同。
五、评测方法本身的偏向
读这份基准时需要保留三点怀疑:第一,对比对象只有 ParadeDB,没有与 Elasticsearch、Meilisearch、原生 tsvector 同场对比,“3.1x”是相对 ParadeDB 的倍数,不是相对全行业;第二,基准由项目方自测,硬件、参数、查询集都由自己选择,优化 PR(#231、#244、#249、#250、#253、#274)也都是为自家路径服务;第三,v1 与 v2 两组实验硬件、配置不同,官方明确写明”两组数字不可直接比较”。因此这些数字适合用来判断”方向是否领先”,不宜直接当作生产容量规划依据。
六、适用与不适用场景
适合:
- 已重度使用 Postgres、不想为搜索单独维护 ES/Meilisearch 集群的中小团队;
- 站内搜索、商品目录、文档检索等中等规模语料(百万至千万级文档);
- 希望事务、权限、备份都留在 Postgres 体系内的合规场景。
不适合:
- 需要海量分片集群、多租户隔离、复杂聚合分面(facet)的大型搜索平台;
- 强依赖短语查询且要求原生位置索引的场景(见下节);
- 对建索引速度敏感的超大规模冷数据批量入库。
七、客观分析:优势与局限
优势:
- 零外部组件:搜索能力收进 Postgres,少一套集群、少一份双写同步;
- SQL 原生体验:建索引、过滤、排序、事务都在熟悉的 SQL 里,学习成本低;
- 短查询延迟优势明显:1–3 词的导航型查询在自测中差距最大(1 token 快约 27x);
- 工程完成度高:表达式/部分/分区索引、并行构建、压缩段、监控视图、升级文档齐备,README 版本历史已到 v1.5.0,早期周报快照中的 v0.1.1-dev 预发布状态已被越过。
局限与官方口径(必须如实写出):
- 不存词项位置 → 短语能力受限:官方基准页明确说明,pg_textsearch 不存储 term positions,因此无法像 ParadeDB 那样支持
"quick brown fox"式原生短语查询;索引体积小 19%–26% 主要来自这个特性取舍,“不是压缩优势”,官方原话称之为 feature tradeoff。 - 建索引更慢:两次基准中构建耗时均为 ParadeDB 的 1.7–1.9 倍,大语料下单线程合并阶段是瓶颈。
- RLS 语料统计泄漏:BM25 语料统计包含所有被 RLS 隐藏的行,已知某词项的用户可推断受保护行的词频信息(官方类比 Elastic 同类安全限制),可用
pg_textsearch.allow_rls=off拒绝在 RLS 表上建索引。 - 分区表跨分区分数不可比:各分区 IDF 尺度不同,跨分区排名需逐分区查询。
- 文本边界限制:超过 2047 字节的 lexeme 被忽略(影响 base64、长 URL);超过 256KB 的文档按空白/多字节边界切分后再合并词频。
- 后台压缩依赖外部扩展:
background压缩模式依赖 pg_durable 0.2.8+ 且须同库安装,否则只能用inline或manual。 - 基准为自测单次运行:官方标注约 10% 波动,且只对比 ParadeDB。
八、它意味着什么
pg_textsearch 代表了 Postgres 生态近年一条清晰的路线:把向量(pgvector)、全文、时序、湖仓等能力逐个收进内核,让”一个数据库扛下应用”对中小项目重新变得可行。它不会取代 Elasticsearch 在大规模、多租户、复杂分面场景的地位,但对”已经在用 Postgres、搜索量中等、不想养第二套基础设施”的团队,这是一个值得放进技术选型清单的候选。建议先在测试环境用自己的真实语料与查询集复跑基准,再决定是否替换现有外挂搜索。