walgit:把 Git 服务器做成对象存储前面的一个二进制
阅读时间: 大约 10 分钟
walgit:把 Git 服务器做成对象存储前面的一个二进制
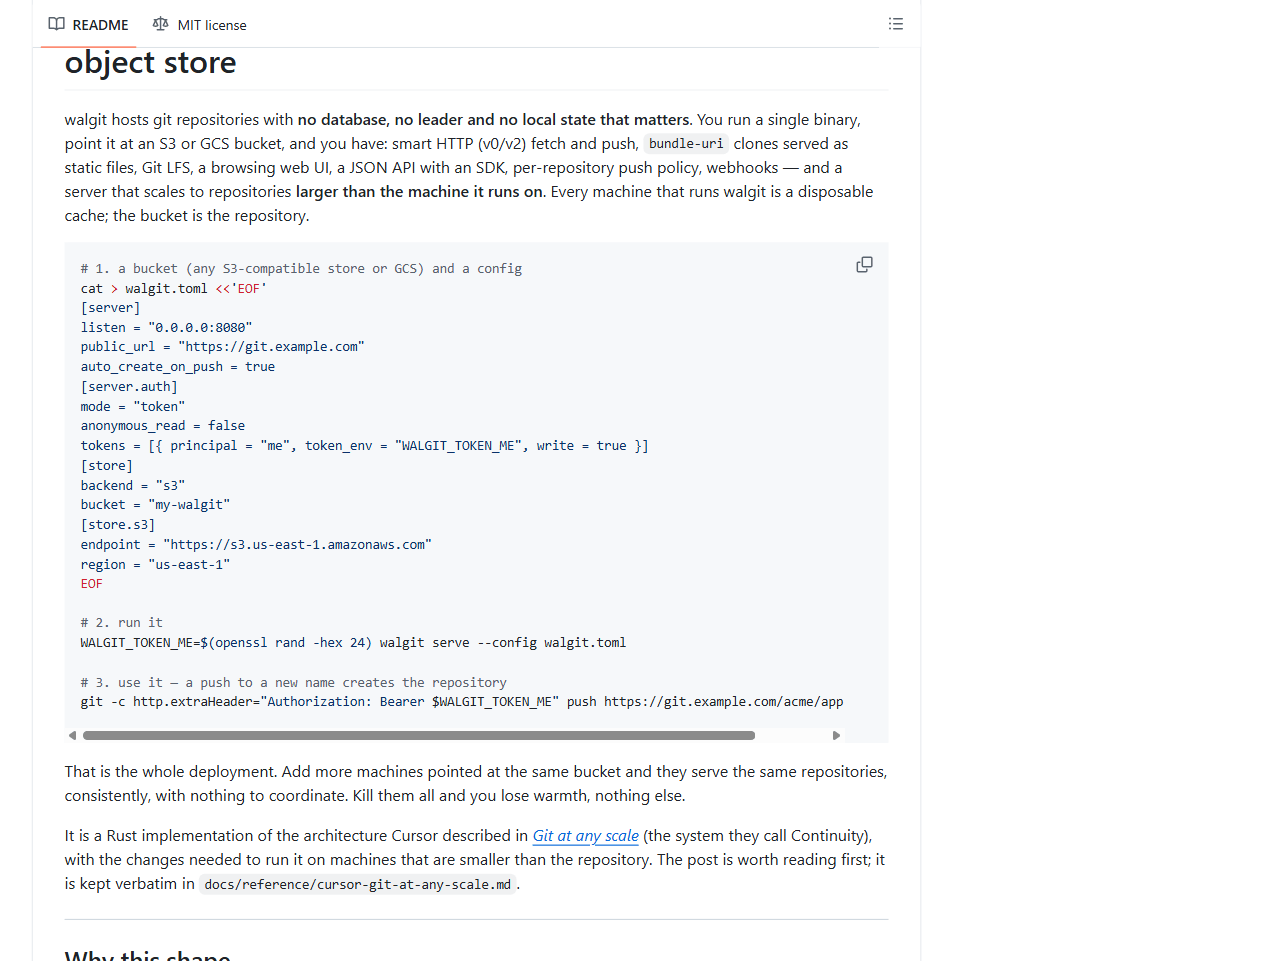
walgit(仓库名 walgithub,作者 rgodha24)是一个用 Rust 写的 Git 服务器:没有数据库、没有 leader、没有任何重要的本地状态。你跑一个二进制、把它指向一个 S3 或 GCS 桶,就得到 smart HTTP(v0/v2)的 fetch/push、作为静态文件分发的 bundle-uri 克隆、Git LFS、可浏览的 Web UI、带 SDK 的 JSON API、逐仓库推送策略和 webhook——而且服务器能服务比自身磁盘更大的仓库。官方一句话总结:“每一台跑 walgit 的机器都是可丢弃的缓存,桶才是仓库。” MIT 协议开源。
一、为什么要这样设计:Git 的 packfile 困局
Git 本身是分布式的,但恰恰因为分布式,托管它很痛苦,根子在 packfile:仓库里的一切被压成大二进制包,布局是为”省空间”而非”顺序读”优化的,每个 git 操作都是对 GB 级文件的随机游走。笔记本上有页缓存还好,放到网络文件系统(NFS)上就是灾难——这也是”直接把仓库放 NFS”在所有大型托管方都失败的原因。
GitHub 那套活下来的方案(Spokes)是把真实仓库放在本地 NVMe 上让上游 git 干活,再在 packfile 级别做强一致复制,代价是跨固定副本集的三阶段提交、一张”仓库↔机器”映射表的数据库,以及一群”宠物”服务器。
Cursor 在技术博客 Git at any scale 里提出的 Continuity 架构换了个经济学视角:把对象存储里的 write-ahead log 当作事实来源,把磁盘上的仓库都变成缓存。walgit 就是这套架构的开源 Rust 实现,并补上了”机器比仓库小也能跑”所需的改动。
二、核心机制:WAL 即仓库,CAS 即共识
walgit 把仓库表示成桶里的一组对象,路径在 repos/<owner>/<repo>/ 下:
manifest.pb:极小,用 compare-and-swap 重写——记录 head 序号、存活 pack 集合、checkpoint 指针、设置,它是整个系统的”线性化点”;log/<seq>.pb:不可变日志条目(PUSH / COMPACT / CHECKPOINT / SETTINGS);wal/<checksum>.pack|.idx|...:内容寻址的不可变 pack 及其附属文件;checkpoints/、bundles/、leases/、policy.json、lfs/objects/、events/cursor.json。
一次 push:receive-pack 先在临时目录 git index-pack 索引 pack、校验连通性与策略,并行上传 pack ∥ idx ∥ log entry,最后 CAS 写 manifest。这个 CAS 就是共识——没有选举、没有 quorum、没有 primary;任何实例都能接收 push,两个并发实例不可能都赢。撞上 412(并发冲突)就重读 manifest、按每个 ref 的旧值重新校验再重试;同一实例上的并发 push 被组提交进一次 CAS。客户端只有在桶确认后才看到 ok。
一次 读:先对 manifest 发一个条件 GET;304 就用本地副本,200 才应用新条目。因为每次读都先和桶对账,官方宣称”没有 eventually(最终一致)“。压缩(compaction)由持有租约者做一次并”发布进日志”,副本直接下载压缩好的 pack,而不是各自重打包。
三、功能矩阵
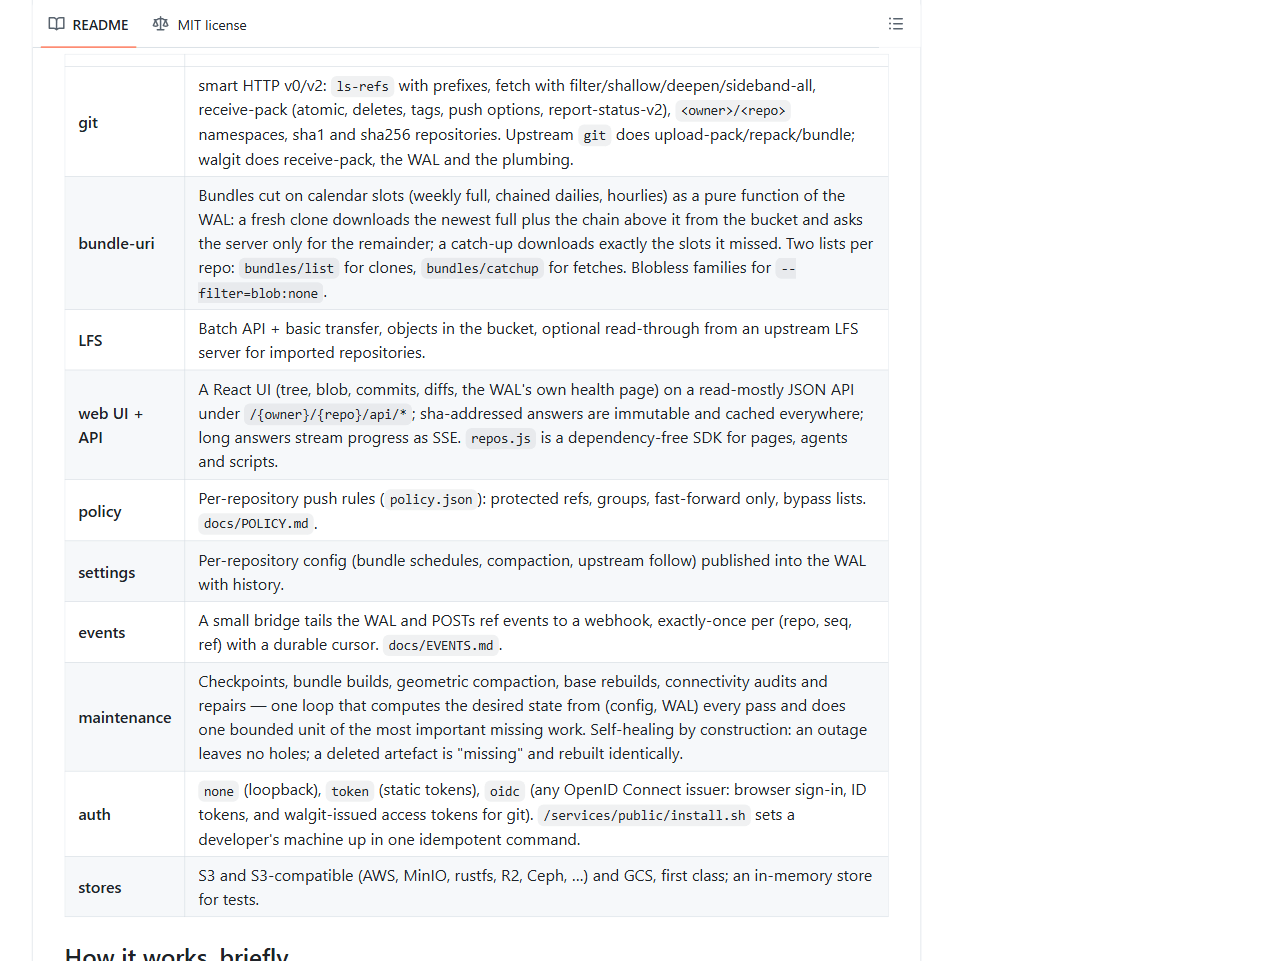
它对”机器比仓库小”这个场景做了三件专门的事:
- remote reader:对永远装不下的大 pack,用 HTTP range 请求远程读,Web UI 也能浏览超大仓库;
- history pack:commit 与 tree 留在本地,blob 留在桶里;
- bundle-uri:把新鲜克隆和增量追赶的字节量从服务器挪走——按时间槽(每周全量、链式每日、每小时)切 bundle,作为桶或 CDN 直接分发的静态文件,新克隆只下载最新全量加链式补丁,追赶只下载错过的槽。
认证支持 none(环回实验)、token(静态令牌)、oidc(接任意 OIDC 发行方:Google、Entra、Okta、Auth0、Keycloak、GitLab 等)。存储后端一等支持 S3 及兼容实现(AWS、MinIO、rustfs、R2、Ceph)与 GCS。
四、关键事实与口径
| 维度 | 官方口径 |
|---|---|
| 部署形态 | 单个二进制 + 一个 S3/GCS 桶 |
| 共识机制 | manifest 的 CAS,无选举/quorum/primary |
| 一致性 | 每次读先条件 GET 对账桶,无”最终一致” |
| 本地状态 | 仅缓存;可随意杀机器,丢的只是热度 |
| 克隆加速 | bundle-uri 静态文件,可由 CDN/Nginx 字节卸载 |
| 许可证 | MIT |
| 适用规模 | 可服务比自身磁盘更大的仓库 |
五、评测方法批判与局限
- 个人项目,没有公开性能基准。它的核心卖点是架构与成本模型(“到桶的往返次数就是预算”,见仓库
docs/ROUNDTRIPS.md),但官方没有给出”每秒并发 push / 克隆吞吐”这类实测数字。架构漂亮不等于在你的负载下更快。 - 它是 Continuity 的”学习型实现”,不是 Cursor 生产系统本身。作者把 Cursor 原文逐字收进
docs/reference/cursor-git-at-any-scale.md并明确”建议先读原文”——换句话说,这是对一篇架构博文的工程化复现,不是经过超大规模生产验证的产品。 - 功能完整但生态从零:Web UI、SDK、webhook、OIDC 都有了,但没有 issue/PR/code review 这类协作面(仓库副标题其实是”带一个 GitHub Enterprise Server facade”),想替代 GitHub 的协作体验还很远。
- 成本模型隐藏在桶费用里:本地磁盘是缓存意味着对 S3 的 GET/PUT 次数敏感,热路径成本不能随 ref 数或 pack 大小膨胀——官方把这写成”不变量”,但真要跑大 monorepo,桶请求账单需要自己算。
- 测试靠自己:提供了 fault-injection 仿真(崩溃、分区、脏读)和存储契约测试,但那是仓库自带测试,不是第三方评测。
六、优势与适用人群
优势:
- 极简部署与水平扩展:一个二进制 + 一个桶,加机器就是加缓存,无需复制集与数据库;
- 无 leader、靠 CAS 共识:并发 push 天然安全,扩缩容没有选主负担;
- 为”小机器托管大仓库”设计:range 读、history pack、bundle-uri 卸载,思路超前;
- MIT、可自托管、供应商中立:S3 兼容即可,不绑死某朵云。
适合谁:
- 想学习 Continuity/对象存储 WAL 架构的工程师——
AGENTS.md把每个设计决策、不变量、成本模型都写得很透; - **小规模自托管、想要”无数据库、无状态 Git 服务”**的团队,尤其后端已经重度使用 S3/R2;
- Agent 驱动、仓库数量与推送频率暴涨、想把克隆流量从服务器卸载到 CDN 的场景。
如果你需要的是开箱即用的代码托管协作平台(PR、Review、Actions),它还不是 GitHub/Gitea 的替代品;但作为”把 Git 托管重新建立在对象存储上”的参考实现,它值得一读。