VectorVFS:把向量嵌入直接塞进文件系统 inode 的奇技
阅读时间: 大约 9 分钟
VectorVFS:把向量嵌入直接塞进文件系统 inode 的奇技
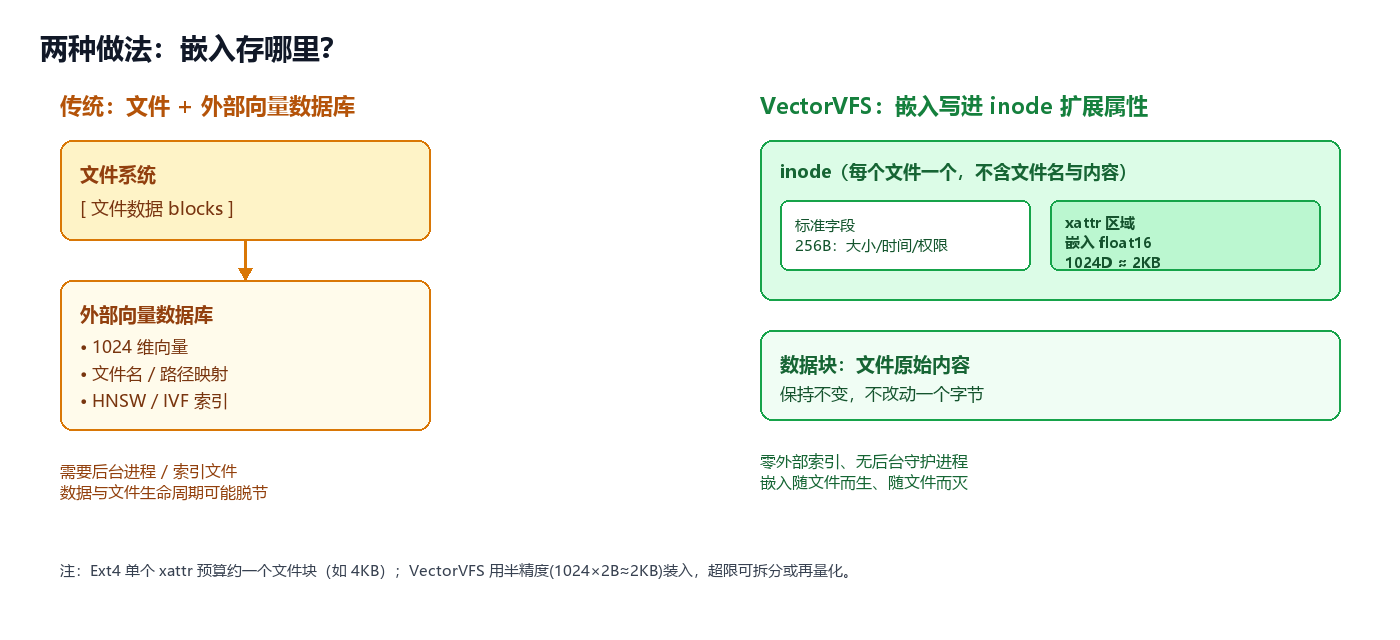
做语义搜索,标配思路是「文件归文件,向量归向量」:文件存在磁盘上,向量嵌入另存进一个向量数据库(Faiss、Qdrant、Chroma 之类),再用文件名 / 路径把两边关联起来。Christian S. Perone 开源的 VectorVFS 走了一条完全相反的路:它是一个轻量 Python 包,利用 Linux 文件系统的扩展属性(xattr),把图像的向量嵌入直接写在文件自己的 inode 里——不建外部索引、不起后台守护进程、不动文件内容一个字节。你的目录树本身,就成了一个可以语义搜索的嵌入存储。本文基于其 readthedocs 官方文档与 GitHub 仓库(Apache-2.0)做一手分析。
一、背景:向量搜索为什么非要一个独立数据库
现代语义检索几乎都要先把数据(文本、图像)编码成高维向量,再靠「向量相似度」找回内容。传统架构里,向量和原始文件是两套存储:文件留在磁盘目录,向量连同路径映射和 ANN 索引(HNSW / IVF 等)放进专门的向量数据库。这带来几个工程负担:要部署和维护一个额外服务、要保证索引与文件状态同步(文件删了、改了,索引里的旧向量怎么清理?)、要处理备份和一致性。
VectorVFS 问了一个朴素的问题:既然每个文件在文件系统里本来就有一个 inode 用来存元数据,为什么不把向量直接挂在 inode 上?
二、是什么:用 xattr 把嵌入变成文件的「元数据」
Linux 主流文件系统(Ext4、Btrfs、ZFS、XFS)都支持扩展属性,一种键值形式的额外元数据,直接存在 inode 里、而非文件的数据块中。VectorVFS 就把嵌入当成一种自定义 xattr 贴在每个文件上。这样做的好处是「同生共死」:文件被移动、删除,嵌入作为它元数据的一部分自动跟随或消失,不需要额外的垃圾回收逻辑。
用法极简,官方示例:在某个文件夹里搜含猫的图像,只需
$ vfs search cat /my_folder它会遍历目录、跳过不支持的文件、对新文件计算嵌入(或直接从文件 xattr 读已有嵌入),然后返回相似度最高的文件。-f 强制重新索引,-n 3 只看最相似的前 3 个。支持 CPU 与 GPU。
三、技术机制:1024 维半精度,塞进 4KB 的预算
这里有个关键的工程约束,也是理解 VectorVFS 的核心。Ext4 对单个扩展属性有大小限制——要求落在一个文件系统块内,通常约 4KB。一个 1024 维的 float32 向量要占 4096 字节,刚好顶满甚至超预算。VectorVFS 当前的解法是官方文档写明的:把 1024 维嵌入存成半精度(float16),1024 × 2 字节 ≈ 2KB,从容装进 inode 预留空间。如果未来维度更高或文件系统预算更紧,官方给出三条退路:把嵌入拆成多个 xattr、进一步量化压缩、或让文件系统自动把超长 xattr 溢出到外部 xattr 块。
嵌入模型方面,它目前接的是 Meta 的 Perception Encoders(PE),一个图像 / 视频视觉理解编码器。官方文档称 PE「在零样本图像任务上优于 InternVL3、Qwen2.5VL 和 SigLIP2」——但要特别注意:这句性能背书是对 PE 这个模型说的,来自 PE 自己的论文,不是 VectorVFS 这个存储工具的测试结论。VectorVFS 本身只是「算完嵌入存哪儿、怎么比相似度」的管道,它不产生任何精度数字。
四、关键数据与口径
| 维度 | 官方口径 |
|---|---|
| 存储位置 | 文件 inode 的扩展属性(xattr) |
| 支持文件系统 | Ext4、Btrfs、ZFS、XFS(Linux) |
| 当前向量规格 | 1024 维,float16 半精度(≈2KB) |
| 单 xattr 预算 | 约一个文件块,如 Ext4 4KB |
| 嵌入模型 | 仅 Meta Perception Encoders(图像) |
| 运行依赖 | Python,无外部数据库 / 守护进程,CPU/GPU 均可 |
| 协议 | Apache-2.0 |
需要强调,这是项目的第一个正式版本,官方在 Note 里坦白:「目前只支持 Perception Encoders 和图像,更多模型和数据类型正在扩充」。
五、评测方法批判:它其实没有「检索性能」可比
VectorVFS 没有公布任何召回率、延迟、QPS 数字,这不是藏私,而是由它的设计决定的:
- 相似度是暴力扫描:没有 HNSW 这类 ANN 索引,
vfs search大概率是对目录下所有文件的 xattr 向量逐个算余弦 / 点积。文件数量小(几千张图)时毫无问题;到几十万文件,每次查询都要 O(N) 全量扫描,延迟会线性增长——它从设计上就不是为大规模向量检索准备的。 - 半精度的代价:float16 省了空间,但相比 float32 有数值精度损失,对相似度排序的细微差异可能有影响。官方没有给出这个损失的实测数据。
- 「支持任意嵌入模型」是愿景:README 写着可插拔任何嵌入模型,但 Note 明确当前只接 PE、只处理图像,「Flexible embedding support」更多是设计目标而非现状。
- 增量检测未完成:官方说「正在实现高效的文件变更检测」,目前改了文件要靠
-f强制重建——意味着它还没有成熟的增量索引机制。
六、优势与局限
优势:
- 零运维:没有独立向量服务要装、要备份、要跟文件系统对账;
- 数据随文件走:嵌入与文件同生命周期,复制、移动、删除文件,元数据自动跟随;
- 概念优雅:把「语义搜索」下沉到文件系统层,命令行
vfs search就能用; - 跨文件系统便携:基于标准 xattr,Ext4/Btrfs/ZFS/XFS 都能跑。
局限:
- 仅 Linux、仅图像、仅 PE 模型:macOS/Windows 的 xattr 语义不同,当前不适用;视频 / 文本嵌入尚在路上;
- 规模天花板低:暴力扫描 + 单文件 4KB xattr 预算,决定了它是「个人 / 小相册 / 单项目」规模的玩具式工具,不是生产向量库;
- CPU 首次嵌入慢:官方自己提醒,图像库大又没有 GPU 时,首次全量嵌入会比较久;
- 变更检测不完善:暂无成熟增量索引。
七、谁该关注
如果你是个有几千上万张本地图片、想在命令行里用自然语言找图(「找那张海边日落的」)的人,或者想体验「把数据库做进文件系统」这一思路的开发者,VectorVFS 非常值得玩——它用一个 2KB 的小技巧重新定义了「索引可以长在哪」。但如果你要的是百万级向量、低延迟检索、多模态混合查询的生产系统,它显然不是那一档;它的价值在于思路示范与小众场景,而非替代 Qdrant / Milvus。