uzu:为 Apple 芯片而生的高性能本地推理引擎
阅读时间: 大约 10 分钟
uzu:为 Apple 芯片而生的高性能本地推理引擎
把大模型塞进 Mac、iPhone 这类端侧设备,最大的现实约束是:能不能充分利用 Apple 芯片的统一内存(unified memory)、Metal GPU,以及能不能让 Swift / Python / TypeScript 应用低延迟地调用它。uzu 就是冲着这个目标来的——一个用 Rust 写、面向 AI 模型的高性能推理引擎,主打「直接在你的 App 里部署 AI,零延迟、数据完全私有、无推理费用」。本文基于其 GitHub 仓库(trymirai/uzu)的一手 README 分析它的架构、平台支持与需要注意的口径。
一、它要解决的问题
云推理的代价是网络往返、数据出域与按 token 计费。对很多端侧应用(特别是 iOS / macOS 上的隐私敏感场景),把模型跑在设备本地是更优解。但本地推理引擎在 Apple 平台上长期被 llama.cpp 这类通用方案主导,uzU 想做的是:从一开始就为 Apple 芯片的统一内存与 Metal 后端做深度优化,同时提供一套简单高层 API 与多语言绑定,让上层 App 不必关心底层 kernel。
二、架构:Rust 核心 + 多语言绑定
uzu 是一个原生 Rust crate,通过成熟的 FFI 方案向外暴露绑定:
- Swift:via uniffi-rs(便于 iOS / macOS 应用直接调用);
- Python:via pyo3;
- TypeScript:via napi-rs。
这种「Rust 核心 + 多语言 binding」的结构是现在高性能本地库的主流做法——性能与可维护性在 Rust 侧,上层语言只做薄封装。代码语言占比也印证了这一点:Rust 71.1%、Swift 11%、Metal 6.4%、Python 5.1%。
官方列出的关键特性包括:简单高层 API、统一模型配置(便于新增模型支持)、可追溯的计算(traceable computations)——用来保证与「权威实现(source-of-truth)」结果一致、以及充分利用 Apple 设备的统一内存。「可追溯」这一点对推理引擎很重要:端侧 kernel 高度优化后,容易在数值上与参考实现产生偏差,uzu 把「能对得上正确性」作为一等目标。
三、后端与目标平台
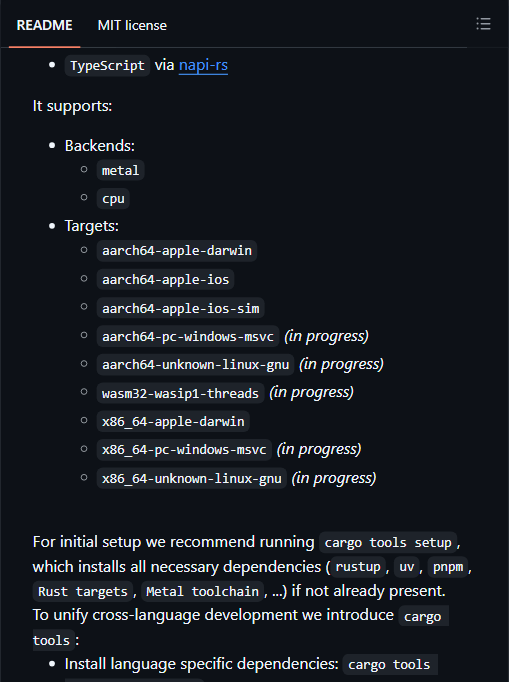
README 明确列出的支持矩阵:
| 维度 | 支持情况 |
|---|---|
| 后端(Backends) | metal、cpu |
| 已就绪目标 | aarch64-apple-darwin、aarch64-apple-ios、aarch64-apple-ios-sim、x86_64-apple-darwin |
| 进行中(in progress) | aarch64-windows-msvc、aarch64-linux-gnu、x86_64-windows-msvc、x86_64-linux-gnu、wasm32-wasip1-threads |
这说明 uzU 当前是Apple-first:macOS(Apple Silicon 与 Intel)与 iOS(含模拟器)是一等公民,Windows、Linux 与 Wasm 仍在开发中。结合 Koala 提到的「同时支持 GPU kernels 或 MPSGraph 的混合架构」,其优化重点在 Apple 生态内部的性能榨取。
四、用法:从 CLI 到 OpenAI 兼容服务器
uzu 提供了多层使用方式:
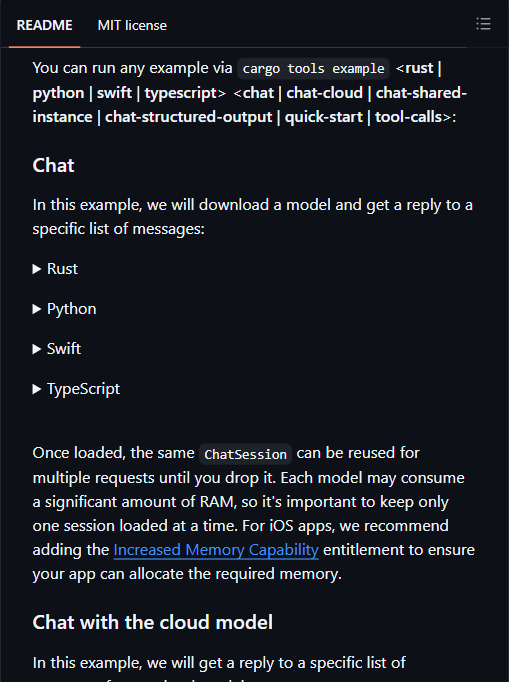
- 多语言示例:
cargo tools example <rust|python|swift|typescript> <chat|tool-calls|...>;加载后的同一个ChatSession可复用多轮请求(但官方提醒:单个模型占内存很大,同一时间只保留一个会话); - iOS 注意事项:官方建议给 iOS App 加上 Increased Memory Capability entitlement,以确保能分配推理所需内存;
- 结构化输出:用 Grammar 手动指定 JSON schema,约束模型输出合法字段;
- Tool calls:支持外部工具调用;
- CLI 模式:
cargo run --release -p cli,可浏览、下载、交互模型; - OpenAI 兼容 HTTP 服务器:
cargo run --release -p cli -- server --model ...,默认监听127.0.0.1:8000,暴露/v1/chat/completions(支持流式、temperature、top_p、top_k、max_tokens)与/v1/models——这意味着可以像接 OpenAI 一样接本地 uzU。
五、模型格式与口径:自有格式 +「优于 llama.cpp」要验证
有两点需要在选型时特别留意:
- uzu 使用自己的模型格式,而不是通用的 GGUF。你需要用官方配套的转换工具 lalamo(trymirai/lalamo)自行导出模型,例如
uv run lalamo convert meta-llama/Llama-3.2-1B-Instruct。这带来格式可控、可针对 Apple 优化的好处,但也意味着生态锁定:不能直接把 HF 上的 GGUF 文件丢给 uzu 跑,必须走转换流程。 - 「比 llama.cpp 更胜一筹」是 Koala 项目库的评测结论,而不是 uzu README 里的公开基准。README 给了 bench 命令(
cli bench {MODEL_PATH} {TASK_PATH} {OUTPUT_PATH}),却没有在页面上公布具体的 tokens/s 对比表。因此「更快」目前属于第三方 / 宣传口径,落地前最好用 uzu 自带的 bench 在自己的目标设备、目标模型上实测一遍。
项目成熟度方面:截至快照时 uzu 已发 25 个 Release(最新 0.5.30)、24 位贡献者、提交活跃到数小时内,采用 MIT 许可——属于一个仍在快速迭代、但已经有相当积累的早期项目。
六、适用与不适用
适合:
- 想在 macOS / iOS 应用里本地跑小模型、对延迟与隐私敏感的团队;
- 需要 Swift 绑定、且希望一个 Rust 核心同时给 Python / TS 用的多端项目;
- 想要一个本地 OpenAI 兼容服务器(127.0.0.1)做开发与原型的场景。
不适用:
- 主要目标是 Windows / Linux 服务器部署——这些平台仍标记为 in progress;
- 希望直接复用海量 GGUF 模型、不愿做格式转换的用户;
- 把「uzU 一定比 llama.cpp 快」当作既定事实直接押注——需自行 bench 验证。
七、客观分析:优势与局限
优势: Apple 统一内存与 Metal 后端的深度优化;Rust 核心 + Swift/Python/TS 绑定覆盖端侧多语言;可追溯计算保证正确性;OpenAI 兼容本地服务器降低接入成本;MIT 许可、迭代活跃。
局限: 自有模型格式(依赖 lalamo 转换)带来生态成本;Windows / Linux / Wasm 尚未完成;「优于 llama.cpp」缺乏 README 公开基准;0.5.x 早期版本 API 可能变动;iOS 推理对内存要求高,需额外 entitlement。
八、它意味着什么
uzU 代表了「端侧推理引擎」从「通用移植」走向「平台原生优化」的趋势:不再追求跨平台面面俱到,而是先把 Apple 芯片的统一内存与 Metal 用到极致,再用 Swift 绑定把体验送进 iOS / macOS 应用。对苹果生态的开发者,它是一个比 llama.cpp 更「贴身」的选择;但在把它用于生产前,务必自行 bench、并接受自有模型格式的转换成本。