Uncloud:不要 Kubernetes,用 WireGuard 网格把普通服务器组成生产集群
阅读时间: 大约 11 分钟
Uncloud:不要 Kubernetes,用 WireGuard 网格把普通服务器组成生产集群
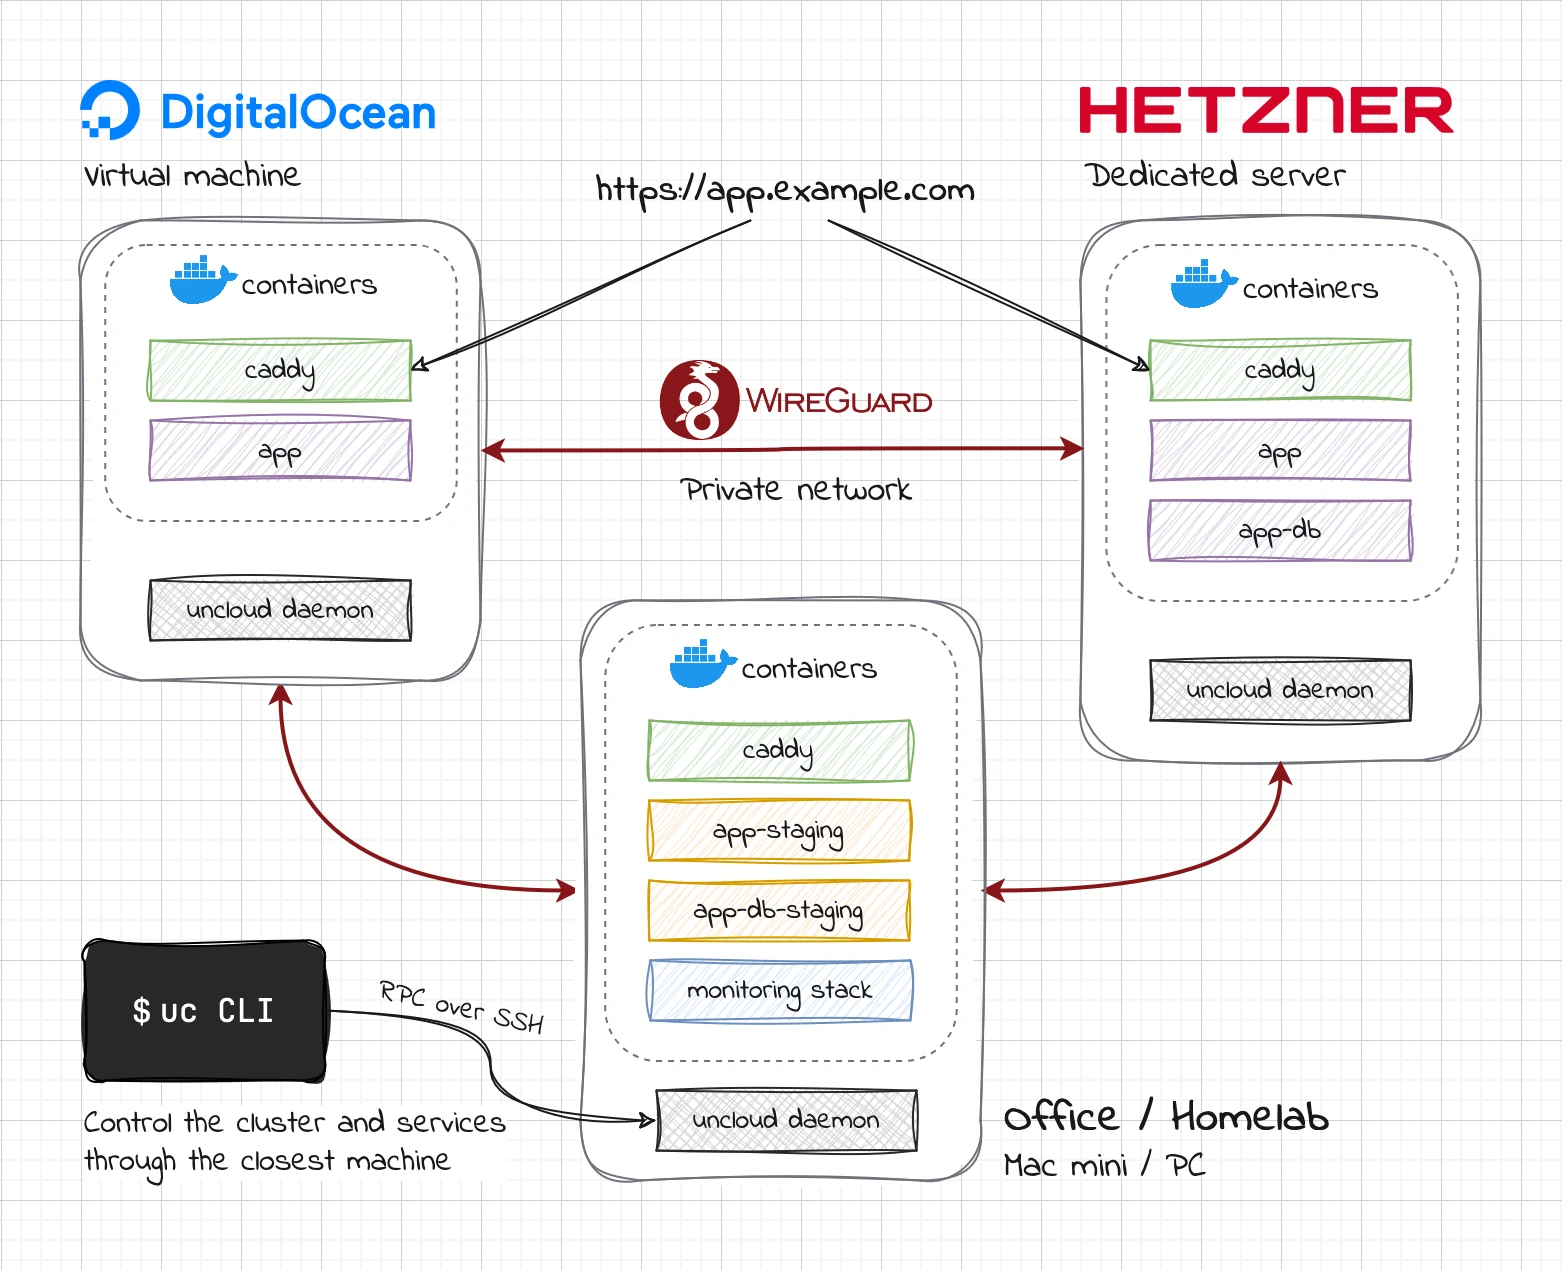
Kubernetes 提供了 Google 级别的编排能力,也带来了控制面、etcd、Raft 选举、复杂 YAML 与一整套需要专职运维消化的概念。Uncloud 走了另一条路:不设中央控制面,把任意云 VM、裸金属甚至家里的 Mac mini 通过 WireGuard 组成一个对等网格网络,用熟悉的 Docker Compose 定义服务,一条 uc deploy 完成零停机滚动更新、自动 HTTPS 与跨机扩容。官网自我定位是”Kubernetes、Swarm、Nomad、Kamal 之外的更简单替代”。本文基于官网、官方 GitHub 仓库(psviderski/uncloud,Apache-2.0,调研时约 5.5k stars)与仓库内设计文档做客观分析。
一、背景:K8s 复杂度反弹与 PaaS 的中间地带
设计文档(misc/design.md)把目标用户讲得很直白:大多数人并不跑 Google 规模的负载,却被迫承担 Kubernetes 的运维复杂度;而 Coolify、Dokploy 这类自托管 PaaS 大多跑单机或 Docker Swarm,缺乏真正的多主机能力。Uncloud 想填补的中间地带是:拥有自己的基础设施与数据,却保留 Heroku 式的顺滑体验——从一台 $5 VPS 到一台闲置 Mac mini 到一机架裸金属都能纳入同一套工作流。
二、是什么:网络而非”集群”
Uncloud 刻意用”机器网络(network of machines)“替代”集群(cluster)“这个词,设计上类比 Tailscale:把机器逐台加入一个安全网络即可互通,而不是先搭一个高可用控制面。核心组件与用法:
- WireGuard 扁平网格:每台机器加入时分配
10.210.X.0/24子网,整个网格为10.210.0.0/16,容器拿到独立网格地址,跨机通信无需 NAT;对等发现与 NAT 穿越借鉴了 Talos KubeSpan 的思路; - 标准 Docker Compose:
compose.yaml即服务定义,不学习新 DSL;x-ports扩展字段声明对外发布与协议(如app.example.com:8080/https); - Caddy 入口 + 自动 HTTPS:内置 Caddy 反向代理,证书由 Let’s Encrypt 自动签发与续期,TLS 证书与 ACME 挑战令牌在集群内共享;
- 无注册中心的镜像分发:借助同作者的 Unregistry,镜像直接从本地推送到目标机器,只传缺失层,不需要搭建或付费 Docker Registry;
- Terraform 式变更计划:
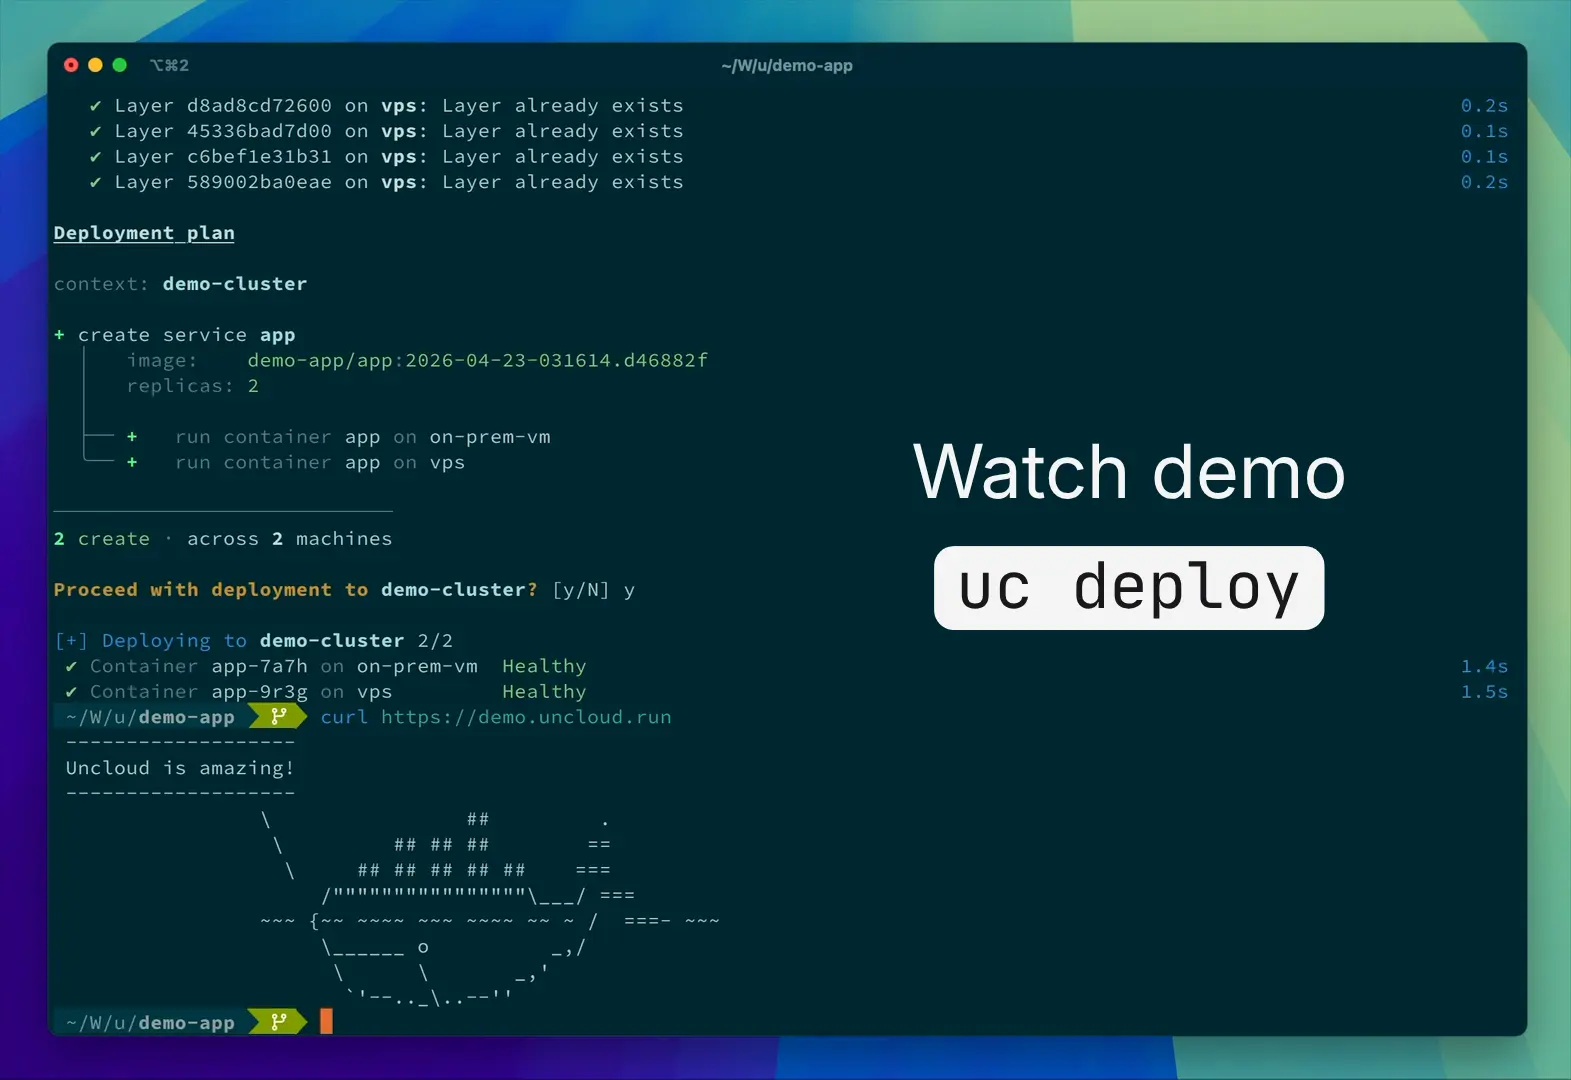
uc deploy先输出”将替换哪些容器、分布在哪几台机器”的 plan,确认后按 start-first 方式健康检查通过再旧换新,实现零停机。
三、技术机制:对等状态同步与命令式编排
架构上没有中央控制面,每台机器运行 uncloudd 守护进程(systemd 管理),各自保存一份集群完整副本,通过对等(peer-to-peer)通信保持同步。设计文档披露的技术路线是 CRDT(无冲突复制数据类型)+ gossip 协议:任何机器可独立修改自己的状态副本,CRDT 自动消解并发冲突,最终收敛到同一状态;网络分区时各分区可独立管理本区服务,分区愈合后再收敛。作者明确选择 CAP 中的 AP(可用性 + 分区容忍)而非 CA(一致性 + 可用性)。
编排取命令式(imperative)优先:用户命令直接调用目标机器执行并同步返回错误,而不是写一份期望状态等待控制器调和(reconcile);只有 DNS、反向代理配置这类异步事项才按状态变更更新。设计文档同时坦承,实验性 CRDT 键值存储(BadgerDB 持久化 + Serf gossip)“实现非常低效,收敛目前相当慢”,当前可行的假设是”小规模部署状态 churn 很小,最终一致可接受”。
四、关键事实与可核对数字
| 维度 | Uncloud 的做法(官方口径) |
|---|---|
| 网格网段 | 10.210.0.0/16,每机 /24(设计文档) |
| 控制面 / 仲裁 | 无,无 Raft quorum,任意子集可继续工作 |
| 镜像分发 | Unregistry,仅传缺失层,无外部 Registry |
| TLS | Caddy + Let’s Encrypt,证书集群内共享 |
| 部署模型 | Compose 文件,plan 预览后 start-first 滚动更新 + 健康检查 |
| 重调度 | 不自动迁移容器,机器故障后由用户决定替换与重部署 |
| 官方托管件 | Uncloud Hub(Web UI + 可观测栈)为可选 early access,非必需 |
外部背书方面,官网引用了 CoreDNS 作者、前 Google SRE、奈梅亨拉德堡大学的 Miek Gieben 的说法:学校正把 300+ 个网站迁移到约十二台 Uncloud 机器上,每位站点所有者各自管理自己的机器。GitHub 仓库调研时约 5.5k stars,Apache-2.0 协议。
五、与 Swarm / Nomad / K8s 的对比口径
官网 FAQ 的对比需要分开看:它称 Docker Swarm 多年处于维护模式、需要 Raft 管理器仲裁;Nomad 被 IBM 收购后不再是自由软件;K8s 臃肿。这些是作者立场,而非中立测评。Uncloud 的对比基线是”小型团队自己的几台机器”,不与大规模多 AZ、自动扩缩容、滚动批处理等企业能力对标。
六、Hub:可选的可观测层
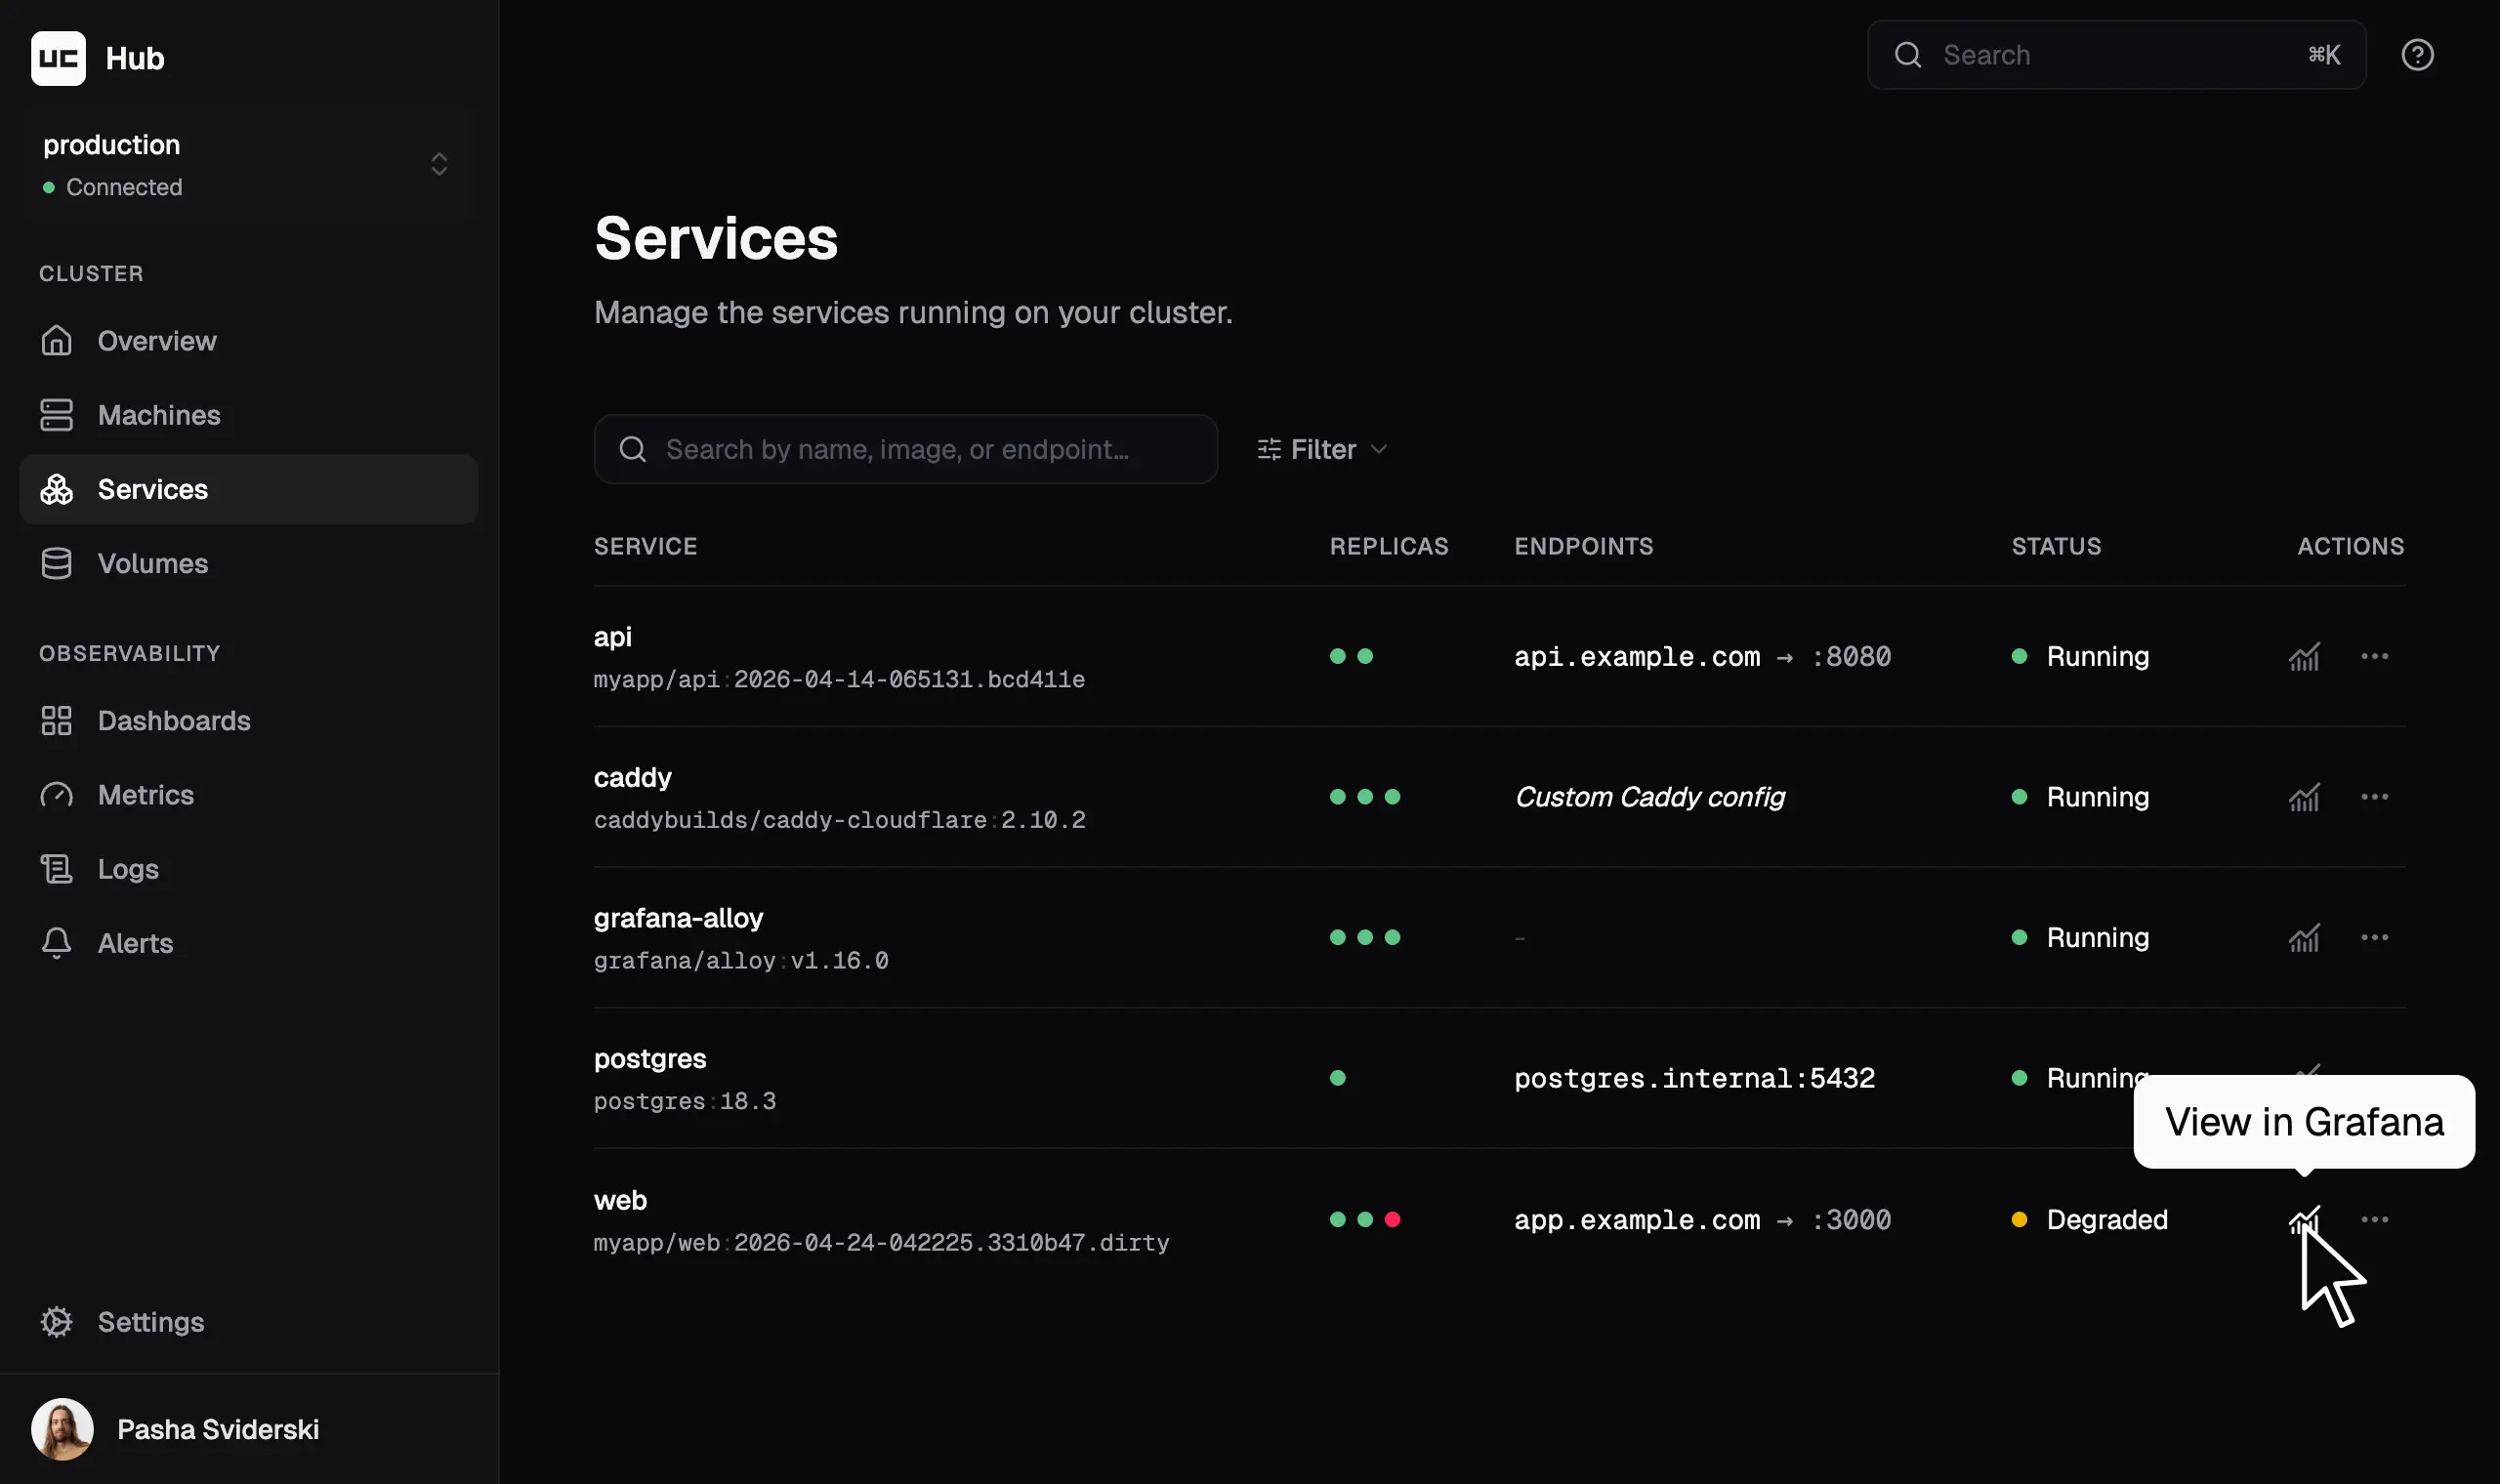
Hub 是一个托管的仪表盘与可观测栈(指标、日志、告警,底层接 Grafana/Alloy),官网明确:不用 Hub,Uncloud 开源本体依然完整可用,Hub 只是在开源 CLI 之上叠加 Web UI,避免用户自建监控。当前处于 early access,不是开源核心的一部分。
七、客观分析:优势与局限
优势:
- 概念极简:SSH 即可接入,无控制面、无 etcd、无注册中心,排障工具就是 Docker、WireGuard、Caddy 这些熟悉件;
- 开发体验零迁移:本地 Compose 直接上生产,CI/CD 里跑
uc deploy即可,无需迁移流水线; - 跨云混合组网:云 VM、裸金属、家用硬件混编,NAT 后也能打通;
- 成本友好:不依赖托管控制面与镜像仓库,适合小团队按项目/客户各跑一个网络。
局限与官方口径(必须如实写出):
- 不自动重调度:机器宕机后其余副本继续服务,但容器不会自动飘到健康机器,官方刻意如此——“可预测、无聊的基础设施”,换机器与重部署由人决定;这与 K8s 自愈是明确取舍;
- 自动回滚尚未完成:README 标注”失败自动回滚 coming soon”,当前滚动更新失败需人工介入;
- 最终一致且收敛速度未经验证:设计文档自陈实验性 CRDT 实现低效、收敛慢,AP 取舍下”收敛到的同一状态未必符合每个用户本意”,大规模、高 churn 场景未被验证;
- 无声明式调和与自动扩缩容:命令式模型下没有控制器持续对齐期望状态,HPA 式自动扩容不存在;
- 定位中小规模:设计假设”小部署状态变更少”,多机房、跨地域大规模集群的一致性与故障排查仍需自行验证,这也是 Koala 点评中提出的疑问;
- Hub 非开源核心:托管可观测层是商业/早期访问件,自监控仍需自建。
八、它意味着什么
Uncloud 是”去 K8s 化”思潮里工具链派的代表:不发明新抽象,只把 Docker、WireGuard、Caddy、gossip 这些成熟零件粘合成一个 Heroku 式工作流。它适合已经用 Compose 开发、只想把两三台到十几台机器变成可部署网络的小团队与独立开发者;当业务走向多地域、数十副本、自动弹性与企业级治理时,仍应回到 K8s 或托管 PaaS 的语境里选型。