TurboFieldfare:在 8GB Mac 上用约 2GB 内存跑 Gemma 4 26B
阅读时间: 大约 8 分钟
TurboFieldfare:在 8GB Mac 上用约 2GB 内存跑 Gemma 4 26B
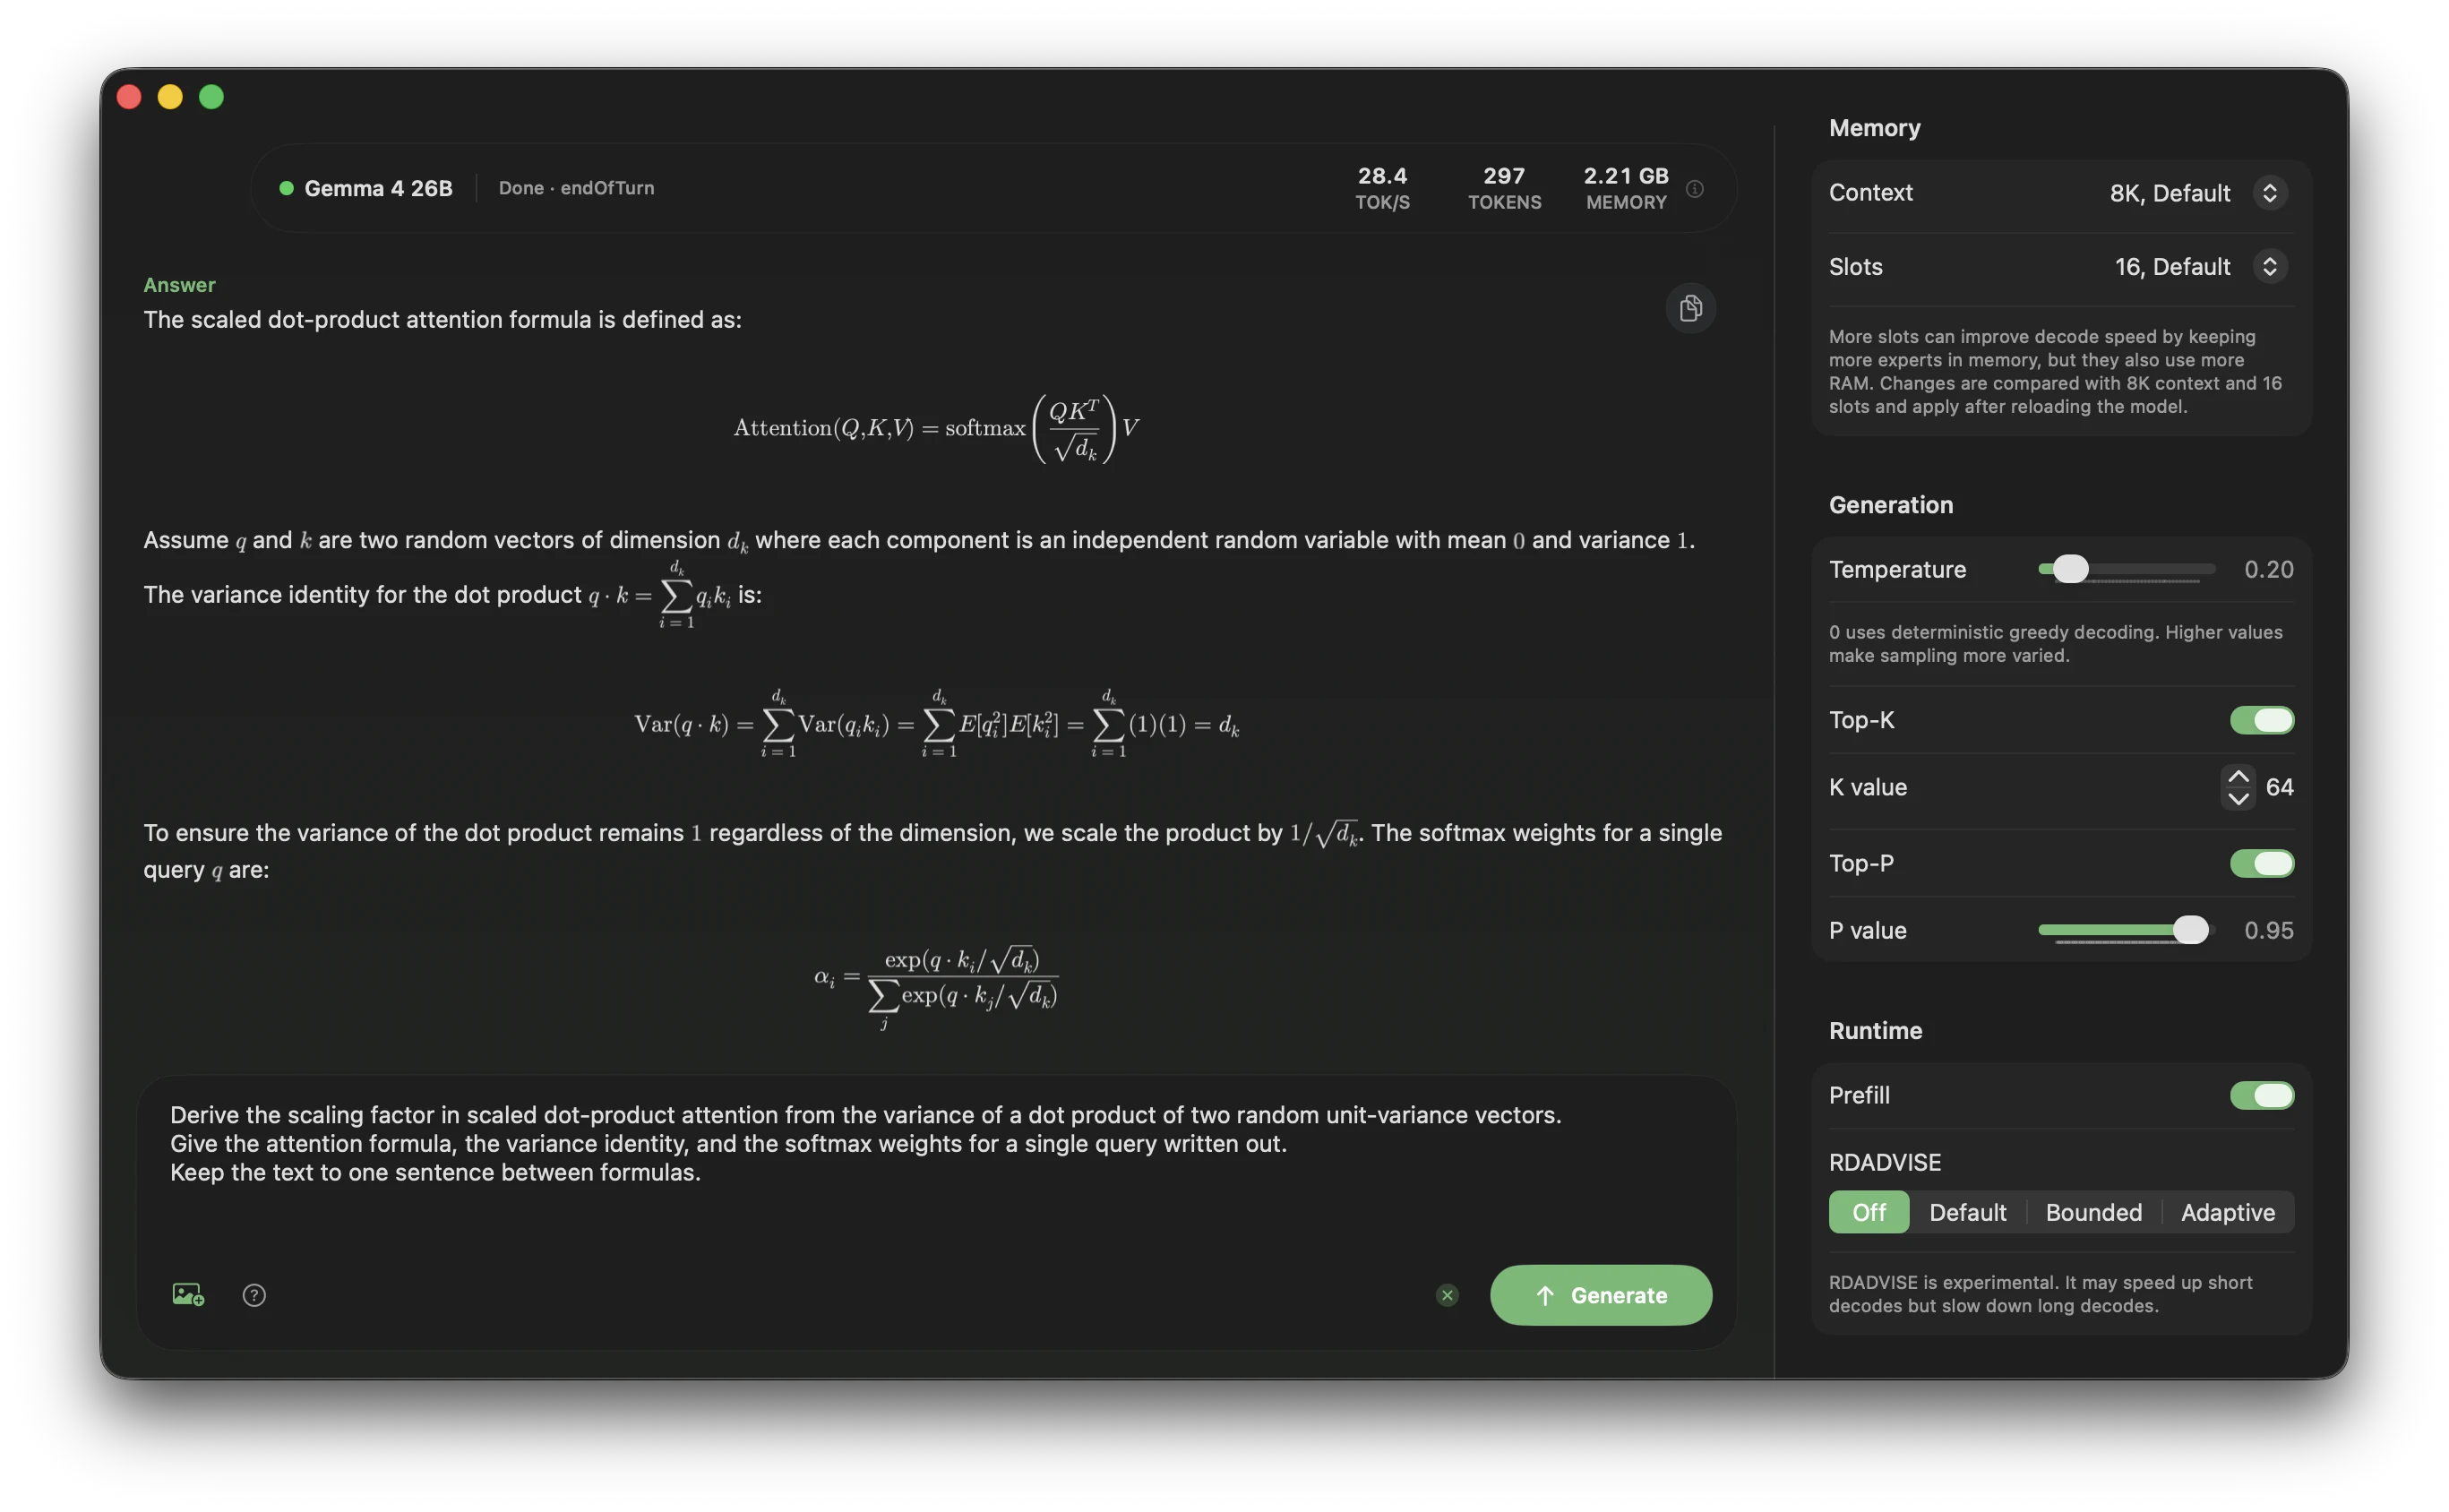
“内存变贵了,所以我给一个 260 亿参数的模型算了一笔约 2GB 的预算。“这是独立开发者 Andrey Mikhaylov 在 TurboFieldfare README 开篇写的话。这个用 Swift 6.2 + Metal 4 写的推理引擎,目标是让 Gemma 4 的 26B-A4B MoE 模型在 8GB 统一内存的 Mac 上跑起来。本文核对它的机制、实测数字,以及一个常被忽略的前提:这套玩法几乎是为 Apple Silicon 量身定做的。
一、背景:MoE 的”小激活”被端侧吃到了什么程度
Gemma 4 26B-A4B 总参数 26B,但每个 token 只激活约 3.88B。和 Colibrì 跑 744B 是同一个思路——MoE 的稀疏性意味着不需要把整个模型塞进内存。区别在于规模:Colibrì 是极限研究平台,TurboFieldfare 是一个模型专用、面向普通 Mac 用户的成品。
它不绕 MLX 或 llama.cpp,而是从零写了一套 Swift + Metal 运行时。常驻内存的只有两部分:约 1.35GB 的共享核心(embedding、注意力、共享专家)加 FP16 KV 缓存;其余被路由到的专家权重从 SSD 按需流式读入。
二、技术机制:常驻核心 + 专家流式
官方给出的”一览”数据:
| 项 | 值 |
|---|---|
| 模型 | Gemma 4 26B-A4B IT,总 26B,每 token 激活约 3.88B |
| 权重 | MLX affine 4-bit(group 64);8-bit router;共享与路由专家均 4-bit |
| 内存 | 约 2GB 权重 + 4K KV 缓存 |
| 存储 | 文本模型约 14.3GB + 可选视觉包约 1.1GB |
| 硬件 | Apple Silicon Mac,8GB 内存即可 |
| 平台 | macOS 26、Metal 4、Swift 6.2,仅 arm64 |
每一层的执行流程:Metal 用常驻权重算注意力和路由器;CPU 拿路由器给出的 top-8 专家 ID,对照该层 16 槽位的 LFU 专家缓存做规划,缺失的用有界并行 pread 读进 Metal 可见缓冲;读盘的同时 Metal 先算常驻的共享专家分支,最后把两路结果合并。Prompt prefill 按最多 128 token 分块,让一次拉取的专家能服务多行。
安装器也贯彻同一哲学:从不落地完整 checkpoint,而是按 Hugging Face 范围请求边下边重打包成 .gturbo 布局,约 15GB 传输后落成 14.3GB,全程内存有界。
三、关键数据:到底多快
| 硬件 | 实测解码速度 |
|---|---|
| 8GB M2 MacBook Air | 5.1–6.3 tok/s |
| 24GB M5 Pro | 31–35 tok/s |
上面那张应用截图里,状态栏显示 28.4 tok/s、297 tokens、2.21 GB 内存——与官方在 M 系列上的量级吻合。作为参照:一个 14.3GB 的 26B 模型,在只有 8GB 统一内存的机器上,不仅跑起来了,还能以 5–6 tok/s 做对话,这在三年前是不可想象的。苹果的统一内存(RAM 即 VRAM)与高速 NVMe 是这套方案成立的物理基础。
四、口径偏差与局限
官方把话说得很实在,值得逐条保留:
- “参考值,不是性能上限”:官方原话——提示词长度、生成长度、页缓存状态、硬件都影响吞吐。截图里的 28.4 tok/s 是特定条件下的数字,别当保证值。
- 强依赖 SSD 速度:专家从 NVMe 流式读取,盘慢则一切慢。周报点评也指出:换到普通 PC 上收益会明显缩水——苹果统一内存 + 高速 SSD 才是这片土壤。
- 只能跑这一个模型:它是 model-specific 的,当前范围就是 Gemma 4 26B-A4B 指令版,不是通用推理引擎。
- 工具调用不执行:Mac 应用/CLI 不暴露也不执行工具;loopback OpenAI 兼容服务器(
127.0.0.1:8080/v1)接受工具声明、返回模型产生的工具调用,但必须由客户端自己授权和执行,且服务器无远程认证、无 TLS,官方要求只跑回环。 - 无音频/视频:视觉靠单独安装的 1.1GB 视觉塔(需 M2 及以上;纯文本 M1 即可),音视频明确不支持。
- 采样默认会胡言:默认 temperature 0.2,官方提醒”模型仍可能重复自己或答错,重要结果请自行核对”。
- 生态单人维护:作者是一位 iOS/Metal 工程师,仓库仅 1 位贡献者(21 个 release),权重本身遵循 Google/Gemma 条款,项目与 Google 无关。
它还附带一份记录了 103 条审计过的实验结果的文档,包括”哪些看起来可行但在更强验证下翻车”的条目——这种把失败实验也公开的做法,在个人项目里不多见。
五、适用与不适用
适合:只有 8GB / 16GB 低配 Mac、想本地跑一个 26B 级 MoE 做离线问答/写作的用户;需要一个 OpenAI 兼容本地端点接脚本、且数据不出本机的开发者。
不适合:Windows/Linux PC 用户(仅 arm64 Apple Silicon);需要多模型、工具自动执行、生产级 SLA 的团队;对速度敏感(8GB M2 上 5–6 tok/s 仅够交互,不够高吞吐)。
六、它意味着什么
TurboFieldfare 和 Colibrì 是同一枚硬币的两面:都在证明”MoE + 专家从存储流式加载”能把大模型塞进消费设备。区别在于 Colibrì 是纯 C 的开放研究平台(笔记本 0.05 tok/s,极客玩具),而 TurboFieldfare 把同一思想打磨成了一个普通 Mac 用户能装、能点、能对话的原生应用,并把常驻内存压到 2GB。它的启示是:当 SSD 带宽足够、当 MoE 的专家分布足够有结构,“大模型端侧化”拼的不再是谁的显存大,而是谁更会把权重在存储层级之间调度。对低配 Mac 用户而言,这是目前门槛最低的”本地 26B”方案之一。