TranslateGemma:Google 开源的翻译专用模型,12B 打赢 27B 基线
阅读时间: 大约 8 分钟
TranslateGemma:Google 开源的翻译专用模型,12B 打赢 27B 基线
2026 年 1 月 15 日,Google 在官方博客发布 TranslateGemma——一套基于 Gemma 3 的开源翻译模型,提供 4B、12B、27B 三档参数规模,覆盖 55 种语言。文章作者为 Staff Research Scientist David Vilar 与产品经理 Kat Black。官方的核心叙事是:通过把 Gemini 大模型的知识蒸馏进紧凑的开源模型,实现”小参数、高翻译质量”。模型可在 Kaggle、Hugging Face 下载,并部署到 Vertex AI。
一、核心卖点:12B 用不到一半参数打赢 27B 基线
官方称最值得注意的结论是效率:经过专门训练流程后,12B 的 TranslateGemma 在 WMT24++ 基准上、用 MetricX 度量,超过了 Gemma 3 27B 基线。对开发者的直接意义是:用不到一半的参数量即可获得高保真翻译,从而在相同硬件上获得更高吞吐、更低延迟。类似地,官方称 4B 模型可与更大的 12B 基线相匹敌,适合移动端推理。
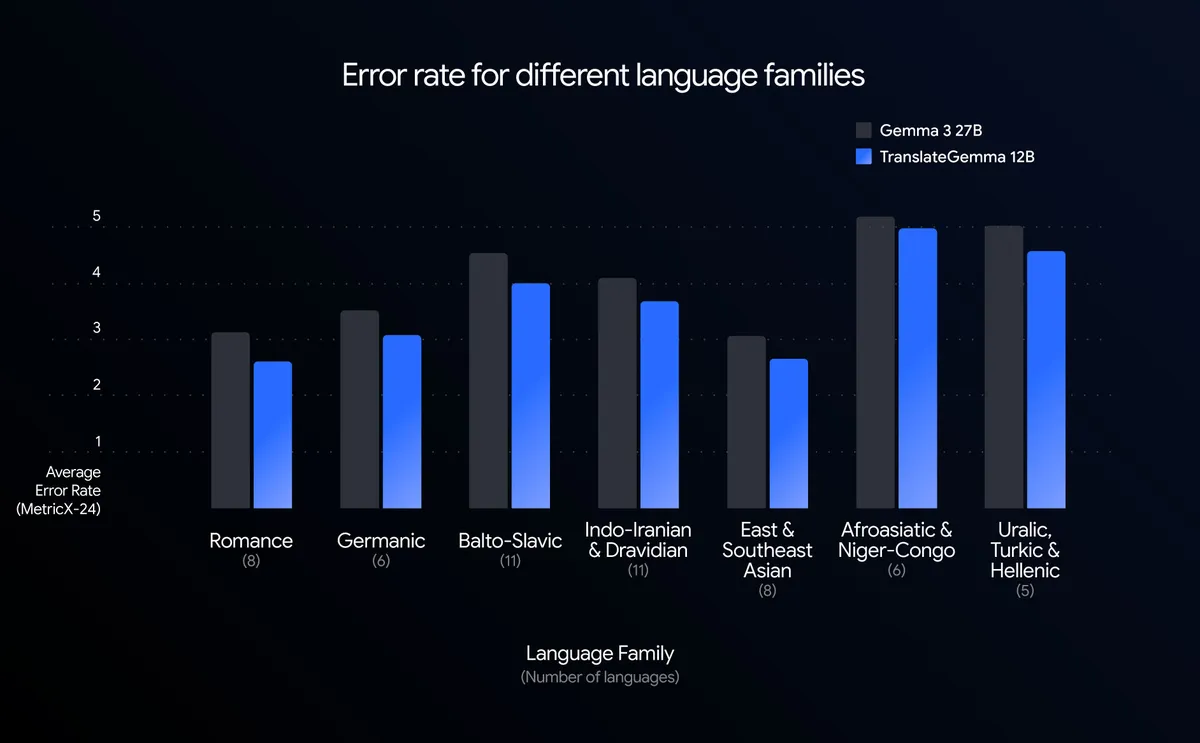
从这张官方图可以读出的规律是:在全部 7 个语系分组里,TranslateGemma 12B(蓝柱)的平均错误率都低于 Gemma 3 27B(灰柱);其中 Afroasiatic & Niger-Congo 与 Balto-Slavic 两组的绝对错误率最高(约 4–5),Romance 与 East & Southeast Asian 相对较低(约 2.4–3.5)。
二、关键数据一览
| 项目 | 官方数值 | 口径与来源 |
|---|---|---|
| 参数规模 | 4B / 12B / 27B | 基于 Gemma 3,官方博客 |
| 语言覆盖 | 55 种 | 官方训练+评测语言对 |
| 扩展训练语对 | 近 500 个额外语言对 | 官方称”已训练但无已确认评测指标” |
| 核心结论 | 12B > Gemma 3 27B 基线 | WMT24++,MetricX 度量 |
| 图像翻译测试 | Vistra 基准 | 翻译文本能力在图内文字翻译上有正向迁移 |
| 27B 部署目标 | 单张 H100 GPU 或云端 TPU | 官方部署建议,非实测吞吐 |
| 4B 部署目标 | 移动端/边缘 | 官方定位 |
三、技术机制:两阶段蒸馏自 Gemini
官方解释”密度”来自一个专门的两阶段微调流程,把 Gemini 的”直觉”蒸馏进开源架构:
- 监督微调(SFT):在多样化平行语料上微调 Gemma 3 基座,数据混合了人工翻译文本与由最先进 Gemini 模型生成的高质量合成翻译,以覆盖广、保真度高,尤其照顾低资源语言。
- 强化学习(RL):使用一组奖励模型做进一步精炼,包括 MetricX-QE 与 AutoMQM 这类高级指标,引导模型产出上下文更准确、更自然的译文。
此外,TranslateGemma 保留了 Gemma 3 的多模态能力:官方在 Vistra 图像翻译基准上测试发现,即使 TranslateGemma 训练过程中没有专门做多模态微调,文本翻译能力的提升也正向迁移到了”翻译图片内文字”。
四、部署档位
官方按三档参数给出对应部署环境:
- 4B:面向移动与边缘部署;
- 12B:可在消费级笔记本上流畅运行,把研究级能力带到本地开发环境;
- 27B:追求最高保真度,可在单张 H100 GPU 或云端 TPU 上运行。
五、评测口径与局限(必须注意)
这一节是本文重点。官方数据需要区分”自动指标”与”人类评价”:
- MetricX 是自动度量,不是人类偏好:所谓”错误率更低”是 MetricX(图中标注 MetricX-24)在 WMT24++ 上的计算结果。自动指标与人工评分之间存在已知偏差,错误率下降并不等价于母语者主观质量等比例提升。
- 近 500 个额外语言对”没有已确认指标”:官方明确说对这组扩展语言对尚未有确认的评测数值,只是把完整列表放进技术报告以鼓励社区研究。也就是说,这部分是”训练覆盖”而非”已验证能力”,不能宣传为可商用质量。
- 12B 超过 27B 是在 WMT24++ 这一基准上的结论:换个领域(专业术语、长文档、口语)未必保持同样差距;蒸馏模型的上限受 Gemini 教师模型约束。
- 图像翻译提升是”附带效应”:官方自己强调训练时没有做多模态微调,Vistra 上的正向迁移范围有限,不能当作成熟的 OCR+翻译产品能力。
- 27B “单张 H100”是部署建议而非实测:官方没有给出吞吐/时延数字,落地前需自行压测。
- 低资源语言仍偏薄弱:从柱状图看,Afroasiatic & Niger-Congo、Balto-Slavic 等组绝对错误率仍明显高于主流语系。
六、适用与不适用场景
- 适合:需要离线/私有化翻译、在意数据不出域的团队;在消费级硬件上跑 12B 做本地翻译研究;以 55 种主流+低资源语言为目标、愿意用自动指标先行筛选再人工抽检的场景。
- 不适合直接信任的:对翻译质量要求极高的专业/法律/医疗场景——应自行做人工盲评,而不是直接采信 MetricX 分数;以及那近 500 个”只训练、未评测”的扩展语言对。
- 可关注:把它作为基座再针对特定语言对做微调(官方定位本就是”进一步适配的起点”)。
七、它意味着什么
TranslateGemma 代表了开源翻译模型的一个务实方向:不追求通用大模型的全才,而是用蒸馏+RL 把一个垂直任务做到小参数可用。对国内开发者而言,它的价值在于可自托管、可微调、无 API 调用成本;但落地时务必记住:官方给出的是自动指标口径,真正决定是否可用的,仍然是你自己业务语言对上的人工评测。