Transformers.js:把 Hugging Face 模型直接搬进浏览器
阅读时间: 大约 9 分钟
Transformers.js:把 Hugging Face 模型直接搬进浏览器
Transformers.js(npm 包名 @huggingface/transformers)是 Hugging Face 官方维护的 JavaScript 库,口号是”Run 🤗 Transformers directly in your browser, with no need for a server”。它把 Python 生态里 transformers 库常用的模型能力,搬到了浏览器里执行。本文基于其官方 README 做技术拆解。
一、背景:浏览器里跑模型,为什么以前难
浏览器做 AI 不是新话题,但长期受三件事卡住:模型是 PyTorch 权重、浏览器里没有成熟的深度学习运行时、大模型下载太慢。Transformers.js 的解法是把整条链路标准化:模型转 ONNX → ONNX Runtime 执行 → 量化降低体积。模型权重仍托管在 Hugging Face Hub,首次运行按需下载、本地缓存。
它的定位不是”在浏览器里跑 GPT-4”,而是把中小规模模型(分类、embedding、ASR、TTS、检测、分割等)的推理放到端侧,省掉一个后端。
二、技术机制:ONNX Runtime + WASM/WebGPU 双通道
- 执行后端:默认 CPU 走 WASM(ONNX Runtime Web);指定
device: 'webgpu'后走 WebGPU 调用显卡; - 模型格式:PyTorch / TensorFlow / JAX 模型用 🤗 Optimum 一行命令转 ONNX;
- 量化策略:
dtype参数控制精度——fp32(WebGPU 默认)、fp16、q8(WASM 默认)、q4。资源受限环境下官方建议量化,以降低带宽、提升推理速度; - API 对齐:
pipeline()与 Python 版语义一致,官方给出的对照示例里,同一句情感分析代码从 Python 改 JS 只差 import 和 await。
三、任务覆盖:一张表看清能做什么
README 官方任务矩阵(节选”✅ 已支持”项):
| 模态 | 已支持任务(官方标注 ✅) |
|---|---|
| NLP | 文本分类/情感分析、NER、问答、文本生成、翻译、摘要、零样本分类、特征提取、填空 |
| 视觉 | 图像分类、目标检测、图像分割、深度估计、背景移除、image-to-image、图像特征提取 |
| 音频 | 语音识别(ASR)、音频分类、文本转语音(TTS) |
| 多模态 | 文档问答、image-to-text、零样本图像分类、零样本目标检测、零样本音频分类 |
明确不支持(README 标 ❌)的包括:文本到图像生成、视觉问答(VQA)、video classification、表格类任务、mask generation。
四、用法:三行代码起步
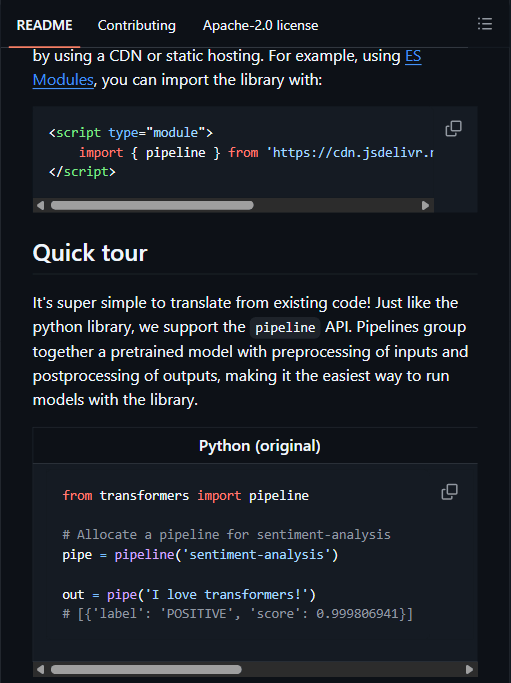
import { pipeline } from '@huggingface/transformers';
const pipe = await pipeline('sentiment-analysis');
const out = await pipe('I love transformers!');
// [{ label: 'POSITIVE', score: 0.999817686 }]
浏览器里可以直接用 ES Module CDN 引入,无需打包器:
<script type="module">
  import { pipeline } from 'https://cdn.jsdelivr.net/npm/@huggingface/transformers@4.3.0';
</script>
截至 2026 年 10 月回看仓库首页,npm 徽章已更新为 v4.3.0、周下载约 440 万次(Koala 收录时的快照还是 v3.5.1、周下载约 6.5 万次),说明这一年间它在前端圈的采用量级增长了约两个数量级。
也支持自定义模型路径、关闭远程模型加载(完全本地内嵌)、替换 WASM 文件路径——这对做”纯前端离线可用”产品是关键能力。
五、评测方法与口径偏差
- “与 Python 版功能等价”是 API 等价,不是效果等价。 README 明说 “functionally equivalent”——接口对齐了,但 ONNX 转换 + q8/q4 量化后,浮点误差与数值分布会和 PyTorch fp32 有细微差异,README 自己的示例输出分数(0.999817686 vs Python 的 0.999806941)就已对不上。生产级数值敏感任务要自行验证精度。
- WebGPU 仍是实验特性。 官方在 README 里用 WARNING 框标注:WebGPU 在很多浏览器里仍是实验态,遇到问题请提 issue。也就是说
device: 'webgpu'在 Safari/旧浏览器上不能当成默认可用能力。 - “浏览器里跑”有体积和延迟代价。 模型首访要从 Hub 下载(即使 q4 量化,视觉/音频模型也有数 MB 到数十 MB),WASM 冷启动与内存占用在低端移动浏览器上明显——它适合”用户每次访问跑一次小模型”,不适合高频大吞吐场景。
- 任务矩阵滞后于 Python 主库。 README 明确写:如果你需要的任务/架构不在列表里,开 issue——大模型(文本生成类的新架构)的 JS 移植永远比 Python 慢半拍。
- “无服务器”不等于”无成本”:推理发生在用户设备上,算力成本确实转嫁给了客户端,但模型下载流量仍走 CDN。
六、优势与局限
优势:
- 真·端侧 AI:隐私敏感数据(表单、文档、图片)不出用户设备;
- 零后端成本:静态托管即可跑分类/embedding/检测类产品;
- API 生态对齐 Python,迁移成本极低;
- Apache-2.0,可商用。
局限:
- 大模型生成(LLM 对话、图像生成、VQA)不在能力清单内;
- WebGPU 兼容性仍在爬坡;
- 量化精度损失需自行评测;
- 首包下载体验在弱网下差。
七、谁该用它
- 隐私优先的前端产品:本地文本分类、内容审核、图片抠图、浏览器内语音转写;
- 静态站/插件:不想为一个分类接口养一台后端;
- 教学与 Demo:零部署体验 HF Hub 上的开源模型。
需要 LLM 级生成能力时,它不是答案;但”浏览器里跑一个小而准的模型”这件事,它是目前生态最顺的选择。