Tracy:纳秒级分辨率的混合式性能剖析器,游戏与原生应用的"时间显微镜"
阅读时间: 大约 10 分钟
Tracy:纳秒级分辨率的混合式性能剖析器,游戏与原生应用的”时间显微镜”
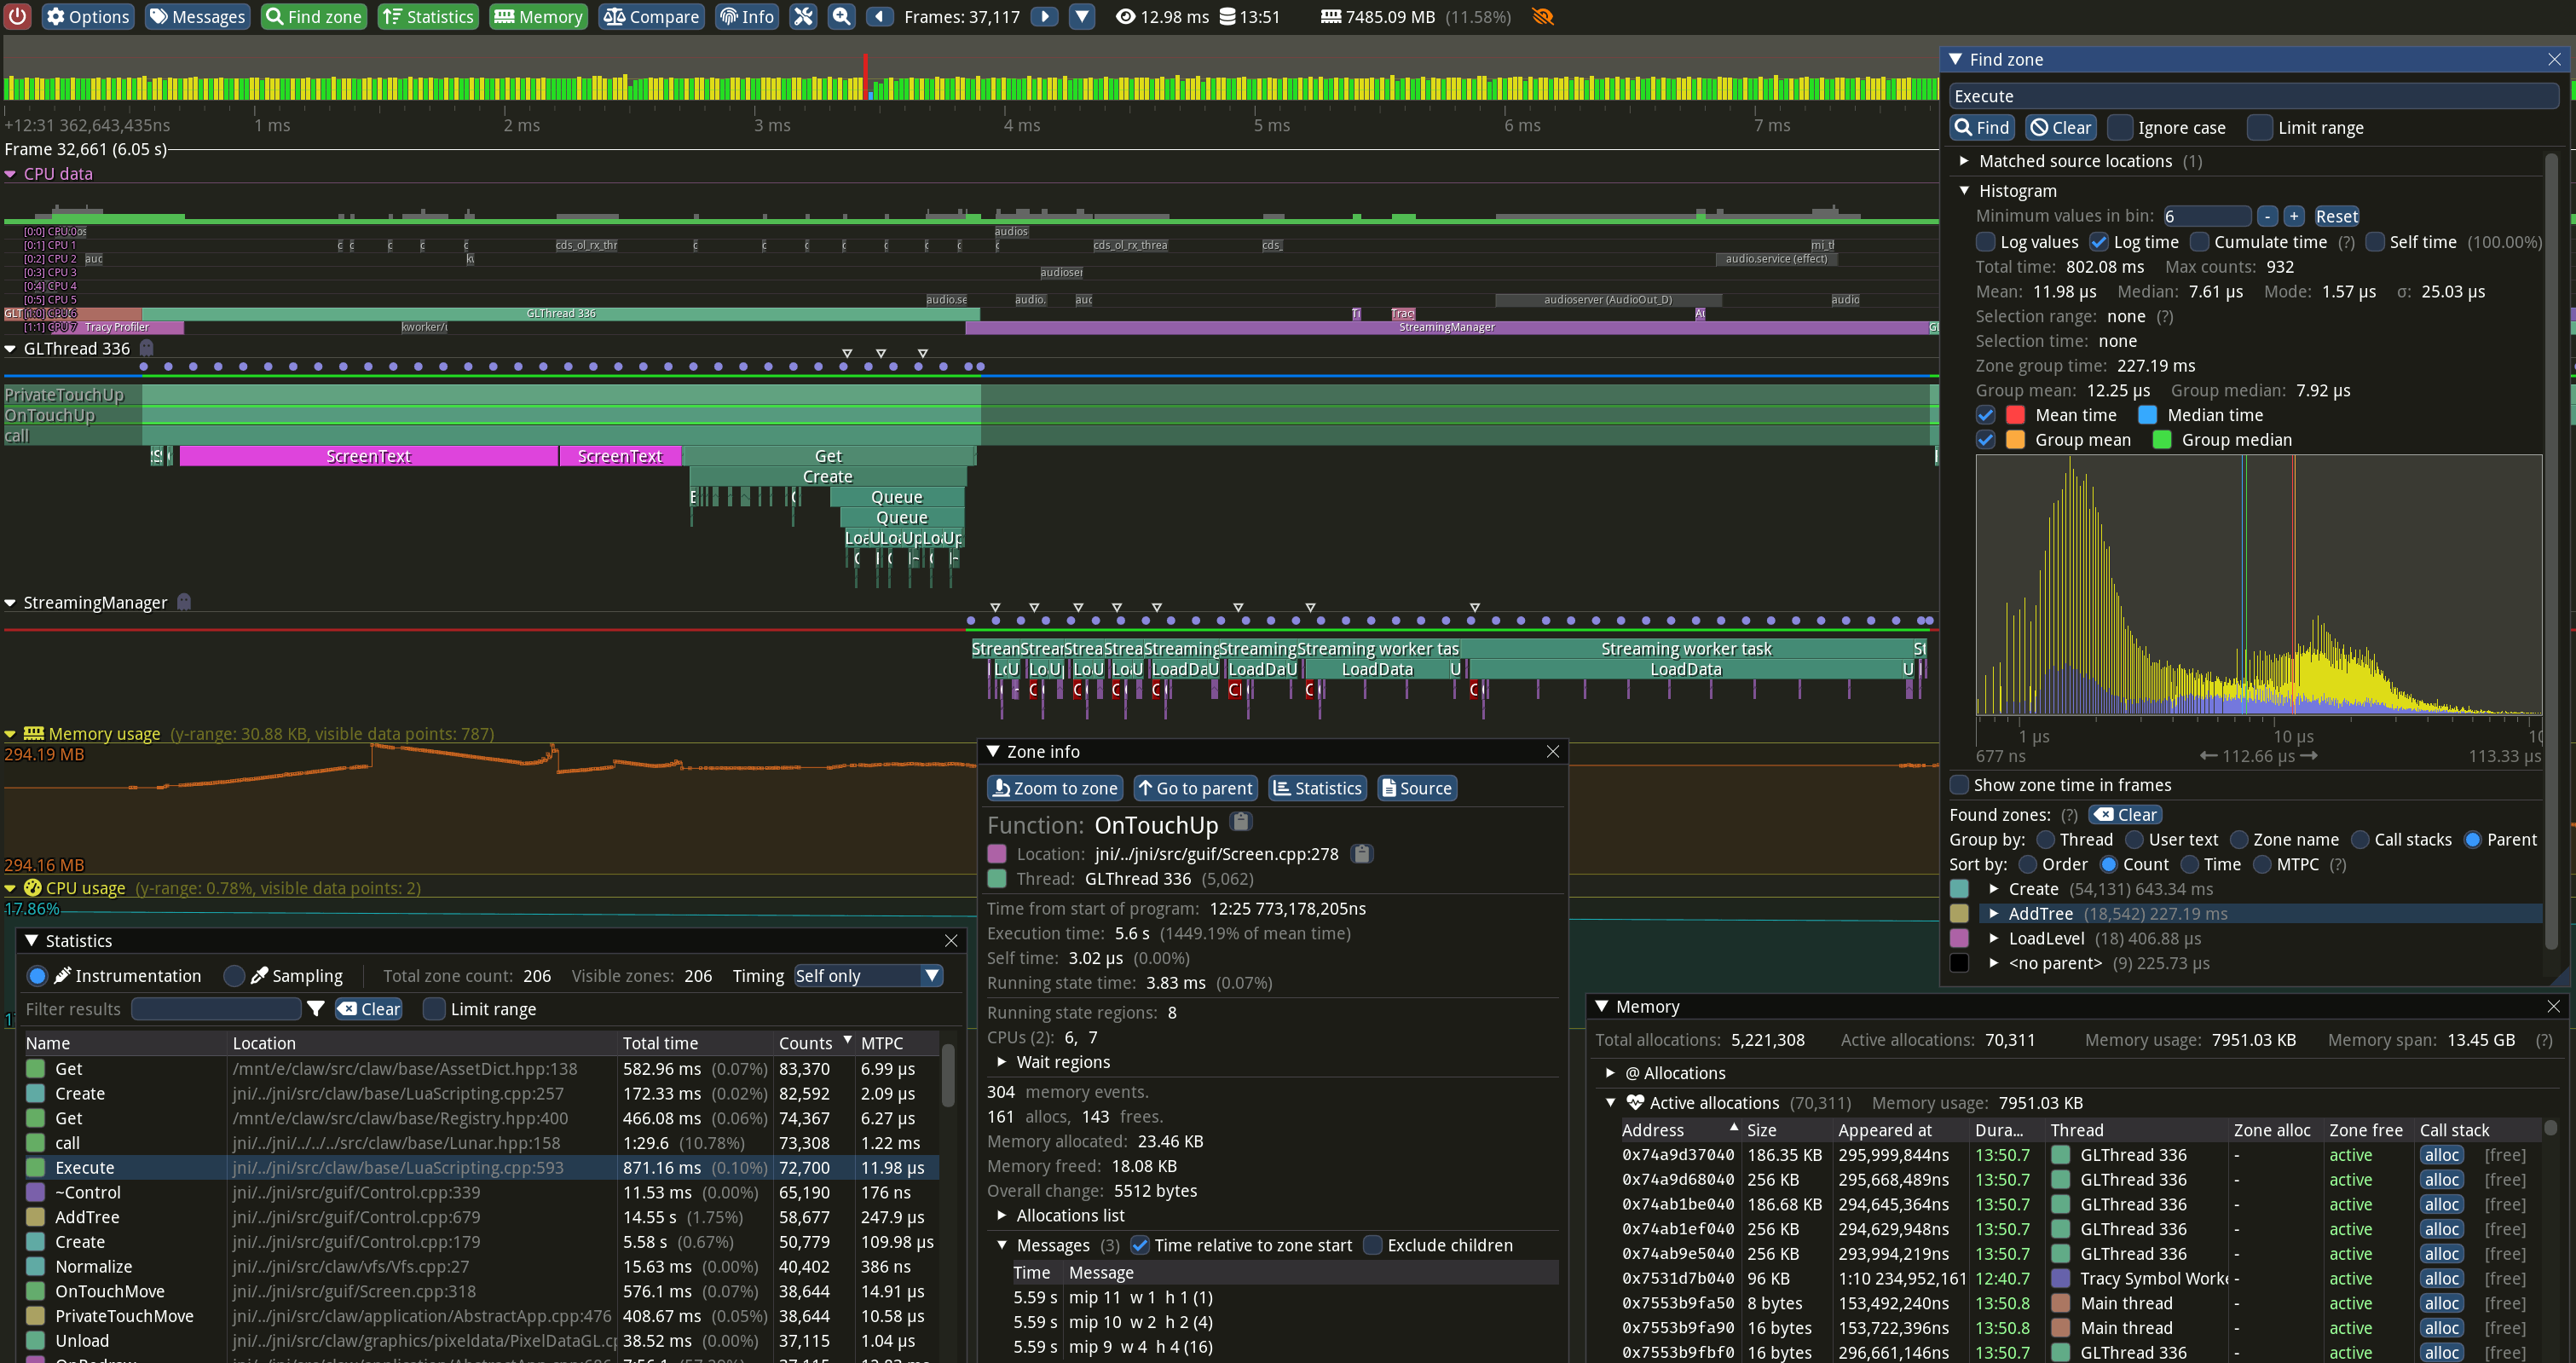
在 C++ 与游戏开发圈,性能剖析工具有两条路线:一条是 perf/Instruments 这类采样 profiler,另一条是 Detours/手动计时这类插桩 profiler。开源项目 Tracy(作者 wolfpld,官网 tracy.nereid.pl)走的是中间路线——官方自我定位是”a real time, nanosecond resolution, remote telemetry, hybrid frame and sampling profiler for games and other applications”(实时、纳秒级分辨率、远程遥测、帧剖析与采样混合的剖析器)。它在 GitHub 上约 16.8k stars、1.2k forks、累计 11,075 次提交,是原生程序性能分析里口碑很高的一款。
一、它解决什么问题
游戏与高实时性原生应用的性能问题,往往不是”哪个函数慢”这么简单,而是:一帧里 CPU 与 GPU 如何交错、锁争用发生在哪个线程、内存分配在什么时间点爆发、上下文切换造成了多少卡顿。传统采样 profiler 给的是”函数占比直方图”,插桩 profiler 给的是”某段代码耗时”,但很少把帧时间线、调用栈、GPU 命令、内存分配、截图放在同一个时间轴上对齐。Tracy 的核心卖点就是把这些维度合并到一条纳秒级时间轴里,并支持远程(通过网络)采集。
二、覆盖范围:CPU、GPU、内存、锁、上下文切换
根据 README,Tracy 直接支持的观测对象包括:
- CPU:官方直接集成 C、C++、Lua、Python、Fortran;社区第三方绑定覆盖 Rust、Zig、C#、OCaml、Odin 等。
- GPU:覆盖几乎所有主流图形/计算 API——OpenGL、Vulkan、Direct3D 11/12、Metal、OpenCL、CUDA、WebGPU。
- 内存分配:跟踪 alloc/free,可定位热点分配点。
- 锁与上下文切换:观察线程争用与调度行为。
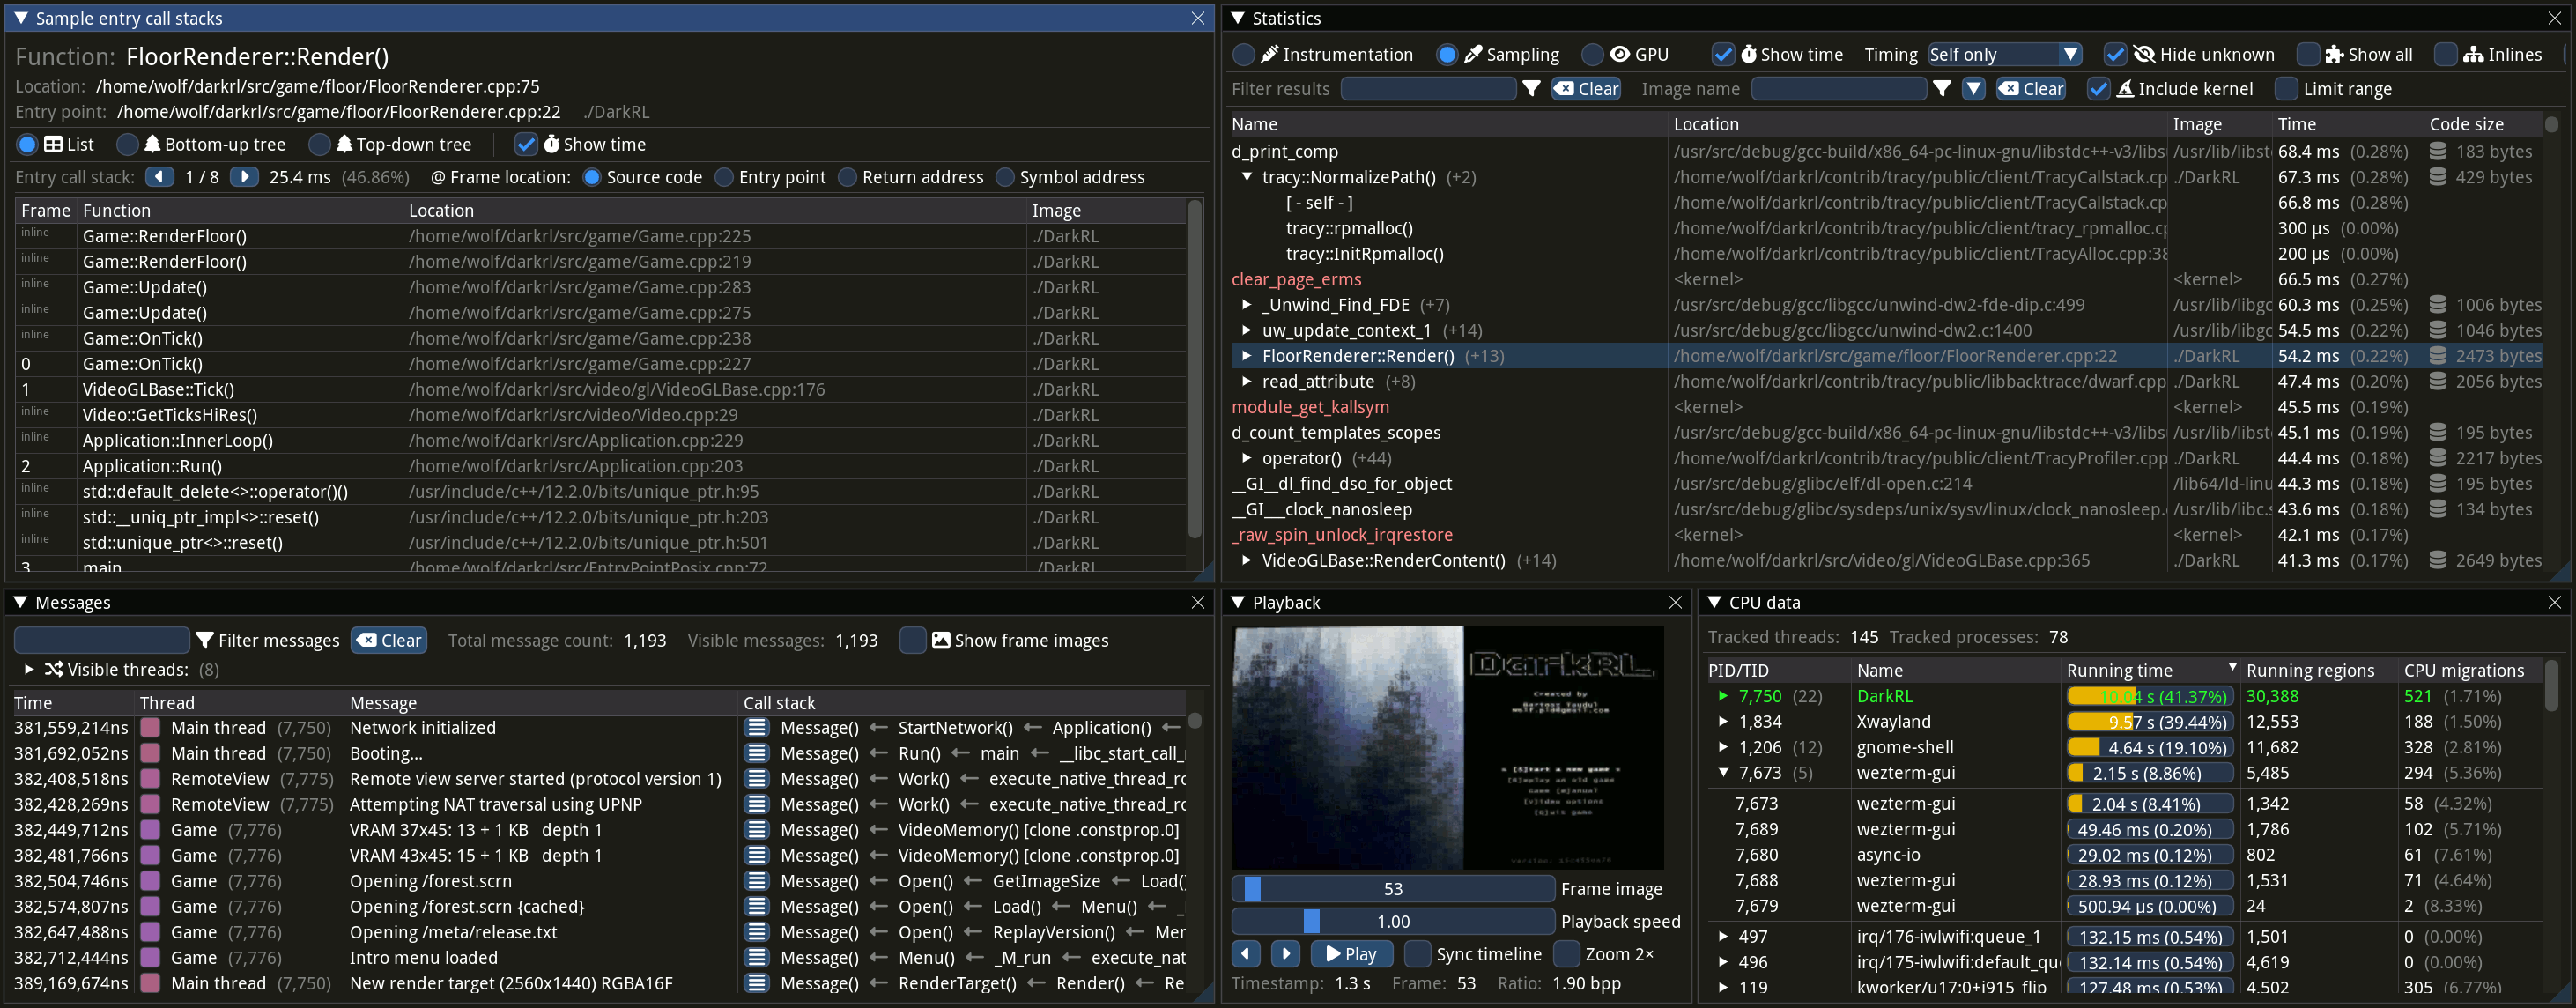
- 截图归因:能自动把截图绑定到对应捕获帧上,实现”看到卡顿帧时直接回放当时画面”。
三、可核对的能力数字与界面证据
Tracy 官方 README 本身不以”跑分”见长,更多是能力清单;下面这些数字来自其官方仓库与演示截图,作为”能测到什么粒度”的佐证:
| 维度 | 官方/截图数值 | 口径说明 |
|---|---|---|
| 时间分辨率 | 纳秒级(nanosecond resolution) | 官方定位,指时间戳粒度,非采样开销精度 |
| 单次捕获帧数量 | 37,117 帧(演示) | 主界面顶部计数,示例项目 DarkRL |
| 平均帧时间 | 12.98 ms(演示) | 约对应 77 FPS 量级 |
| 热点 zone 统计 | OnTouchUp 均值 11.98 µs、中位数 7.61 µs | 截图中 Find zone 直方图 |
| 内存分配总量 | 5,221,308 次分配、70,311 个活跃分配 | 演示项目内存面板 |
| 线程/进程跟踪 | 145 个线程、78 个进程 | 演示项目 CPU 面板 |
| GPU API 覆盖 | OpenGL/Vulkan/D3D11/12/Metal/OpenCL/CUDA/WebGPU | README 能力清单 |
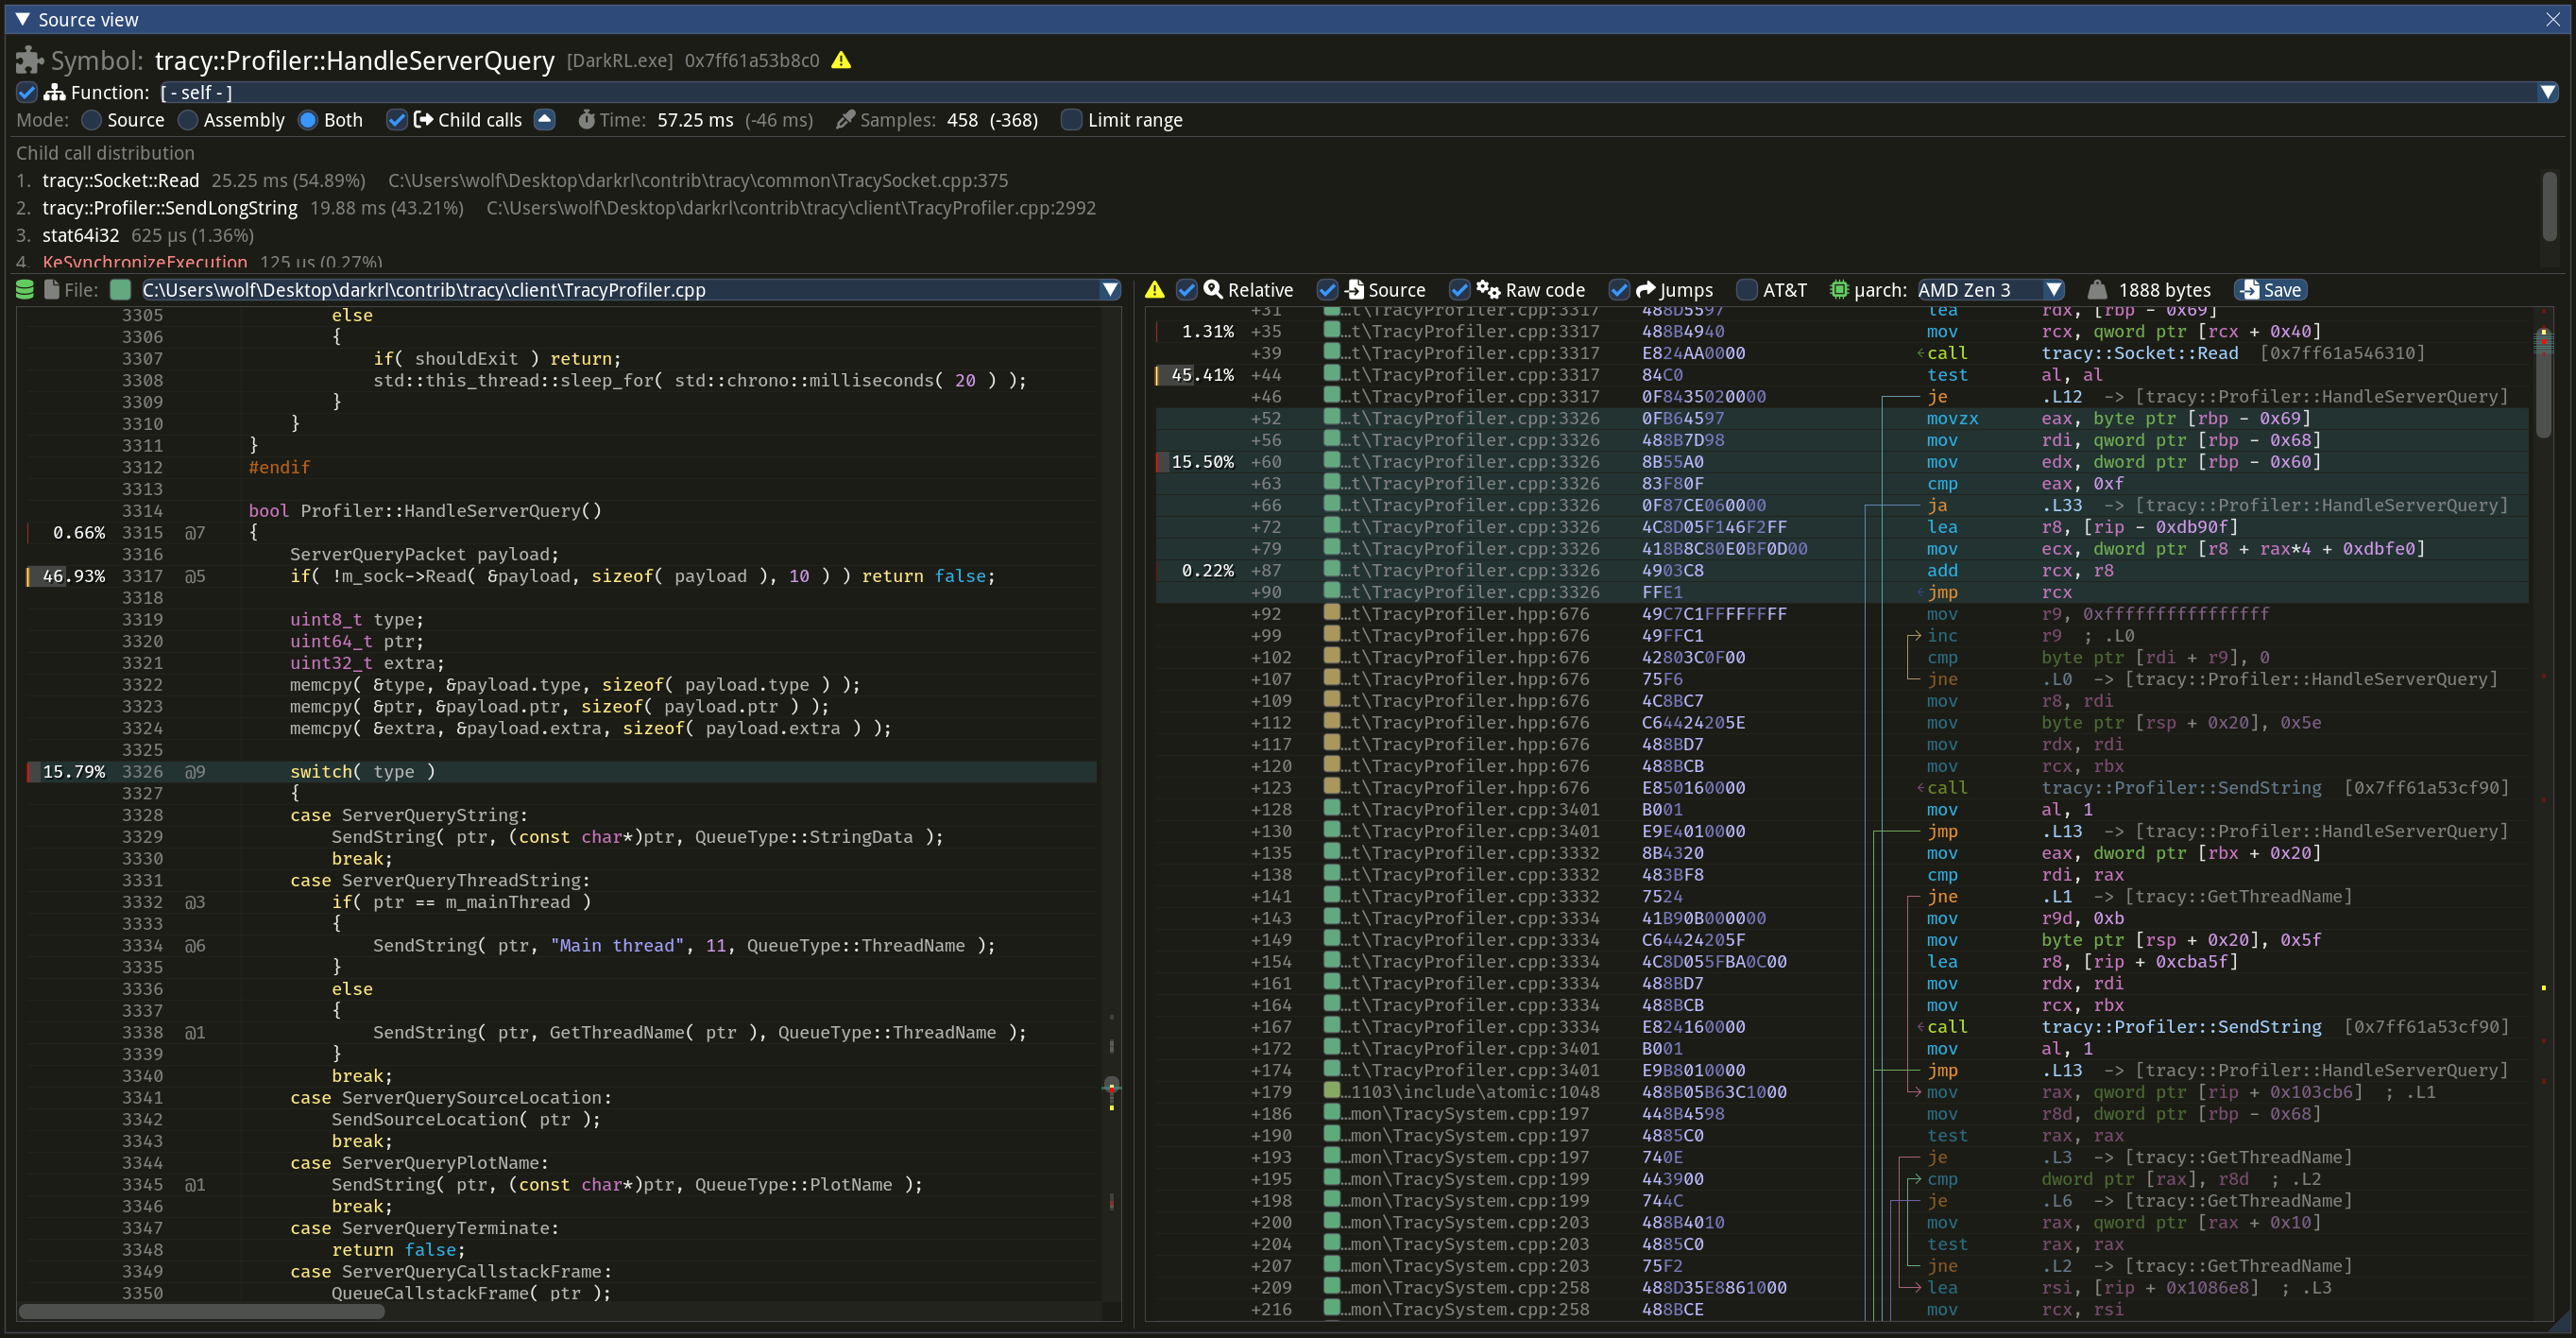
第三张图展示的是 Tracy 较硬核的能力:把采样热点反查到源码行与汇编指令级别(截图里 HandleServerQuery 某行标注 45.41%,子调用分布显示 tracy::Socket::Read 占 54.89%、SendLongString 占 43.21%),这对定位自身采集开销与底层热路径很有用。
四、它是怎么工作的:插桩 + 采样混合
从界面与文档结构可以看出,Tracy 采用”hybrid”混合机制:
- 插桩(instrumentation):开发者用宏把关键代码段标记为 zone(如
ZoneScoped),Tracy 就能精确记录这段的进入/退出时间、调用栈、线程归属。这是它”帧剖析”能力的基础。 - 采样(sampling):在未插桩的部分,Tracy 也可周期性采样调用栈,发现你没预料到的热点。
- 远程遥测:被剖析程序通过网络把事件流发到 GUI,GUI 端做聚合与可视化,因此可以分析运行在无显示器设备(如服务器、开发板)上的程序。
五、局限与口径偏差(必须知道的几点)
把 Tracy 当”银弹”会踩坑,以下是它自己的能力边界:
- 以 C/C++ 为绝对中心:官方一等支持是 C/C++/Lua/Python/Fortran,其余语言靠社区第三方绑定,功能完整度与版本跟进都不受官方保证。Rust/Zig 等项目想用,需要自己评估绑定成熟度。
- “纳秒级”是时间戳分辨率,不是免费午餐:插桩本身有开销,热点函数过密会改变程序行为(探针效应)。官方界面甚至专门显示”Running state time 0.07%“这类占比,就是让你判断采集开销是否可接受。
- 需要主动插桩才能发挥价值:不写 zone 标记,Tracy 就退化为普通采样器;想拿到帧、GPU、内存的对齐视图,必须按文档接入对应的 hook。
- GUI 客户端以 Windows 为主:Releases 里打包的是 Windows x64 二进制与
tracy.pdf文档;跨平台构建要自己看文档,开箱即用的体验在非 Windows 上相对弱。 - 截图归因依赖帧 hook:自动把截图绑到帧,前提是你已经把帧呈现流程接进 Tracy,不是装上就能看到游戏画面。
六、适用与不适用场景
- 适合:C/C++ 游戏、实时渲染、音视频处理、高频服务端等对帧时间与线程交错敏感的原生程序;愿意花时间插桩、追求精确定位的团队。
- 不太适合:纯高层语言(Java/Go/Node)应用——虽有社区绑定,但不是官方主战场;只是想快速看一眼”哪个函数慢”而不想插桩的场景,perf/pprof 可能更轻。
- 特别适合:需要远程分析、需要 CPU/GPU/内存时间线对齐、需要把卡顿帧与画面回放对照的场景。
七、它意味着什么
Tracy 代表了原生性能剖析里”重投入、高回报”的一极:它不像 perf 那样零成本上手,但一旦接好,能给出采样 profiler 给不出的帧级、跨 API 的时间线证据。对游戏与实时系统团队,它和 RenderDoc、Nsight 这类工具互补——后者看 GPU 单帧内部,Tracy 看 CPU/GPU/内存/线程如何共同决定每一帧。理解它的正确姿势是:先承认它需要插桩、以 C/C++ 为中心,再决定是否为目标程序接一套 Tracy。