TimesFM 3.0:Google 把时序预测基础模型从"单变量"推进到"多变量 + 协变量"
阅读时间: 大约 8 分钟
TimesFM 3.0:把时序预测从”单变量”推进到”多变量 + 协变量”
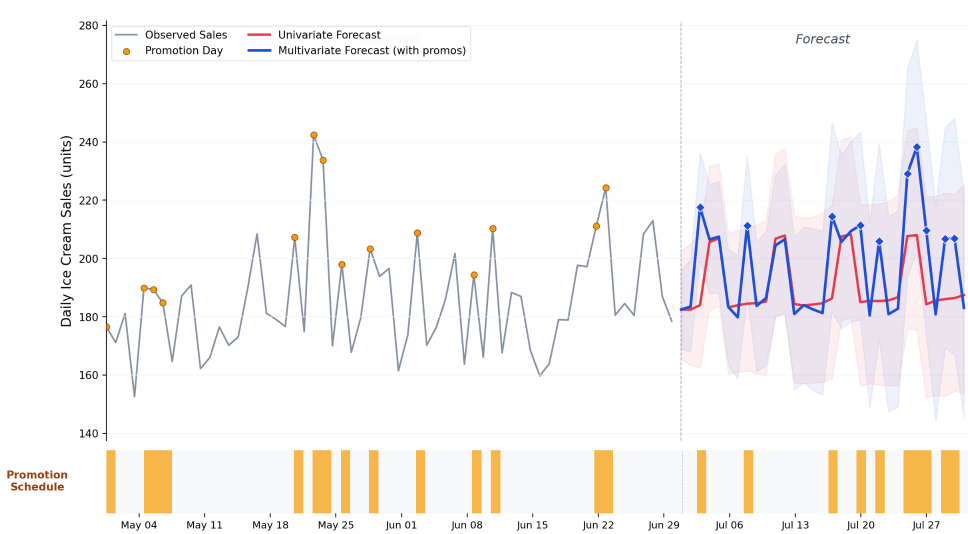
2026 年 8 月 31 日,Google Research 发布 TimesFM 3.0,这是其时序预测基础模型(Time Series Foundation Model)系列的第三代。与前几代”一次预测一条序列”不同,TimesFM 3.0 首次原生支持多变量(multivariate)预测:在单次前向传播里同时预测多条相互关联的序列,并允许模型把”历史才知道”和”未来提前知道”的协变量纳入考量。权重已在 Hugging Face 开放(google/timesfm-3.0-pytorch),代码在 google-research/timesfm 仓库。
一、出发点:单变量模型够不着真实业务
过去的 TimesFM(1.0/2.0/2.5)以及同期的许多时序基础模型,本质上都是单变量的:给一条序列自己的历史,预测它的未来。但真实的运营决策几乎从不只看一个数字——预测冰淇淋销量时,你手里同时有历史客流、未来天气预报、以及排期好的促销日历。
TimesFM 3.0 的核心变化就是结构层面的:它在预训练阶段就按”多变量 + 协变量”来学,而不是事后拼接。官方称其为零样本(zero-shot)模型——无需针对你的任务做微调,直接喂数据出预测。
二、技术机制:一次前向输出整条 horizon
根据 Hugging Face 模型卡与 GitHub 文档,TimesFM 3.0 的关键设计如下:
- 架构:Stacked Mixing Transformer,含 Variate Attention(变量间注意力)与 CPM Iterative RevIN;
- 参数规模:约 330M(0.3B);
- 结构:20 层 Transformer,模型维度 1280,16 个注意力头;
- 分块(patching):上下文 patch 长度 32,预测 horizon patch 长度 64;
- 输出:一次性输出完整预测区间,并给出 9 个分位数(中位数在第 4 位);
- 上下文窗口:最长约 15,360 个时间点,超长会截断到最近的部分。
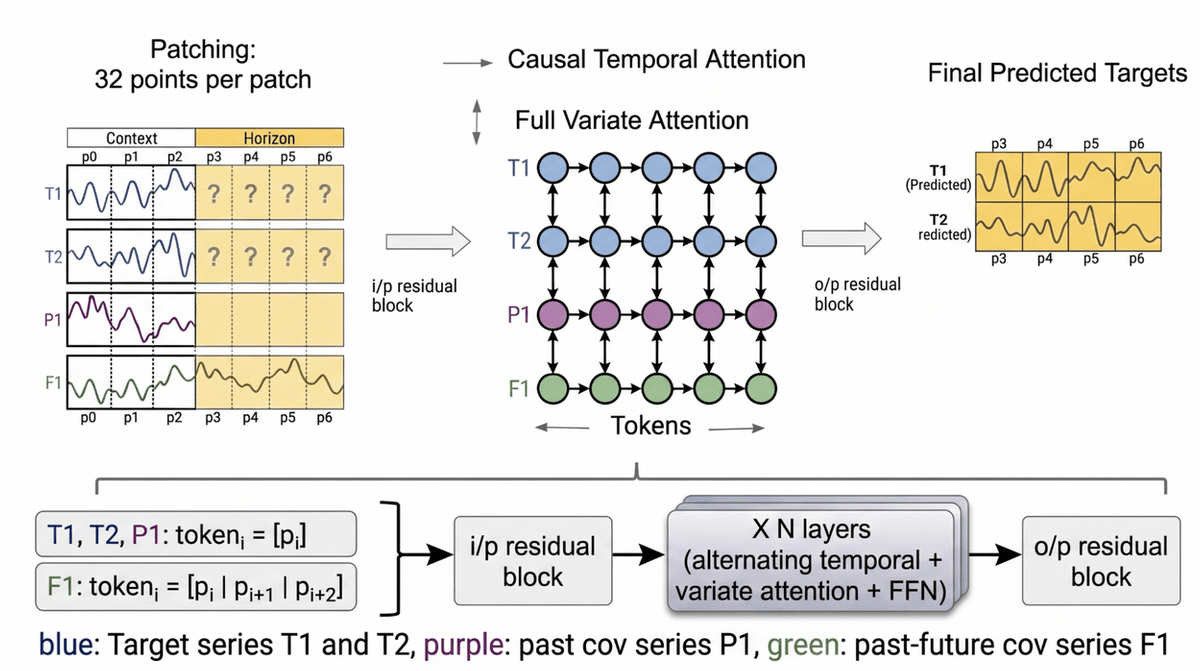
图中可以看到三类被平等建模的序列:蓝色是目标序列 T1/T2,紫色是只在过去已知的协变量 P1(如历史客流),绿色是过去和未来都已知的协变量 F1(如未来促销日历、天气预报)。模型在层内交替进行时间维注意力与变量维注意力,让相关序列互相提供信息。
预训练数据方面,模型卡说明其使用了 GIFT-Eval 预训练集(剔除与 fev-bench 重叠的部分)、截至 2023 年 11 月的 Wikipedia 页面浏览量、截至 2022 年底的 Google Trends 热门查询,以及合成与增强数据。多方报道称预训练覆盖超过 1 万亿个时间点。
三、关键数据与基准
官方在 README 中给出的基准名次如下:
| 基准 | 官方名次 | 规模 |
|---|---|---|
| fev-bench | 总榜第 1 | 100 个真实预测任务 |
| TIME Benchmark | 总榜第 1 | 50 个领域数据集 / 98 个评测任务 |
| GIFT-Eval | 基础模型中第 1 | — |
工程侧,它还提供了 MLX 原生后端,可在 Apple 芯片上不依赖 PyTorch 运行。官方给出的实测(330M 模型、Apple M4 Max、上下文 512、horizon 64、fp32):
| batch | p50 延迟 | 吞吐 |
|---|---|---|
| 1 | 11.1 ms | 90 系列/秒 |
| 8 | 19.7 ms | 406 系列/秒 |
| 32 | 48.1 ms | 666 系列/秒 |
接入方式很简单:pip install timesfm[torch](或 [mlx]),加载 google/timesfm-3.0-pytorch 即可。它也已进入 Google 自家产品:BigQuery ML、Google Sheets、Vertex Model Garden。模型卡在 HF 上月下载量约百万级。
四、必须知道的限制:权重不是 Apache
这是本次发布最容易被忽略、却最影响商业使用的一点:
- 代码:仓库源码采用 Apache-2.0;
- ≤2.5 的权重:仍为 Apache-2.0;
- TimesFM 3.0 权重:单独采用
timesfm-non-commercial-license-v1.0,仅限非商业、非生产环境使用,默认预训练权重不得用于商业或生产。
也就是说,你可以免费研究、实验、做非商用 PoC,但要在生产里跑 3.0 权重,需要另行与 Google 沟通授权。这与”代码开源”是两回事,选型时务必区分。
此外,官方的”三项基准第一”均为自报名次;已有第三方独立实测反馈:零样本预测能力站得住,但协变量等新特性在其自选数据上的实际收益并不稳定。零样本基础模型的泛化边界,仍需在自己的业务数据上验证。
五、客观评价
优势:
- 真正原生多变量:把相关序列与已知未来事件一起建模,更贴近零售、运维、金融等真实负载;
- 零样本、免微调:330M 小模型即可开箱预测,省去为每条业务线搭传统统计模型/梯度提升树的工程;
- 一次前向出全区间:避免了自回归逐步预测的误差累积与推理开销;
- 多后端:PyTorch 与 Apple MLX 都支持,本地推理门槛低。
边界:
- 权重非商用许可是硬门槛;
- 基准为官方自报,协变量收益有待独立复现;
- 超长/强季节性/突变事件仍可能超出零样本能力,复杂场景大概率仍需微调。
六、它适合谁
- 零售/供应链/运维:需要联合预测多条相关指标、且手头有排期促销、天气等”未来已知”信息的团队;
- 数据平台与 BI:想给产品加一个”开箱即用”的预测能力,而非为每个指标手工建模;
- 研究者:一个小而开放、可复现的多变量时序基础模型样本。