TernFS:量化交易公司 XTX 开源的 EB 级多区域分布式文件系统
阅读时间: 大约 11 分钟
TernFS:量化交易公司 XTX 开源的 EB 级多区域分布式文件系统
大科技公司几乎都自研分布式文件系统,但极少有人把它开源——要么跟自家基础设施耦合太深,要么被视为竞争壁垒。2025 年 9 月,算法交易公司 XTX Markets 打破了这个惯例:把自研文件系统 TernFS 以自由软件形式在 GitHub 上开源。XTX 用它支撑全球 5 万多种金融工具的统计建模与交易,从两台桌面机加一台 NFS 起步,十年后长成数万张高端 GPU、数十万 CPU、数百 PB 存储的规模。本文基于 XTX 官方技术博客,拆解 TernFS 的架构、硬数字与官方自己承认的边界。
一、背景动机:NFS 和现成文件系统都被撑爆了
XTX 研究算力增长很快,存储成了瓶颈。他们先用 NFS,随后又陆续”撑爆”了市面上的开源与商业文件系统,评估了一圈第三方方案后决定自研。TernFS 的定位是”一站式”存储方案:从相对冷的原始行情数据,到 GPU 作业之间用来通信的短生命周期随机访问数据,都要能装下。官方给的目标画像很直白——设计上可扩展到数十 EB、数万亿文件、百万级并发客户端。
二、是什么:四个松耦合服务
按官方高层概述,TernFS 的核心 API 由四个服务实现:
- 元数据分片(Metadata shard):存目录结构与文件元数据;
- 跨目录协调器(CDC, Cross-Directory Coordinator):执行跨分片事务;
- 块服务(Block Service):存文件内容;
- 注册表(Registry):记录所有其他服务的位置并做监控。
整体设计哲学是”解耦”:各服务之间不直接通信,而是由客户端分别直连。客户端只要知道 Registry 的地址就能挂载 TernFS,其余服务位置都从 Registry 拿。通讯走 TCP/IP(块服务另有 UDP),硬件无关,且不依赖外部服务,构建依赖极少(主要是 C++、Go 以及 RocksDB)。
三、技术机制:256 分片 + 自定义 Raft
元数据层是 TernFS 最见功力的部分。元数据被切成 256 个逻辑分片,分片之间永不通信。每个逻辑分片再拆成 5 个物理副本(1 个 leader + 4 个 follower),跑一套自研的、类似 Raft 的共识引擎(官方命名 LogsDB),副本内部用 RocksDB 做读写存储。目录创建时由 CDC 以轮转方式分配给某个分片,此后该目录下的所有条目都固定在同一个分片。
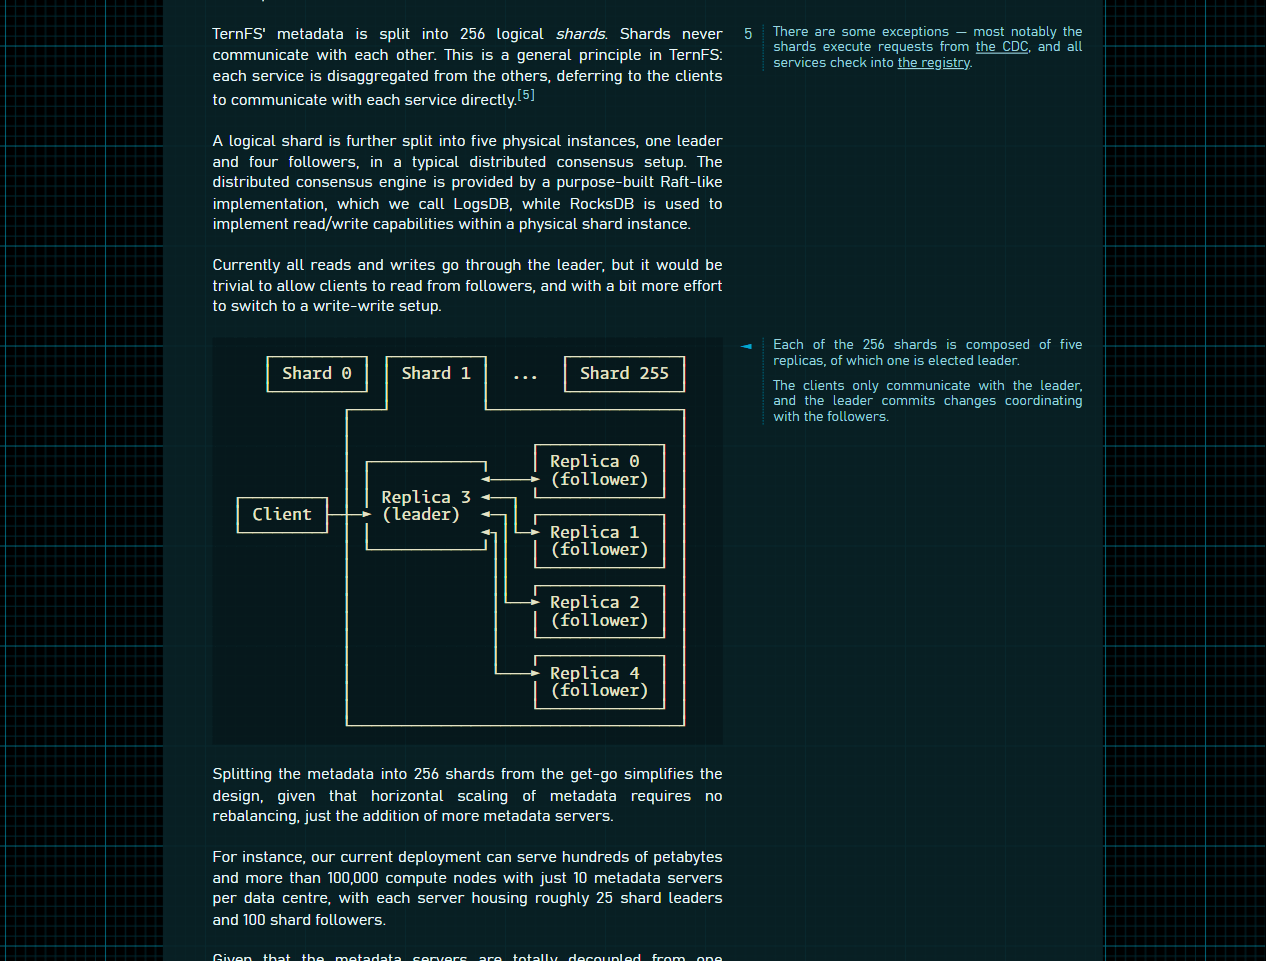
这套设计带来两个直接好处:其一,元数据水平扩展不需要再均衡(rebalance)——加分片服务器就行;其二,规模数字非常克制却惊人:目前生产部署支撑数百 PB、超过 10 万个计算节点,每个数据中心只用约 10 台元数据服务器(每台约 25 个 leader、100 个 follower)。官方称元数据性能可轻松扩展 25 倍,若允许从 follower 读则可达 100 倍。
块服务把文件切成块(block),一个块服务通常就是一块盘(HDD 或 SSD)。XTX 一台典型存储服务器约装 100 块机械盘或 25 块闪存——闪存密度低是因为它更快打满存储服务器的网络带宽。块服务用一个 Go 进程提供简单 TCP API,直接把块写到本地文件系统。
**跨目录操作(建目录、删目录、跨目录移动条目)**需要 CDC 协调,CDC 本身也是 5 副本、用 LogsDB 持久化状态。这是 TernFS 刻意承认的瓶颈:官方说 CDC 目前封顶约 1 万次请求/秒,而整个 TernFS 常规跑在每秒数百万请求;不过他们认为不做架构改动也能轻松再快 10 倍,只是生产里没成为问题,所以没投入优化。
四、关键数据:官方口径
| 项目 | 官方口径 |
|---|---|
| 开源方 / 时间 | XTX Markets,2025 年 9 月 |
| 设计规模 | 数十 EB、数万亿文件、百万级并发客户端 |
| 生产现状(2025-09) | 存储超 500PB,分布在 3 万块机械盘 + 1 万块闪存、3 个数据中心 |
| 峰值吞吐 | 每秒数 TB(“multiple terabytes per second”) |
| 数据丢失 | 官方称”至今未丢一个字节(haven’t lost a single byte)” |
| 元数据分片 | 256 个逻辑分片 × 5 副本(1 leader + 4 follower) |
| 元数据共识 / 存储 | 自研 Raft 类 LogsDB + RocksDB |
| 元数据服务器用量 | 每数据中心约 10 台,支撑 10 万+ 计算节点、数百 PB |
| CDC 吞吐上限 | 约 1 万 req/s(整体系统常规数百万 req/s) |
| 块服务密度 | 每存储服务器约 100 HDD 或 25 闪存 |
| 时间线 | 2022 年初设计,2023 年夏投产,2024 年中全部 ML 跑在 TernFS 上 |
五、局限 / 口径:官方自己划的边界
- 文件不可变:一旦写入就不能修改。TernFS 内核模块不兼容 POSIX,只暴露”足够多的 POSIX”让多数程序不改就能跑——按从左到右顺序写、写完不改内容的程序(他们惊讶地发现 rsync 开箱即用)能跑,其余程序要先写临时文件再拷贝过去;
- 不适合小文件:官方中位数文件大小是 2MB,小文件场景不是为它设计的;
- 目录建删吞吐受限:这正是 CDC 瓶颈所在,与其他操作相比”显著受限”;
- 无权限模型(permissionless):权限管控被推给外部服务;
- 多区域是异步收敛:每个区域配置大致对等资源,元数据与文件内容复制都是异步的——官方的判断是”丢一整个数据中心足够罕见”,因此容忍一段未完全复制的数据窗口;每个位置有一个元数据主,非主位置的写要等写回主并回传后才确认;
- 快照恢复工具不随开源发布:删文件其实是把它变成快照,再由外部 Go 垃圾回收进程按目录策略回收;但 XTX 用来恢复已删文件的内部工具”与内部工作流耦合太紧”,没有一起开源;
- 首图那条可靠性曲线是按纠删码容错模型推算的概率曲线,不是某批硬盘的实测统计——它说明的是”在 N 块盘同时损坏前几乎不会丢数据”的设计保证,而非真实故障率。
六、适用 / 不适用场景
适用: PB→EB 级、以大文件为主、AI/ML 训练数据集与模型存储、批量写 once-read many 的数据湖;多区域容灾、对元数据规模有横向扩展诉求的大型组织;能接受”写后不可变”语义的流水线。
不适用: 大量小文件、频繁随机改写的 POSIX 业务(源码树、用户 home 目录、数据库数据文件);对目录元数据操作吞吐要求高的 workload;没有专业存储运维团队的中小组织——这类基础设施部署门槛极高。
七、客观分析:优势与局限
优势:
- 来自生产、规模真实:500PB、10 万计算节点、峰值数 TB/s 是已跑起来的数字,不是 PPT 架构;
- 元数据架构干净:256 分片预先切好、免再均衡,用极少的元数据服务器撑起极大规模;
- 故障域与容灾考虑周全:纠删码冗余 + 多区域异步复制 + 快照防误删,且强调”至今未丢字节”;
- 硬件无关、依赖极简:TCP/IP、普通本地文件系统落块,不绑定特定硬件或外部服务。
局限(官方自认或隐含):
- 不可变 + 非 POSIX 是硬约束,能用的程序模式被收窄到”顺序写一次”;
- CDC 是已知单点瓶颈(1 万 req/s),目录操作吞吐天花板明显;
- 多区域一致性是异步窗口,不适合要求跨地强一致写的场景;
- 开源版与生产能力有差距:恢复工具、GC、内部运维工具链不随仓库发布,落地要自己补;
- 运维门槛极高,这是给养得起专业存储团队的大型组织准备的。
八、它意味着什么 / 谁该关注
TernFS 的开源在分布式存储圈是个稀缺信号:一家对数据可靠性极度敏感的量化交易公司,把自己 EB 级、跑了多年生产的文件系统放了出来,而且架构思路(预分片免再均衡、不可变文件、纠删码 + 快照)相当克制、可复用。对正在为 AI 训练数据湖发愁、且有专业运维能力的大型团队,它值得放进评估清单。但它不是给中小企业的”开箱即用”方案——不可变语义、非 POSIX、CDC 瓶颈与缺失的内部工具链,都意味着你得真的理解自己在造什么样的基础设施。