systing:Josef Bacik 写的全系统 eBPF 追踪器,把 trace 直接送进 Perfetto
阅读时间: 大约 8 分钟
systing:Josef Bacik 写的全系统 eBPF 追踪器,把 trace 直接送进 Perfetto
Linux 性能分析长期是个「散弹枪」现场:perf 抓 CPU 采样、bcc/bpftrace 写一次性脚本、ftrace 看函数调用,再各自想办法把结果画出来——工具不少,却没有统一的可视化层。systing 是 Btrfs 文件系统维护者 Josef Bacik 用 libbpf(Rust)写的追踪器,思路很直接:用一套探针把全系统事件抓下来,导出成 Perfetto 格式,直接在 Chrome 团队那个成熟的 trace UI 里拖时间轴。本文基于其 GitHub README 做分析。
一、作者与背景
Josef Bacik 是内核社区有名的名字:Btrfs 维护者,早年在 Facebook 做性能与内核工程。由这样的人写 eBPF 工具,和业余爱好者项目的区别在于——他知道真正的性能问题长什么样,也知道内核侧的约束。这也是 Koala 点评里「更有可能长期演进」判断的依据。
systing 用 Rust + libbpf 编写,只在 Linux 上构建,需要先装 bpftool。BPF 对象以 -mcpu=v3 -fwrapv 编译(钉在 build.rs 里),保证本地构建与 release 产物一致。
二、怎么用:从三个子命令收敛到一个
README 提到一个有意思的迭代:早期版本有 system、profile、describe 三个子命令(作者在试验不同的问题定位路径,代码留在 old-systing 分支);当前版本收敛成单个命令:
cargo build
sudo ./target/debug/systing --duration 60
跑 60 秒后,默认生成一个 trace.pb 文件,上传到任意 Perfetto 实例即可在浏览器里分析。符号解析可启用 debuginfod(--enable-debuginfod,指向 Fedora 等 debuginfod 服务器),获得更准确的调用栈。
三、追踪覆盖面:recorder 即开关
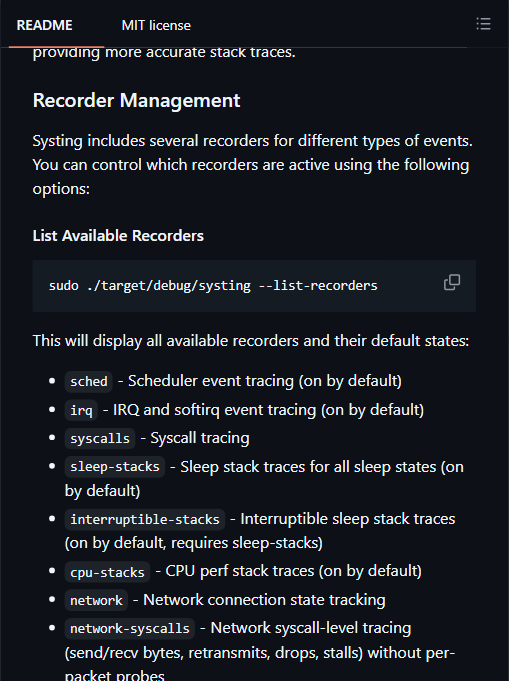
从截图里的 recorder 列表能看到 systing 默认采集哪些事件:
sched—— 调度器事件(默认开);irq—— IRQ 与软中断(默认开);syscalls—— syscall 追踪(默认开);sleep-stacks/interruptible-stacks—— 睡眠栈与可中断睡眠栈(默认开,后者依赖前者);cpu-stacks—— CPU perf 栈(默认开);network—— 网络连接状态追踪;network-syscalls—— 网络 syscall 级追踪(send/recv 字节、重传、丢包、stall,无需包探针)。
外加自定义 USDT probe。也就是说,一个命令同时覆盖了 CPU、调度、锁睡眠、syscall、网络——这正是「全系统追踪」的含义,而不是只看某一类事件。

四、输出格式:不止 Perfetto
systing 按文件后缀选输出格式,这一点很务实:
| 后缀 | 格式 | 用途 |
|---|---|---|
.pb(默认) | Perfetto trace | 浏览器时间轴可视化 |
.duckdb | 可查询的 DuckDB trace 库 | 用 SQL 批量过滤/聚合 trace 数据 |
.systing / .systing.gz | 轻量 profile 导出 | 任何工具都能解析,不依赖 DuckDB |
Perfetto 负责「人眼看」,DuckDB 负责「机器查」——这种把可视化与可编程分析分开的设计,比只吐一个 protobuf 要周到。
五、必须自己接受的门槛(官方口径之外)
它是 root + BPF 工具,不是开箱即用的 GUI。需要
sudo、需要 bpftool、需要内核支持相应 BPF 特性;集成测试都要 root 权限跑。对不熟 eBPF/内核的应用开发者,上手曲线依然陡。只在 Linux、只 x86/特定内核验证。CI 的
bpf-load-shapes工作流在 guest 里按内核(仓库 vmtest 内核 + Container-Optimized OS 固定内核)逐个 gate,这是工程严谨的一面,但也反过来说明:BPF 程序在内核版本间的兼容性是真实痛点,不是换台机器就能跑。「Perfetto 可视化」不等于「自动给答案」。systing 解决的是「把数据采全、画出来」,定位问题仍靠你自己看时间轴、判断调度延迟/锁竞争/网络重传。它是显微镜,不是诊断书。
项目早期:issues 4、PR 6,文档仍在补(详细 options 链接到 docs)。
六、适用与不适用场景
适合: Linux 后端/内核/数据库开发者排查偶发性能问题(调度延迟、锁竞争、网络 stall);想要「一次采集、同时看到 CPU+调度+网络」统一视图的人;已经熟悉 Perfetto、愿意把 eBPF 数据喂进去的团队;需要把 trace 落 DuckDB 做程序化分析的场景。
不适合: Windows/macOS 用户(根本跑不了);只需要简单函数耗时、perf top 就够的场景;没有 root/内核环境的应用层开发者;期待「一键出报告」的人。
七、客观分析:优势与意义
优势: 作者内核级背景带来的工程可信度(CI 按内核 gate BPF 加载);单一命令覆盖全栈事件;输出格式兼顾 Perfetto 可视化与 DuckDB 可编程;把 eBPF 散弹枪式的工具链对接到成熟 trace UI,确实降低了「看异步行为」的门槛。
局限: 仍需 root 与内核知识;仅限 Linux;BPF 跨内核兼容性要靠 CI 兜底;不自动诊断;项目年轻。
systing 的真正意义,是 eBPF 工具链「平民化」的一块拼图:采集侧已经足够强大(libbpf 生态成熟),缺的是把多源事件对齐到一个时间轴、并交给大家都认识的可视化层。Bacik 选择 Perfetto 作为后端,等于站在了 Chrome 团队做 trace UI 的肩膀上。对性能工程师而言,这是一个值得装进工具箱、等下次线上偶发卡顿时拿出来的工具。