Spock:给 PostgreSQL 装上多主(active-active)逻辑复制
阅读时间: 大约 13 分钟
Spock:给 PostgreSQL 装上多主(active-active)逻辑复制
PostgreSQL 原生的流复制是物理主从:一个主节点写,一堆备节点只读,写扩展和就近写入都做不到。要让多个节点同时接受写入、再把改动互相同步回去,就是多主复制(multi-master / active-active)——这正是分布式数据库里出了名难啃的问题,冲突怎么解决、一致性怎么保证都得自己扛。Spock 是 pgEdge 维护的开源扩展,为 PostgreSQL 15、16、17、18、19 提供逻辑多主复制。本文基于其官方文档与 GitHub 仓库(pgEdge/spock),拆解它的机制、官方自标的能力,以及一长串官方自己列出的限制。
一、背景动机:为什么需要多主
典型的主从架构有两个现实痛点:一是写单点,所有写都压在主库,横向扩展只能靠业务分片(sharding),对应用侵入大;二是就近写入,跨地域部署时,每个区域的应用都要把写请求打回远端主库,延迟高。多主的诱惑在于:每个节点都能本地写,再异步/准实时地把变更同步到其他节点。但代价是——两个节点可能同时改同一行,这就是”写冲突”。传统方案要么靠特殊数据类型与编号规则人为规避冲突,要么在冲突发生后按某种规则(如最后写入胜出 LWW)覆盖,往往静默丢更新。Spock 的卖点,是它在 pglogical 之上提供了一套**冲突规避(conflict avoidance)**机制。
二、是什么:基于 pglogical 的 active-active 扩展
按官方文档,“The Spock extension provides multi-master (active-active) replication … and leverages the pgLogical open-source project as a solid foundation.” 也就是说,Spock 不是从零造的复制协议,而是站在 pglogical(PostgreSQL 逻辑解码逻辑复制的开源实现,源自 2ndQuadrant 的技术脉络,与商业多主方案 BDR 同宗)的肩膀上做的企业级多主扩展。它以 PostgreSQL **扩展(extension)形式安装在每个节点上,节点间通过双向订阅(bidirectional subscription)**互发变更,并配套了自动 DDL 复制、只读模式、行级过滤、Snowflake 序列等管理特性。
三、技术机制:双向订阅 + delta-apply
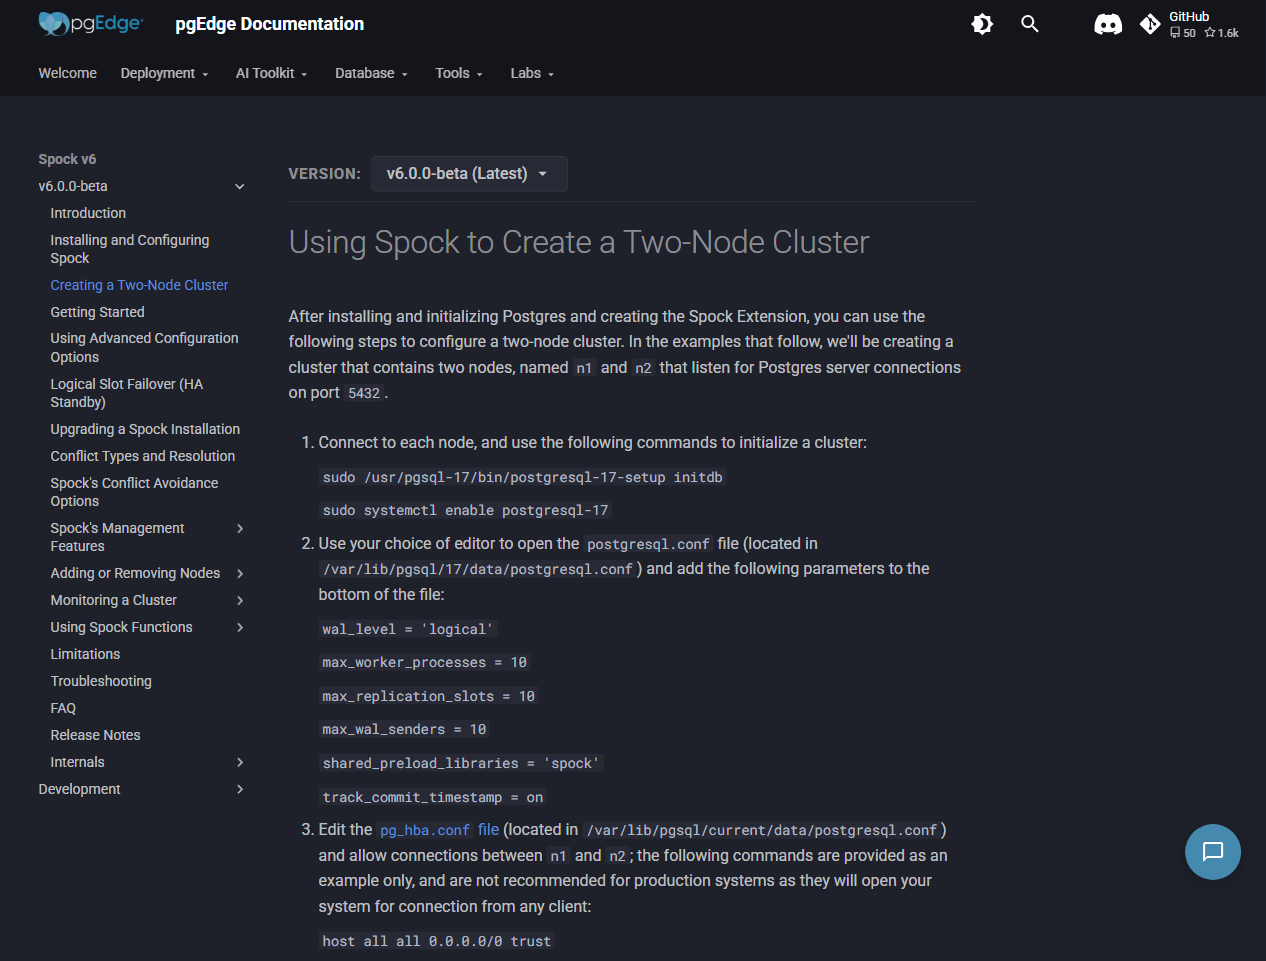
一个两节点 active-active 集群的搭建(官方 getting-started)大致是:两节点都装好 Spock 扩展 → 配置逻辑复制参数 → 在两节点上分别定义节点与双向订阅 → 开启自动 DDL 复制 → 验证双向同步。底层靠逻辑解码从 WAL 中抽出行变更,按复制集(replication set)发布给对端订阅。
真正体现多主难度的是冲突处理。官方文档举了一个银行账户余额的例子:账户余额 $1000,节点 A、B 各自发生一笔 $1000 取款。如果各算各的再覆盖,结果就错了。Spock 的解法是无冲突 delta-apply 列(conflict-free delta-apply):
- 旧值被记录在 WAL 里(
log_old_value=true); - 一个来自对端事务的新值到达;
- 在覆盖旧值之前,用
新值 - 旧值算出增量(delta),再把这个增量正确地叠加到本地值上。
一句话公式就是官方写的 local_value + (new_value - old_value)。把某列设为 delta-apply 列只要:
ALTER TABLE pgbench_accounts ALTER COLUMN abalance
  SET (log_old_value=true, delta_apply_function=spock.delta_apply);
官方称,像 TPC-C 这种高冲突负载,现在能”以闪电般的速度正确运行”。配套地,分布式下的自增 ID 冲突则用 Snowflake 序列(pgEdge/snowflake)来从根上避免各节点序列撞号。
四、关键数据:官方口径
| 项目 | 官方口径 |
|---|---|
| 支持的 PostgreSQL 版本 | 15、16、17、18、19 |
| 架构 | active-active 逻辑多主,每节点可写 |
| 技术底座 | 基于 pglogical 开源项目构建 |
| 部署形态 | 每个节点安装 Spock 扩展,双向订阅 |
| 冲突规避 | delta-apply 列:local_value + (new_value - old_value) |
| 分布式主键 | 推荐 pgEdge Snowflake 序列 |
| DDL 变更 | 自动 DDL 复制 / spock.replicate_ddl |
| 表结构要求 | 各节点表名、schema、列、主键、数据类型必须一致 |
| 管理特性 | 只读模式、行级过滤、分区表复制、大对象(Lolor)、批量插入、滞后追踪 |
五、局限 / 口径:官方自己列的限制
这一节最值得读,因为多主的坑几乎全在官方 Limitations 文档里写明白了:
- 需要超级用户权限来配置与管理复制;
- UNLOGGED 与临时表不复制(和物理流复制一样);
- 一次只能复制一个数据库:同一实例里多个库要分别建 provider/subscriber 关系,不能一键全库复制;
- UPDATE/DELETE 必须有主键或 REPLICA IDENTITY:没有唯一标识,逻辑复制根本找不到要改的行;
REPLICA IDENTITY FULL不能单独用于 UPDATE/DELETE; - 多上游时下游只允许一个唯一索引/约束做冲突判定:冲突解析一次只能用一个索引,若一行满足主键却违反另一个唯一约束,可能直接
ERROR; - 可延迟(deferrable)唯一约束会被静默跳过:INSERT 冲突检测不到,可能在订阅端产生重复行——官方明确建议每张表至少有一个非延迟唯一约束;
- 没有”复制队列刷写”保证:不能冻结主库事务等队列重放完。这意味着改表结构时必须先停写,否则已提交但未复制的事务会因对端表结构不兼容而中断复制;多主场景下光靠
spock.replicate_ddl不够,必须所有节点停写、所有槽追平后再改; - 外键在复制过程中不强制:上游成功的操作会照样应用到下游,即便这会违反外键;
TRUNCATE ... CASCADE只在上游生效;序列状态是周期性而非实时复制,官方强烈建议改用 Snowflake 序列。
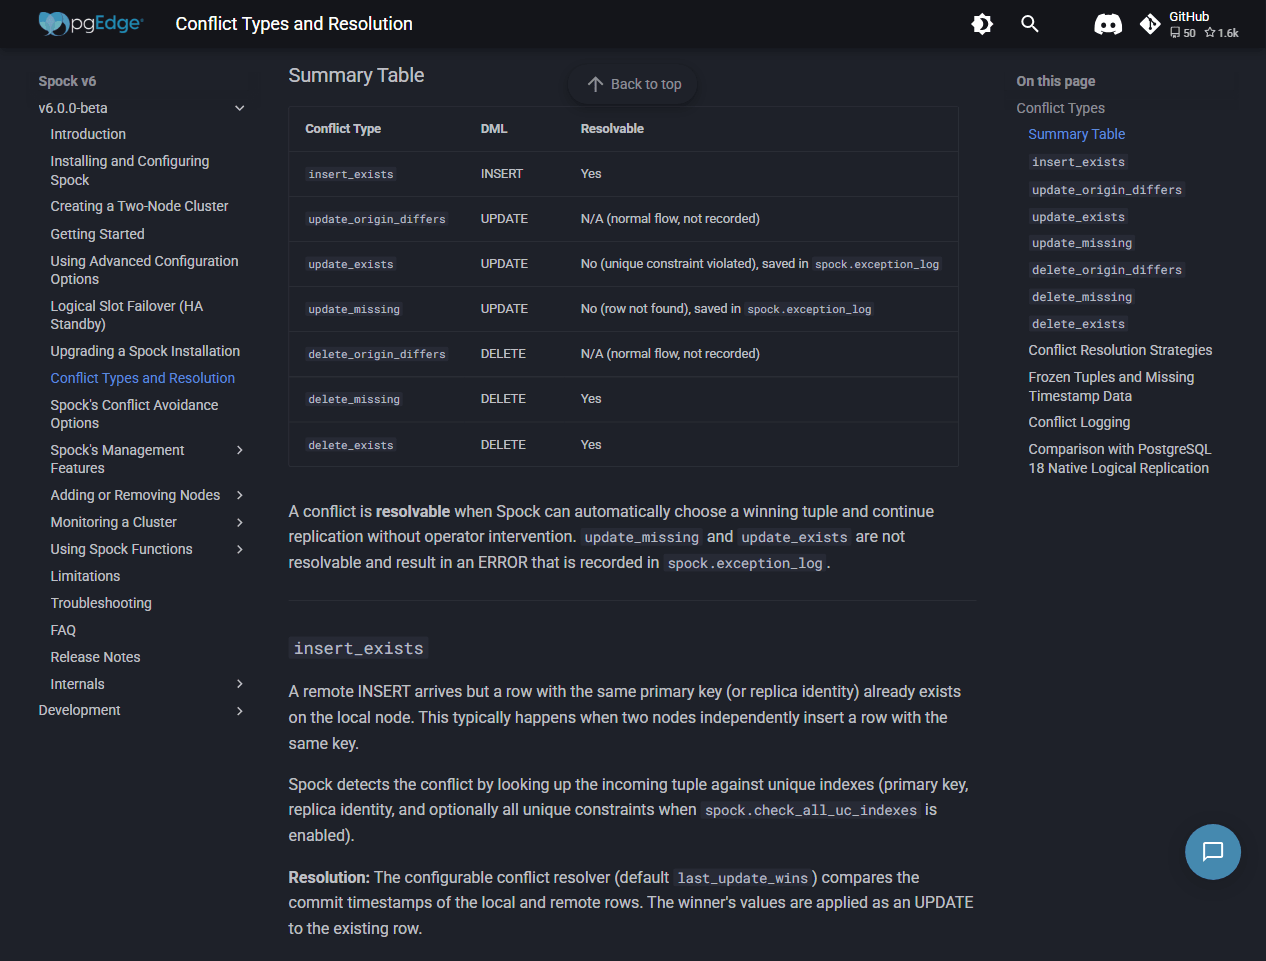
要特别注意”官方称高冲突负载能正确高速运行”这类表述的口径:delta-apply 只对显式配置了该机制的列生效,普通列的并发更新仍受冲突解析规则约束,不是”开了多主就万事大吉”。
六、适用 / 不适用场景
适用: 跨地域就近写入、每个区域都要本地写的多活业务;确实需要 active-active 写扩展、且能接受异步复制与冲突治理成本;能用 Snowflake 序列、能把高冲突计数列配成 delta-apply 的账务/库存类工作负载。
不适用: 只是想做高可用、读扩展的场景——那原生物理主从 + 读写分离更稳更省;对强一致同步写(任何写都要多节点确认)有硬性要求的系统——多主是异步逻辑复制,不提供这种保证; schema 经常漂移、多套唯一约束、大量依赖外键与可延迟约束的既有库——几乎会逐条撞上官方列出的限制。
七、客观分析:优势与局限
优势:
- 真·多写:打破 PG 主从写单点,每个节点可写,适合多活与就近写入;
- 冲突规避有方法论:delta-apply 列针对”余额累加”这类高冲突语义给出了正确解法,而不是简单覆盖;
- 生态配套全:自动 DDL 复制、Snowflake 序列、只读模式、滞后追踪,企业级管理特性比较完整;
- 基于成熟的 pglogical/逻辑解码,不是私有黑盒协议。
局限(官方自认):
- 运维门槛高:需要超级用户、改表要全员停写、冲突规则要预先设计,心智负担远超主从;
- 结构约束苛刻:表结构必须各节点完全一致,多唯一约束、可延迟约束、外键、UNLOGGED 表都有坑;
- 一致性是异步的:多节点同时写存在短暂冲突窗口与数据不一致窗口,不是分布式共识数据库;
- 升级复杂:要在 PG 内核/扩展层维护 Spock,大版本升级还要借助 pglogical2 过渡。
八、它意味着什么 / 谁该关注
Spock 代表了”在 PostgreSQL 生态内用扩展做多主”的路线:不把 PG 改造成一个分布式数据库,而是用逻辑复制 + 冲突治理把多活能力叠加在标准 PG 上。对已经重度依赖 PostgreSQL、又确实有跨地域多写需求的团队,它比引入全新分布式数据库(CockroachDB、Spanner 类)迁移成本低得多。但正如 Koala 点评所说——对大多数应用,主从加读写分离仍是更稳妥的选择;只有当真的需要多活写入、且养得起一支能管理冲突与 DDL 变更的 DBA 团队时,Spock 的复杂度才值得。