slime:Megatron × SGLang 原生的 LLM RL 后训练框架
阅读时间: 大约 9 分钟
slime:Megatron × SGLang 原生的 LLM RL 后训练框架
RL 后训练(post-training)的工程栈向来是个“缝合怪”:训练用 Megatron,推理用 vLLM/SGLang,再加一套数据生成、奖励、verifier,彼此用胶水脚本连起来。slime是 THUDM(智谱)开源的 LLM 后训练框架,它的立场很明确:把这些东西收敛到同一条 training / rollout / Data Buffer 路径上,而不是堆一堆互相不通的 trainer、rollout 服务和 agent 框架。本文基于其官方文档做一手拆解。
一、它是什么、不是什么
官方给 slime 的定位是“面向 RL scaling 的 LLM 后训练框架”,提供两个核心能力:
- 高性能训练:把 Megatron 与 SGLang 对接,支持多种训练模式;
- 灵活的数据生成:通过自定义数据生成接口和基于服务器的引擎,跑任意训练数据生成工作流。
它不是一个开箱即用的“训练一下你的小模型”工具——它是面向前沿模型规模的 RL 基础设施,默认你已经有 Megatron 和 GPU 集群。
二、架构:一条路径,不搞最低公分母
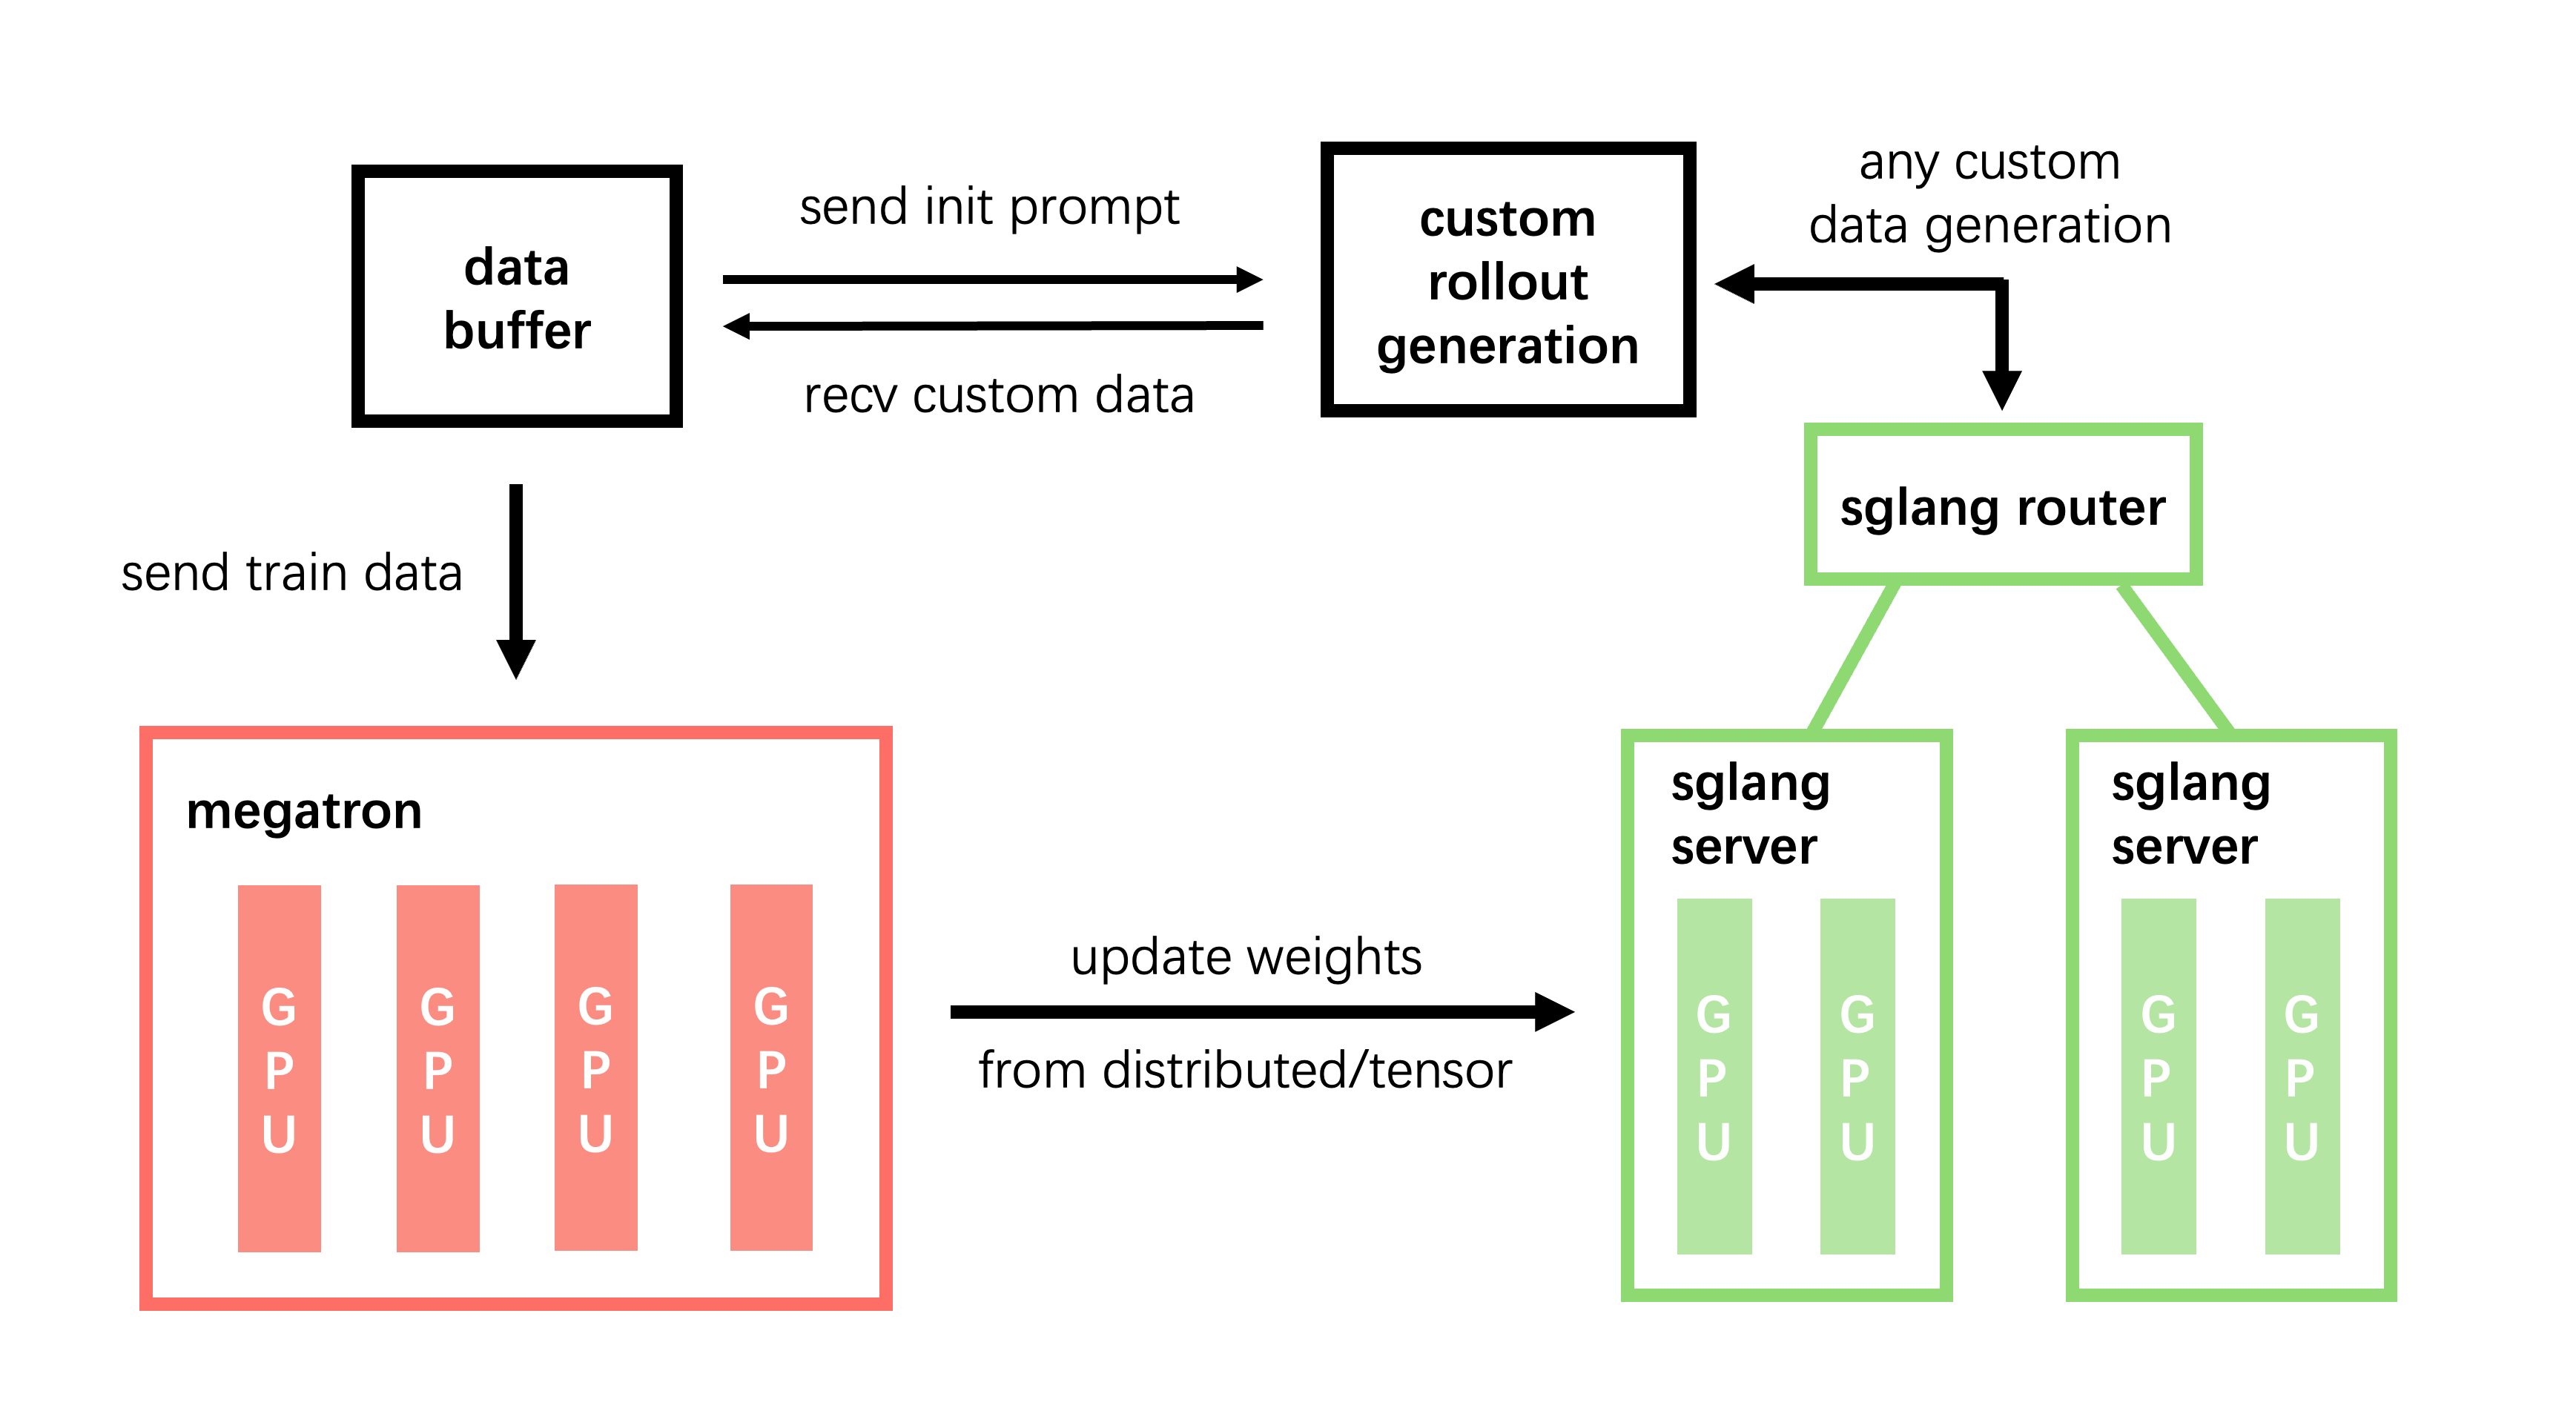
官方架构图的关键拓扑(见上图)是:custom rollout generation 向 data buffer “send init prompt”、从 buffer “recv custom data”;data buffer 再向 megatron “send train data”;megatron 训练完后,把“update weights from distributed/tensor”推给多个 sglang server,中间经 sglang router 分发。也就是说,工具调用、沙箱交互、verifier 奖励、环境反馈、多智能体循环、长程 agentic 工作流,都插进同一条路径,而不是另起一个训练内核。
它做了几个有倾向性的设计选择:
- 原生透传:Megatron 参数直接透传,SGLang 参数用
--sglang-前缀暴露——不包一层抽象,上游训练与推理的优化原样可用。 - 只押 SGLang:官方明确说“刻意只选一个 rollout 后端”,避免把多个推理引擎压成最低公分母,从而能直接用 SGLang 特有的路由、缓存、解耦和权重同步。
- BF16 训练 + FP8 rollout:大 MoE 配方用 Megatron BF16 训练态配 SGLang FP8 推理;长上下文还能开
--sglang-kv-cache-dtype fp8_e4m3提高有效 KV cache 容量。
三、它被谁验证过
官方称 slime 是“最经过实战检验的开源 RL 后训练框架之一”,并列出其背后的模型:
- GLM 家族:GLM-5.2、GLM-5.1、GLM-5、GLM-4.7、GLM-4.6、GLM-4.5。
- 其它支持:Qwen 系列(Qwen3.6/3.5/3Next/3MoE/Qwen3/Qwen2.5)、DeepSeek V3 系列(V3/V3.1/R1)、Llama 3。
四、硬件配方(官方文档给出的参考)
| 规模 | 模型配方 | GPU |
|---|---|---|
| Dense | Qwen3-4B | 8×H100 |
| Dense | GLM4-9B | 8×H100 |
| MoE | GLM-4.7-Flash | 8×H100 |
| MoE | Qwen3-30B-A3B | 8×H100 |
| MoE | GLM-4.7 | 64×H100 |
| MoE | DeepSeek R1 | 128×H100 |
| MoE | GLM-5.2 744B-A40B | 256×H100 |
进阶能力还包括 PD 解耦、字节级增量权重同步(delta weight sync)、straw 持久化 rollout、on-policy 蒸馏、投机解码与容错;可靠性上官方称 CPU 正确性测试自动跑,GPU e2e 测试覆盖 dense/MoE、全异步 rollout、checkpoint、精度与 debug replay。
五、口径批判:哪些是主张
- “最经过实战检验”是自述。它的“实战”主要来自 THUDM 自家的 GLM 系列发布——这是自证:用自己框架训练自己的 SOTA 模型,说明它能跑通前沿规模,但不等于独立第三方已在同等规模复现。
- 只支持 SGLang 是双刃剑。你能吃到 SGLang 专属优化,但若你的团队标准推理栈是 vLLM,就被锁死;官方把“外部 rollout 引擎”列为 roadmap,说明目前并非通用。
- “小到能读懂、又够生产”是营销语。GLM-5.2 744B-A40B 用 256 张 H100 的配方,对绝大多数团队并不“小”;它对研究者友好,对个人开发者并不友好。
- 官方没有给出与其它 RL 框架(如 OpenRLHF、veRL)的吞吐量或 token 成本对照基准,性能优势目前停留在架构叙事层面。
六、优势与局限
优势:Megatron 与 SGLang 原生对接,不做损耗性能的二次包装;同一条路径把 agentic 数据生成、奖励、verifier 反馈纳入训练闭环;FP8 rollout 与 FP8 KV cache 对 MoE 长上下文很务实;有从 4B 到 744B-A40B 的完整硬件配方文档;PD 解耦、增量权重同步、容错等生产级特性齐备。
局限:学习曲线陡峭,需要同时懂 Megatron 训练与 SGLang 推理;rollout 后端绑定 SGLang;门槛是数十到数百张 H100 级别的集群;作为框架它交付的是基础设施,奖励设计、数据质量、业务环境仍要你自己接。
七、谁该关注
- 已经在训 GLM/Qwen/DeepSeek 类大模型、被 Megatron+vLLM 缝合栈的运维成本困扰的团队;
- 想做 agentic RL(工具调用、多智能体长程任务)并需要把环境反馈直接回流训练的研究者;
- 需要 FP8 rollout、PD 解耦、增量权重同步等生产特性的 RL 平台工程师。
对个人开发者或小团队,slime 更值得“读架构”而非“直接跑”——它代表的是前沿 RL 基础设施收敛到“训练与推理同路径”的工程趋势。