SlateDB:把 LSM 树直接盖在对象存储上的嵌入式引擎
阅读时间: 大约 9 分钟
SlateDB:把 LSM 树直接盖在对象存储上的嵌入式引擎
RocksDB/LSM 的世界里,数据最终落在本地 SSD;云原生世界里,最便宜、最耐久的存储是 S3 这类对象存储。SlateDB 想做的事,就是把两者缝起来——一个嵌入式 KV 引擎,SSTable 不写本地盘,直接写对象存储(S3、GCS、ABS、R2、MinIO、Tigris 等)。它是 Rust 编写、Apache 2.0 协议、归属 Commonhaus 基金会的项目,Dropbox、Prisma、TensorLake、Goldsky、Gadget 等已是公开采用方。本文基于 slatedb.io 与 GitHub README,拆解它怎么工作、代价在哪。
一、为什么要”写对象存储”
传统 LSM 引擎把磁盘当一等公民,换来了低延迟,也绑定了单机磁盘容量。SlateDB 的卖点是把”耐久性、一致性、经济性”交给对象存储:
- bottomless 容量:存储随桶扩容,不受单机磁盘限制;
- 高耐久与易复制:S3 本身多副本,天然多可用区;
- 不按请求付磁盘税:对象存储按容量计费远低于本地 SSD 的每 GB 成本。
但官方 README 开门见山写下 trade-off:对象存储延迟更高、API 调用更贵。SlateDB 的全部工程设计,都是在这个前提下做缓冲。
二、技术机制:怎么把 S3 用成磁盘
写路径——为了不被 S3 的 PUT 次数计费打死:
put()只更新内存中的 WAL + MemTable,立刻返回一个WriteHandle;- MemTable 达到阈值后,定期批量 flush 成一个有序字符串表(SST)写到对象存储,flush 间隔可配;
- 想要持久化确认,显式调
handle.await_durable()等这一批落桶,或db.flush()全量刷盘。
也就是说,SlateDB 默认给你的是”内存级写延迟 + 批量落桶”,而不是每写一条一次 S3 PUT。
读路径——为了不被 S3 的 GET 次数与延迟拖垮,它把经典 LSM 缓存手段全用上:内存 block cache、压缩、bloom filter,以及——注意这是重点——本地 SST 磁盘缓存(disk cache)。底层用的是 Rust 生态通用的 object_storecrate,任何实现该 trait 的对象存储都能接。
三、能力清单(README 勾选框口径)
| 能力 | 状态 |
|---|---|
| 基础 get/put/delete、范围扫描 | 已 GA |
| SST 落对象存储、block cache、磁盘缓存、压缩、bloom filter | 已 GA |
| Compaction、Manifest 持久化 | 已 GA |
| 事务(Transactions)、Merge operator、Clones | 已 GA |
| CDC(变更数据捕获)、库 split/merge | 已 GA |
| Range deletions(范围删除) | 未实现 |
绑定语言:Rust 核心,官方维护 Go / Java / Node.js / Python 绑定,.NET、Ruby、TypeScript 有社区 binding。发版节奏约每 2 个月(双月月末),相邻版本间存储格式保证向前/向后兼容。
四、评测与口径偏差:把”零磁盘”读成什么
SlateDB 目前没有给出可对标的 QPS/P99 benchmark(官网与 README 均无性能数字表),这本身就是一条信息:它卖的是架构与成本模型,不是”比 RocksDB 快”。读它的宣传必须注意以下口径偏差:
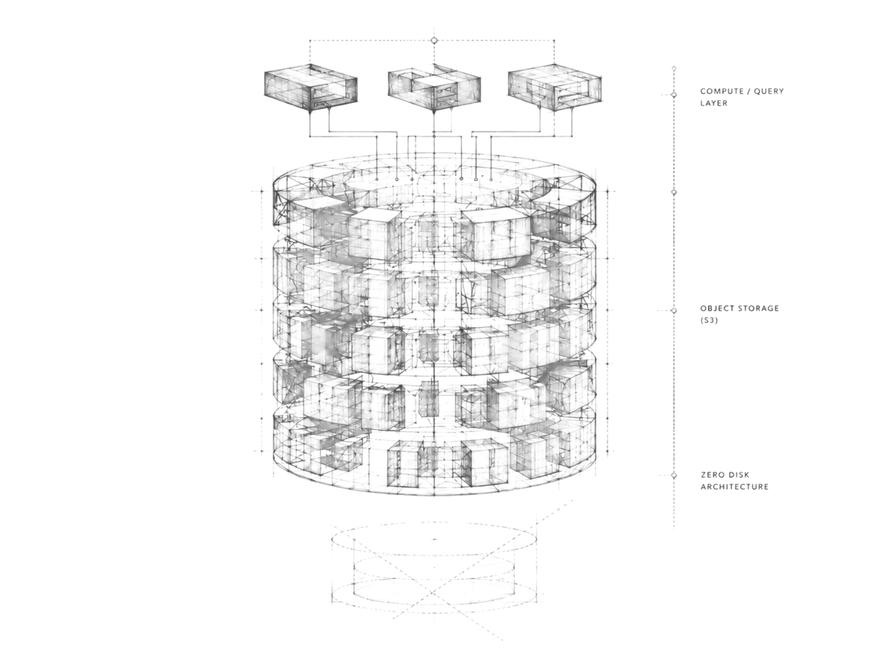
- “Zero disk architecture”是营销,不是字面。官网大图把架构画成计算层直接坐落在 S3 上,但 README 自己列出的读优化里就有”local SST disk cache”——真正跑起来的节点上,本地盘是被用作缓存的,不是完全无盘。准确说法是”持久化层在对象存储”,本地盘只是缓存。
- 写入持久性不是默认同步的。
put()返回只代表进了内存 WAL/MemTable;要 durability 必须await_durable()或flush()。这意味着若进程在 flush 间隔内崩溃,未落桶的写会丢——这是用批量换成本的必然代价,对”每条写都要持久”的事务型负载要格外小心。 - API 成本省不掉,只能摊薄。批处理把 N 次 PUT 压成 1 次 SST PUT,但 compaction、读放大带来的 GET 仍然计费;高频随机读的场景,S3 请求费可能抵消存储费优势。
- API 稳定性官方不保证。README 明说:当前阶段”reserve the right to break compile-time API compatibility”——Rust crate 直接依赖要做好跟版本 breaking change 的准备。
- Range deletions 尚未实现,某些需要高效删除区间(如 TTL 批量清理)的 workload 要先评估替代方案。
五、优势与局限
优势:
- 存算分离的原生形态:状态全在 S3,计算节点无状态、可随便扩缩,对 serverless/边缘部署友好;
- 成本结构:冷数据/超大工作集用 S3 容量价,远低于本地 SSD 常驻;
- 生态位正热:采用方里有数据库产品(Helix-DB、MerkleMap、s2-lite),说明它被当作”别人的存储底座”而不是终端产品;
- Apache 2.0 + 基金会托管,治理与商用友好。
局限:
- 延迟天花板由 S3 决定,不适合亚毫秒在线交互;
- 崩溃窗口内批量写可能丢,durability 语义要靠应用侧 await;
- 功能还在补齐(范围删除缺失);
- Rust API 未冻结,跟版本有成本;
- 无公开基准,性能预期需自测。
六、谁该关注
- 在 S3 上自建低并发 KV/元数据服务的团队:想要对象存储的 durability 又不想自己写 compaction;
- 嵌入式数据库作者:像 Helix-DB、MerkleMap 那样把 SlateDB 当存储底座,省去自己维护 LSM;
- 边缘/Serverless 场景:计算函数无状态、状态落桶,冷启动友好;
- 追求亚毫秒延迟或强事务语义的人:这条赛道请回去用 RocksDB / SQLite,SlateDB 不是为此生的。