shot-scraper:Simon Willison 把网页截图做成了可进 CI 的流水线
阅读时间: 大约 8 分钟
shot-scraper:Simon Willison 把网页截图做成了可进 CI 的流水线
截图听起来是个小需求,但在文档维护、数据监控场景里它高频出现,而且最烦的地方在于:手动截的图会随网页改版悄悄过时。Simon Willison(Datasette 作者)的 shot-scraper 就是把这件事工程化——把截图变成可版本化、可进 CI 的流水线。本文基于其 GitHub README 分析它到底解决了什么。
一、背景:截图为什么是个工程问题
一个文档站点如果有几十张界面截图,靠人手动维护意味着:每次 UI 改一个圆角、调一行间距,截图就过时了。传统做法是”发现不对再截”,结果文档常年和实际界面对不上。shot-scraper 的思路是把截图变成构建产物:需要时由命令自动生成,跑在 CI 里,谁改了页面谁负责刷新截图。
二、它是什么
shot-scraper 是一个基于 Playwright 的命令行工具,README 原文定位:“A CLI utility for taking screenshots of websites, recording video demos and scraping sites using JavaScript”。许可证 Apache-2.0。它能干三件事:
- 给网页截图;
- 录制视频演示;
- 执行 JavaScript 抓取页面数据。
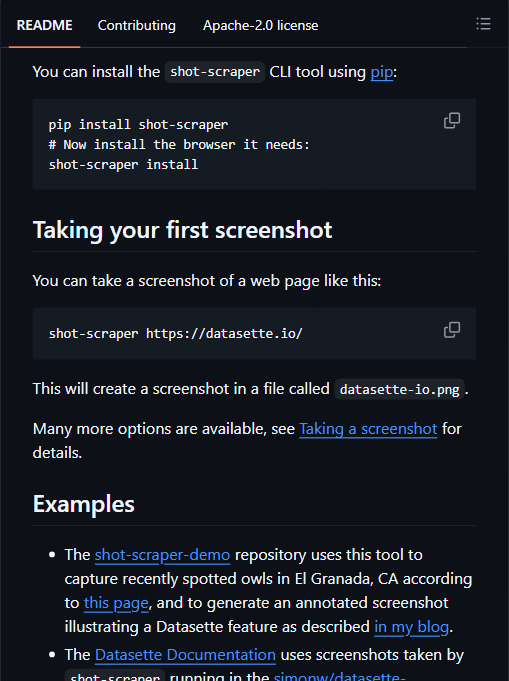
安装极简:pip install shot-scraper,然后 shot-scraper install 把所需的 Playwright 浏览器装上。截一张图只要:
shot-scraper https://datasette.io/就会在当前目录生成 datasette-io.png。
三、关键机制:与 GitHub Actions 结对
shot-scraper 真正的杀手锏不是截图本身,而是它和 CI 的配合。官方提供了一个 shot-scraper-template 模板仓库——你一键就能生成一个属于自己的 GitHub 仓库,开箱即用地定期给指定页面截图。配合 GitHub Actions,就能做到:定时(或在某个事件触发时)自动截图、把新截图提交回仓库、甚至发到社交平台。
README 里列了几个真实在用的案例:
- Datasette 官方文档:所有文档截图都由跑在
simonw/datasette-screenshots仓库里的 shot-scraper 自动生成; - Ben Welsh 的 @newshomepages:一个 Twitter 机器人,用 shot-scraper + GitHub Actions 给各新闻网站首页定时截图并发到 Twitter;
- 路透社(Reuters):用它为邮件通讯生成定期更新的数据仪表板截图。
最后这条尤其有说服力——路透社这种专业机构把它用在生产内容管线里。
四、关键数据与口径
- 许可证:Apache-2.0(已核实)。
- 作者:Simon Willison,Python/CLI 生态知名作者。
- 成熟度:仓库开放 49 个 Issue、11 个 PR,属于维护多年、稳定成熟的小工具;Koala 在周报里提到 GitHub 约 2400 star(以仓库实时数据为准)。
- 依赖:底层是 Playwright,因此天然支持需要 Chromium 渲染的现代页面,而不是简单抓 HTML。
五、官方未强调、但选型要知道的局限
- 它不是通用爬虫框架:虽然能跑 JS 抓数据,但定位是”截图优先、顺带抓数”,大规模、分布式、反爬对抗场景不是它的菜;
- 需要跑浏览器:每次截图都要起一个 Chromium,比纯 HTTP 抓取重,不适合超高并发;
- 截图保真受渲染环境影响:字体、时区、登录态、动画未停等都会影响截出来的图,README 提供了
--wait、选择器等待等参数,但要做到”每次截出来像素级一致”仍需自己调参; - 路透社案例是”用它生成仪表板图”,不等于它有内置图表能力:图本身来自网页,shot-scraper 只负责”把网页画下来”;
- 它解决的是”截图可复现”,不解决”截什么、截完怎么审”——内容审校仍需人介入。
六、适用 / 不适用场景
适合:
- 维护带大量界面截图的开源文档,想让截图随 UI 自动更新;
- 定期监控某个网页/仪表板的视觉变化;
- 做”网页→图片→喂给 LLM”的管道(Simon 自己常把它和 LLM 工具链组合);
- 想零成本搭一个”定时截图发到 Twitter/Mastodon”的机器人。
不适合:
- 需要高并发、大规模数据采集的爬虫项目;
- 需要处理登录墙、验证码、复杂反爬的站点;
- 只想截一张图、用浏览器 F12 就够了的一次性需求。
七、客观分析:优势与局限
优势:
- 把截图工程化:模板仓库 + GitHub Actions,几秒钟就能拉起一条自动截图流水线;
- Playwright 底座可靠:能渲染现代 JS 页面,比旧的无头浏览器方案兼容性好;
- 真实背书:Datasette 文档、路透社、新闻首页机器人都是长期生产用户;
- Simon Willison 的工具一贯小而美、文档齐全、上手极快。
局限:
- 本质是截图工具,不是数据采集平台;
- 起浏览器有性能开销,不适合高频大规模;
- 像素级可复现需要自行调参;
- 无内置的差异比对/告警(需自己组合 GitHub 提交、diff 工具)。
八、它意味着什么
shot-scraper 代表了一种被低估的工程实践:把”截图”从一个手工动作,变成一条可版本化、可审查、可复现的构建流水线。在 LLM 时代,它还额外有个用处——网页内容截图后直接喂给多模态模型,比解析 HTML 省事得多。Simon Willison 擅长的正是这种”小而准”的工具:不贪大,只把一个高频痛点做到极致。对维护文档或做视觉监控的团队,它是那种”装上就再也回不去手动截图”的工具。