Raggo:给 Go 开发者的轻量级 RAG 库
阅读时间: 大约 10 分钟
Raggo:给 Go 开发者的轻量级 RAG 库
Python 与 JavaScript 生态里,RAG 框架一抓一大把;但在 Go 后端世界里,能开箱即用的 RAG 库一直稀缺。Raggo 就是冲着这个空白来的——一个用 Go 写的、把 RAG 核心组件抽象成可组合积木的库。它的目标不是做最复杂的框架,而是让 Go 工程师用最少的代码把「文档加载→切分→向量化→检索→生成」这条链路跑起来。本文基于其 GitHub 仓库 README 的一手代码与配置说明做分析。
一、它解决的痛点
Go 在后端服务、微服务、高并发网关里是主力语言,但 AI 应用层过去几乎被 Python 独占。一个 Go 团队如果想给自家服务加上「基于内部文档问答」的能力,往往要要么单独起一个 Python 微服务、要么自己手搓一套切分与向量检索逻辑。Raggo 的价值就在于:让 Go 进程在进程内直接完成 RAG,而不必跨语言、跨服务地拼装。
二、核心组件:可组合的积木
Raggo 把 RAG 拆成五个独立、可单独使用也可组合的组件,每个都有显式的构造函数:
| 组件 | 作用 | 典型调用 |
|---|---|---|
| Loader | 加载本地目录 / URL / PDF | raggo.NewLoader(...)、LoadURL(ctx, url) |
| Parser | 解析文档内容 | raggo.NewParser()、Parse("doc.pdf") |
| Chunker | 文本切分 | raggo.NewChunker(raggo.ChunkSize(100)) |
| Embedder | 生成向量 | raggo.NewEmbedder(SetProvider("openai"), SetModel("text-embedding-3-small")) |
| VectorDB | 向量存储 | raggo.NewVectorDB(raggo.WithMilvus("collection")) |
这种「每个环节都可替换」的设计是它与「黑盒一站式框架」最大的不同:你可以只借用它的切分器,也可以换掉它默认的 Milvus 向量库换成别的实现。配置则支持三种来源叠加——环境变量(RAGGO_PROVIDER、RAGGO_MODEL、RAGGO_COLLECTION、RAGGO_API_KEY)、JSON 文件、以及编程式默认值,环境变量优先级最高。
三、三种内置 RAG 策略
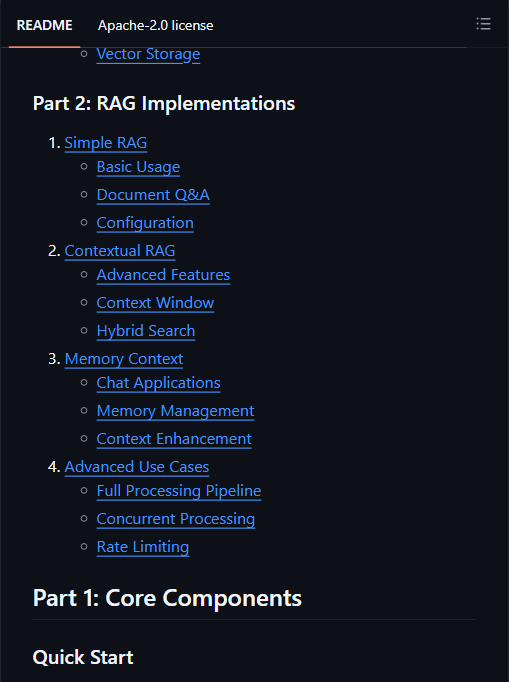
Raggo 在「积木」之上封装了三套面向不同场景的现成实现:
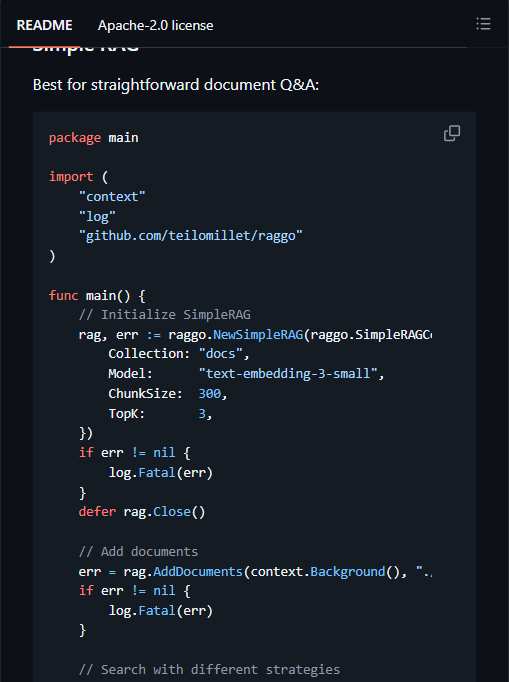
- Simple RAG:最直白的文档问答。初始化
NewSimpleRAG,AddDocuments(dir)喂文档,Search(query)取答案。支持普通检索与SearchHybrid(混合检索,带相似度阈值,如 0.7)。适合 straightforward 的 Q&A。 - Contextual RAG:面向复杂文档理解。它在写入时为每个 chunk 自动生成一段「富上下文(rich context)」,再带着上下文一起存进向量库——这正是受 Anthropic 「Contextual Retrieval」思路影响的做法。官方示例里用
gpt-4o-mini来生成每段的上下文,chunk 设为 300、重叠 75(25%),TopK 5、MinScore 0.7,以换取更完整的上下文。 - Memory Context:面向聊天应用与长期记忆。
NewMemoryContext可取MemoryTopK(5)、MemoryStoreLastN(100)、MemoryMinScore(0.7)等参数;它与作者的另一个 Go 库 gollm 的MemoryMessage/Prompt类型打通,能把对话历史存进记忆、再把「增强过的 prompt」喂给 Contextual RAG 检索。
默认参数(chunk 300、overlap 50、TopK 5、minScore 0.7、embedding 用 text-embedding-3-small)是一组比较保守、适合中文/英文通用文档的起步值。
四、工程化:并发与限流
Raggo 没有停留在 demo 层面,README 的「Full Processing Pipeline」一节直接给了一个处理大批量 PDF 的模板:用 golang.org/x/time/rate 做 RPM/TPM 限流器(示例常量 GPT_RPM_LIMIT=5000、TPM=4000000),用带缓冲的 channel 做并发信号量(示例 MAX_CONCURRENT=10),goroutine 里依次 Parse→Chunk→Embed。这套写法对 Go 开发者非常顺手——它没有发明新的并发模型,而是直接复用 Go 标准库习惯。这也是它相比 Python 框架在批量处理上的天然优势。
五、口径与局限:要清醒看待
必须指出几点现实,避免被「production-ready」的标语带偏:
- 项目活跃度有限:仓库 100% 由 Go 写成,但贡献者只有 2 位(作者本人 + dependabot),Release 标签约 8 个,文件最后提交多在一到两年前。它更像一个「个人/小团队维护的实用库」,而非有公司背书、长期高频迭代的项目;
- 向量存储绑定 Milvus:示例与默认指向 Milvus,虽然架构上可换,但开箱即用的其他向量后端在 README 里着墨不多;
- 依赖外部 Embedding / LLM:默认走 OpenAI 的 embedding 与
gpt-4o-mini,国内网络与自部署模型场景需要自行替换 provider; - 许可证表述不一致:仓库顶部徽章标注 Apache-2.0,而 README 文末写的是 MIT——二者都是宽松许可,但落地时建议以仓库实际
LICENSE文件为准; - 没有公开的检索质量基准:README 给了代码与参数,却没有给任何召回率、延迟、成本的实测数字,「轻量」「好用」属于主观定位,不是可核对的性能结论。
六、适用与不适用
适合:
- 已经用 Go 写后端、想在进程内加文档问答、不愿额外引入 Python 服务的团队;
- 需要批量、并发、带限流地处理大量 PDF / 文档的离线索引任务;
- 学习 RAG 各环节(加载/解析/切分/嵌入/检索)如何拼装的 Go 开发者——组件划分清晰,很适合读源码。
不适合:
- 想要开箱即用、带托管 UI、可视化调参的团队——这只是一个库,不是平台;
- 生产关键、且要求上游长期维护与安全响应的系统——低活跃度是真实风险;
- 需要复杂混合检索(BM25 + 向量 + rerank)、权限过滤、多模态的高级 RAG——Raggo 提供了基础的 hybrid search,但深度能力有限。
七、它意味着什么
Raggo 的意义不在于「又一个 RAG 框架」,而在于它填补了 Go 生态的一块空白:让 RAG 这种原本 Python 味很浓的能力,可以用 Go 的工程范式(goroutine、channel、标准库限流器)自然地落地。对 Go 后端团队,它是一个值得一读、可用作起点的库;但鉴于其维护活跃度,把它用于关键生产前,最好有能力自行 fork 并维护。