PRQL:用"管道"思想重写 SQL 的现代化查询语言
阅读时间: 大约 11 分钟
PRQL:用”管道”思想重写 SQL 的现代化查询语言
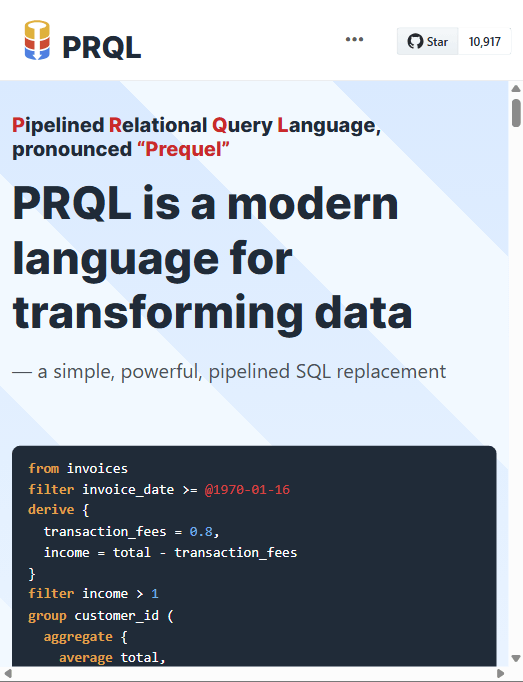
SQL 是事实上的数据库查询标准,但它的语法也长期被吐槽:SELECT ... FROM ... WHERE ... GROUP BY ... HAVING ... ORDER BY ... 是一套固定顺序的声明式骨架,写多层嵌套子查询时可读性骤降,WHERE 与 HAVING 的分工、列别名不能在 WHERE 里引用等”历史债务”几乎每个数据工程师都踩过。PRQL(Pipelined Relational Query Language,读作 “Prequel”)就是冲着这些痛点来的:它是一门用 Rust 编写的现代化数据转换语言,把查询组织成一条线性管道,最终编译成 SQL,因此可以跑在任何支持 SQL 的数据库上。本文基于 prql-lang.org 与 GitHub 官方仓库,梳理它的设计机制与真实成熟度。
一、背景动机:SQL 的债务从哪来
SQL 诞生于 1970 年代,其关键字顺序是为了接近英语阅读而设计的,却并不对应数据处理的真实顺序——实际执行是 FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY,而书写顺序却是 SELECT 在前。这导致两个经典问题:一是列别名(在 SELECT 里定义)不能在同层的 WHERE/GROUP BY 里直接用;二是嵌套子查询会让”先过滤、再聚合、再排序”的数据流被拆散到多处。PRQL 的主张是:既然数据处理本质上是一条条变换串起来的管道,那语言就应该长成管道的样子。
二、是什么:概念与定位
按官方定义,PRQL 是 “a simple, powerful, pipelined SQL replacement”。它像 SQL 一样可读、显式、声明式,但把查询组织成逻辑管道,并支持变量、函数等抽象。关键点是:PRQL 不是一个新的查询引擎,它编译器把 PRQL 转成目标数据库方言的 SQL,再交给真正的数据库执行。因此它数据库无关、能复用现有 SQL 工具与驱动。
项目以 Apache-2.0 协议开源,编译器用 Rust 编写,GitHub 星标约 10.9k;官方明确承诺”永远完全开源、不会有商业产品”。
三、技术机制:线性管道 + 正交算子
PRQL 的核心语法是”每行一个变换”。官方 README 里的例子:
from employees
filter start_date > @2021-01-01               # 清晰的日期字面量
derive {                                      # derive 新增列/变量
  gross_salary = salary + (tax ?? 0),         # ?? 简洁的 coalesce
  gross_cost = gross_salary + benefits_cost,  # 变量可引用其它变量
}
filter gross_cost > 0
group {title, country} (                      # group 对每个分组跑一段管道
  aggregate {
    average gross_salary,
    sum_gross_cost = sum gross_cost,          # = 起别名
  }
)
filter sum_gross_cost > 100_000               # filter 同时取代 WHERE 与 HAVING
derive id = f"{title}_{country}"             # Python 风格 f-string
derive country_code = s"LEFT(country, 2)"    # s-string 作为 SQL 逃生舱
sort {sum_gross_cost, -country}               # -country 表示降序
take 1..20                                    # 区间表达式
几个设计要点:
- Pipelined(管道化):
from之后每行都对上一行结果做变换,阅读顺序即数据流向,没有嵌套子查询; - filter 统一 WHERE 与 HAVING:聚合前后的过滤都用
filter,编译器根据位置自动决定下推到 WHERE 还是 HAVING; - derive 里的变量可互相引用:解决了 SQL 里列别名不能复用的老问题;
- 现代字面量:日期
@2021-01-01、区间1..20、Python 风格 f-string、??空值合并; - 正交算子:官方强调只提供少量、正交的原语,“每个操作只有一种写法”,避免 SQL 多年累积的多种等价写法;
- S-string 逃生舱:
s"LEFT(country, 2)"可以直接嵌入原生 SQL——当 PRQL 暂时表达不了时,不必放弃整条查询。
编译产物就是普通 SQL,官方首页展示了 from employees select {id, first_name, age} sort age take 10 会被编译成标准的 SELECT id, first_name, age FROM employees ORDER BY age LIMIT 10。PRQL 支持多种数据库方言,并提供主流语言绑定、VS Code 扩展与 Jupyter 集成。
四、关键数据与生态
| 维度 | 官方口径 |
|---|---|
| 定位 | 管道式 SQL 替代语言,编译为 SQL |
| 编译器语言 | Rust |
| 协议 | Apache-2.0 |
| 执行方式 | 不自带引擎,编译成目标方言 SQL 后交给数据库 |
| 数据库支持 | 数据库无关,编译到多种 SQL 方言 |
| 语言绑定 | 官方称覆盖大多数主流语言 |
| 工具集成 | VS Code 扩展、Jupyter、QStudio 等 |
| 商业版 | 官方承诺永远不做商业产品 |
五、成熟度批判:官方自己写下的”别急着全员上”
这部分是 PRQL 最需要打折听宣传的地方。GitHub README 在 “Current Status - July 2026” 一节里相当坦诚:
- 目前只适合”勇敢者”(the intrepid):官方原话是”PRQL still has some bugs and some missing features”,并且大概只能给非技术团队跑相当简单的查询。
- 很多招牌特性还在”进行中”:官网 Why PRQL 里提到的类型检查、自动补全、友好报错、列血缘(column lineage),后缀都标着 “in progress”——它们是方向,不是现状。
- 开发节奏正在放缓:官方直言团队正在酝酿一个新的 resolver(解析器)重构,以便修掉大量 bug、降低编译器复杂度;在重构方案敲定前,特性推进变慢。也就是说,今天用 PRQL 可能会踩到一些”已知但还没修”的坑。
- 编译器贡献集中:虽然社区贡献者不少,但编译器核心贡献很集中,团队在主动邀请更大幅度的 resolver 重写。
- 它不能替代 SQL 的全部:遇到 PRQL 还不支持的写法,仍要靠 s-string 手写 SQL;窗口函数在 window 变换之外怎么处理,官方自己列为”初始决策是否正确”的开放问题。
六、适用 / 不适用场景
适合:
- 数据工程师/分析工程师日常写大量中等复杂度聚合查询,受够了嵌套子查询;
- 想在团队里统一查询风格、让查询可读可 review;
- 愿意跟进一个快速演进的开源项目,能接受用 s-string 兜底。
不适合 / 需谨慎:
- 让完全不懂 SQL 的业务方直接写生产查询——官方明确说非技术团队只适合简单查询;
- 对稳定性要求极高、不能容忍编译器 bug 的核心报表链路;
- 指望它替代数据库本身或做执行引擎——它只是 SQL 的”前端语法层”。
七、客观分析:优势与局限
优势:
- 管道心智模型非常贴合数据流向,可读性显著优于嵌套 SQL;
- 编译成 SQL、数据库无关,迁移成本低、可随时回退到原生 SQL(s-string);
- Rust 编写的编译器,性能与可嵌入性好,语言绑定生态在扩;
- 永久开源、无商业版的承诺,降低了长期锁定顾虑。
局限:
- 成熟度有限:bug 与缺失功能仍在,官方自评只适合勇敢者与简单查询;
- 类型检查/自动补全/列血缘等卖点尚未完成;
- 处于 resolver 重构期,接口与行为可能变动;
- 仍需 SQL 作为兜底,学习它的前提是你已经懂 SQL。
八、它意味着什么 / 谁该关注
PRQL 代表了”在 SQL 之上做语法改良”的一条务实路线:不推翻 SQL 的生态地位,而是用一层编译器把人写得舒服、机器照样能接到任意数据库。它的设计哲学(正交算子、线性管道、逃生舱)值得每个写 SQL 的人参考——哪怕你最终不切换,这些思想也能反过来让你写更干净的 SQL。但在 2026 年中的节点,更理性的姿势是:在个人或非关键的分析查询里试用 PRQL,把它当”SQL 语法糖 + 代码生成器”看待,而不是把整条生产数仓迁移上去;等官方新 resolver 落地、类型检查与列血缘完成后,再评估规模化采用。