Polars:Rust 写的 DataFrame 引擎,如何把 Spark 按在单机上
阅读时间: 大约 11 分钟
Polars:Rust 写的 DataFrame 引擎,如何把 Spark 按在单机上
在 Python 数据圈,pandas 的”内存塞不下、多核吃不满”老毛病已经被吐槽了十年。Polars 给出的答案是:用 Rust 从零写一个列式查询引擎,底层站在 Apache Arrow 上,把向量化(SIMD)、多线程和查询优化器一次性补齐。2024 年 7 月 Polars 1.0 发布,2025 年 9 月公司完成 1800 万欧元 A 轮融资并推出 Polars Cloud,2026 年 6 月官方首次公布分布式引擎对 Spark 的基准。本文基于 Polars README 与官方 benchmark 博客,梳理它到底快在哪、数字怎么读。
一、它是什么
README 自己的定位是”Extremely fast Query Engine for DataFrames”——不是又一个 DataFrame 库,而是一个分析型查询引擎,DataFrame 只是它对外的 API 形态。核心特性(官方清单):
- Rust 编写,多线程 + 向量化(SIMD)执行;
- Lazy 与 Eager 两种执行模式,Lazy 模式自带查询优化;
- 流式引擎(streaming):处理装不进内存的数据集,官方举例”在笔记本上处理 250GB 数据集”;
- 表达式 API,可组合复杂查询;
- 插件机制(I/O plugin / Expression plugin)原生扩展;
- 多语言绑定:Python、Rust、Node.js、R、SQL;
- 可选 NVIDIA GPU 加速;
- 列式格式用 Apache Arrow,零拷贝交换。
授权 MIT。安装就是 pip install polars。一个值得记下的工程细节:当你预期数据行数超过 2^32(约 42 亿行),或者跑在 2011 年以前的老 CPU、Apple Silicon 上的 Rosetta x86-64 Python 时,官方要求改用特殊构建——默认二进制按现代 CPU(含 AVX2)优化,老 CPU 要 LTS_CPU=1。
二、查询长什么样
Polars 的灵魂是表达式 + LazyFrame:
df = (
    pl.scan_parquet("orders.parquet")
    .filter(pl.col("status") == "shipped")
    .group_by("customer_id")
    .agg(
        pl.col("amount").sum().alias("total"),
        pl.len().alias("n_orders"),
    )
    .sort("total", descending=True)
    .collect()
)
scan_parquet 是惰性的:直到 .collect() 才真正执行,优化器有机会做谓词下推、投影下推、公共子表达式消除等。流式引擎则用 collect(engine='streaming') 开启。
三、关键数据:官方 PDS-H 基准怎么测的
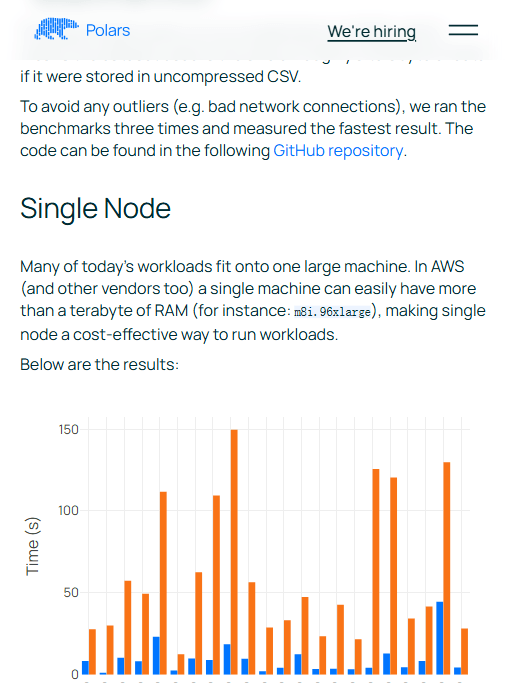
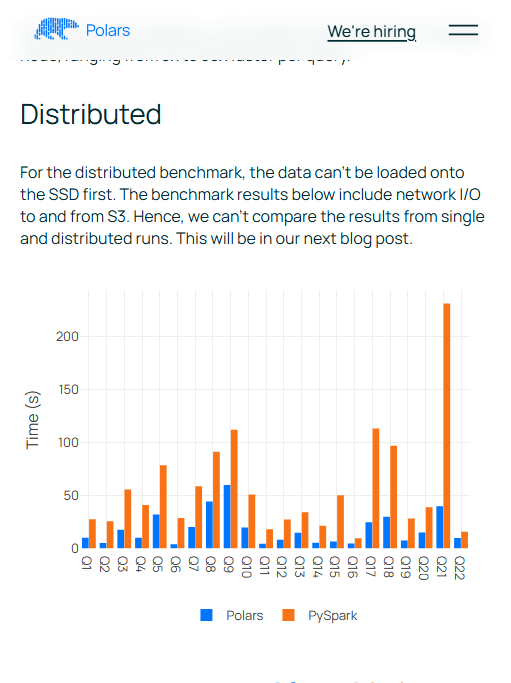
2026 年 6 月 16 日,Polars 官方博客发布”Benchmarking Polars and Spark”,这是其分布式引擎的首次公开对比。配置与结果如下(全部官方口径):
| 项目 | 单机(Single Node) | 分布式(Distributed) |
|---|---|---|
| 硬件 | m8id.32xlarge:128 vCPU / 512GB RAM / 2.7TB SSD | 32 × m8id.xlarge:每台 4 vCPU / 16GB / 240GB,总算力与单机相同 |
| 软件 | Polars 1.41.1、Polars-cloud 0.8.0、PySpark 4.0.1 | 同左 |
| 数据集 | PDS-H,scale factor 1000(约 1TB 未压缩 CSV 等价) | 同左 |
| 总耗时 | Polars 208.6s vs PySpark 1343.8s | Polars 393.4s vs PySpark 1255.1s |
| 几何平均 | 6.56s vs 48.92s | 13.03s vs 42.97s |
| 整体倍率 | 6.44x 快于 PySpark | 3.19x 快于 PySpark |
| 单查询区间 | 3x – 38x | 1.6x – 7.7x |
四、评测方法批判:这些数字该怎么打折
这组数字很漂亮,但读之前必须把官方自己写下的方法学限制逐条摆出来:
- PDS-H 不是认证 TPC-H。官方原文:“While PDS-H closely follows the TPC-H specification, it is not an officially audited or certified TPC-H benchmark… results are intended for comparative evaluation within PDS-H and are not directly comparable to published TPC-H benchmark results.” 也就是说,只能在 PDS-H 内部比,不能拿它去对标市面上任何 TPC-H 官方报告。
- 取的是最快一次,不是中位数。官方明说”ran the benchmarks three times and measured the fastest result”。取 fastest-of-3 对波动更小的一方天然有利,工程上更稳健的做法是报中位数。
- 这是厂商自测。Polars 团队选了 PySpark 4.0.1、选了 m8id 实例、选了 SF1000,代码虽开源但调参空间仍在自己手里。
- 单机与分布式结果不可比——这是官方自己说的。分布式场景数据先落不上 SSD,结果里包含到 S3 的网络 I/O,官方明言”We can’t compare the results from single and distributed runs”。所以别用”单机 6.4x、分布式 3.2x”推出”分布式变慢了”,两件事测的根本不是一个东西。
- “250GB 数据集跑在笔记本上”是流式营销话术。流式 = 落盘换内存,省内存的代价是磁盘吞吐与时延;它解决的是”能不能跑完”,不是”跑得多快”。
五、口径偏差与局限
- GPU 加速是 NVIDIA 专属、可选。与 NVIDIA RAPIDS 合作,2025 年 6 月又加了 UVM(Unified Virtual Memory)让大于显存的数据也能上 GPU——但这不是开箱即用,AMD/Apple Silicon 用户与”pip install polars”的默认路径无关。
- 商业与开源的边界:核心引擎 MIT 开源,但横向扩展、Polars Cloud 查询分析器、托管集群是公司商业化方向(A 轮 1800 万欧即为此)。想要”在集群上跑 Polars”的完整体验, increasingly 需要走进 Polars Cloud。
- 生态仍在追赶 pandas:表达式 API 强大但学习曲线陡;一些 pandas 的便利封装(尤其时序、第三方库互操作)仍有 gap。
- 版本迭代极快(历史上周更),breaking changes 需要跟进 upgrade guide。
六、优势与适用人群
优势:
- 单机多核扩展性接近线性,pandas 用户几乎无痛迁移且内存占用大降;
- Lazy 优化器 + Arrow 零拷贝,是”换库不换思路”的典型;
- 流式与 GPU 给”单机扛不住”留了两条官方出路;
- MIT 协议、多语言绑定,工程友好。
谁该用:
- pandas 写得喘不过气的人:内存吃紧、多核没用上,迁移收益最直接;
- 想拆掉小 Spark 集群的团队:单机 128 vCPU 的大内存机型常比小集群划算,官方案例(Decathlon 用 Polars 替换部分 Spark 负载降本、Check Technologies 省 25% 云账单、DB Systel 近 20x 加速)都印证这条路径;
- Rust 生态的数据工程师:直接用 Rust crate 嵌入服务;
- 想要认证 TPC-H 数字做采购决策的人:本博客这组 PDS-H 数字不能直接进招标材料。