Pogocache:从零写起的低延迟缓存,用分片哈希表挑战 Redis 阵营
阅读时间: 大约 11 分钟
Pogocache:从零写起的低延迟缓存,用分片哈希表挑战 Redis 阵营
缓存层是互联网系统里被打磨得最久的一层:Redis、Valkey、Memcached、Dragonfly、微软 Garnet 各有拥趸。2025 年 7 月出现的新选手 Pogocache(Polypoint Labs 出品,C 语言从零编写,GitHub pogocache/pogocache)把卖点压在三件事上:更低的每请求延迟、更少的每请求 CPU cycles、更省事的接入——同一端口同时说 HTTP、Memcache、RESP(Valkey/Redis)与 Postgres 四种线协议。本文基于官方 README、官方自测图表与配套的 tidwall/cache-benchmarks 基准仓库做客观拆解,重点说清哪些数字是官方自测、哪些是独立复现,以及它现在还不能替代 Redis 的地方。
一、背景:缓存层为什么还有新玩家
Redis 生态强大但包袱也重:单线程演进、复杂数据结构、持久化与集群带来的开销。Dragonfly、Garnet 已经证明”用多核模型重写 Redis 协议”能拿到更高吞吐;Pogocache 走得更彻底——不兼容 Redis 的完整数据结构,只做键值存取,但把 GET/SET 这类热路径做到极致,并额外提供可编译进 C 程序的嵌入式单体文件 pogocache.c。仓库创建于 2025-07-21;截至本文调研(2026-10-17)GitHub API 显示约 2,500 stars,MIT 许可。
二、它是什么
Pogocache 是一个服务器形态(也可嵌入式编译)的键值缓存,默认监听 9401 端口。官方定位三句话:Faster(比 Memcache、Valkey、Redis、Dragonfly、Garnet 延迟更低)、Cheaper(每请求 CPU cycles 最少)、Easier(四种线协议复用现有客户端与 curl/psql 等系统工具)。嵌入式模式下官方称”raw speed,超过 100M ops/sec”,因为绕过网络直接在进程内访问。
三、技术机制
分片哈希表(sharded hashmap):默认 4096 个分片,启动时按核数自动调整,可用 --shards 修改。每个分片是独立的开放寻址(open addressing)Robin Hood 哈希表;桶仅 10 字节(1 字节距离 dib、3 字节哈希、6 字节指针),每个条目一次堆分配,键用自定义 sixpack 压缩(每键 6 bit/字节而非 8 bit)。64 位哈希的高 32 位选分片、低 32 位进本分片哈希表,哈希函数为 tidwall/th64,启动时生成密码学随机种子。分片操作期间用轻量自旋锁锁定。
网络模型:每线程一个事件队列(Linux epoll / macOS kqueue),连接按轮询绑定到队列;Linux 上默认启用 io_uring 做读写批量(可关闭)。
过期与淘汰:条目可带 TTL;低内存时用 2-random(两随机采样)算法淘汰旧条目立即腾空;过期条目的回收由后台周期性 sweep 完成,官方称被淘汰条目占用不超过总缓存内存的 10%。
协议层:HTTP 用 PUT/GET/DELETE;Memcache 文本协议(set/add/replace/append/prepend/cas/get/gets/delete/incr/decr/flush_all);RESP 子集(SET/GET/DEL/MGET/TTL/EXPIRE/EXISTS/FLUSH/KEYS/PING/APPEND/AUTH/SAVE/LOAD 等);Postgres 协议下用 SET/GET/DEL 语句,支持 ::text/::bytea 切换与参数化查询。安全侧提供 --auth 口令与 TLS 证书配置。
四、关键数据:官方自测口径
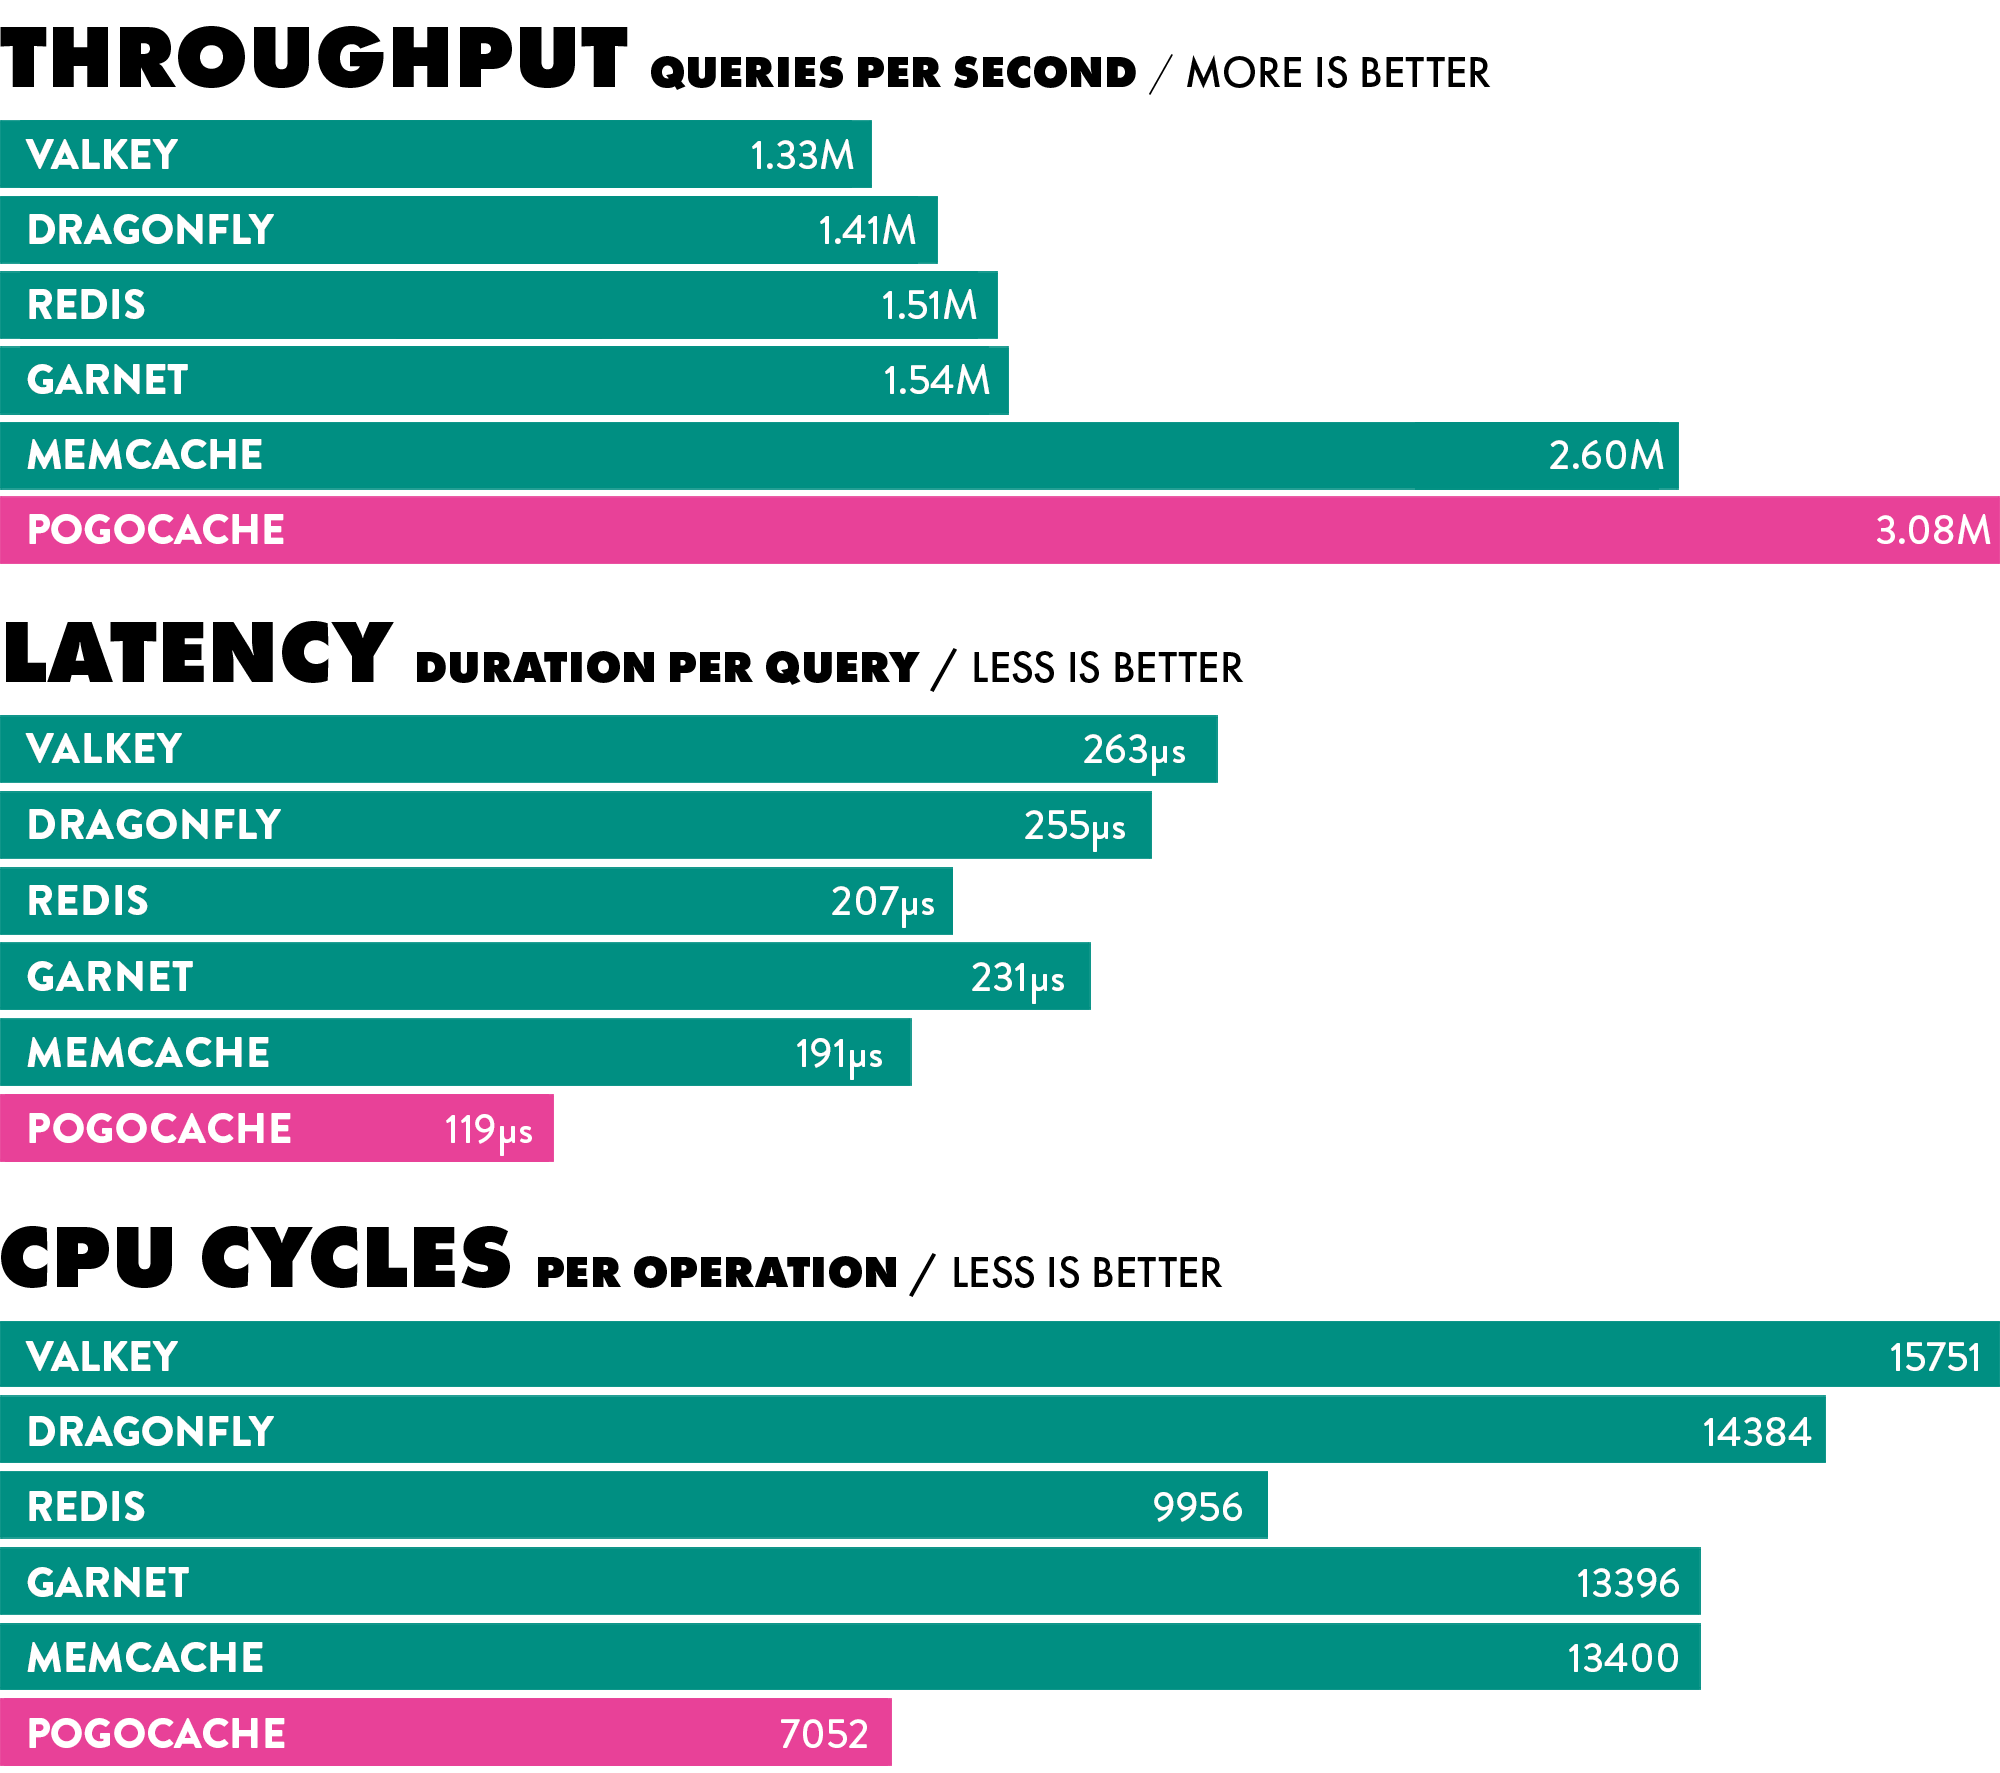
官方图表(首图)在 8 线程、AWS c8g.8xlarge 上测得(官方自测,非第三方复现):
| 软件 | 吞吐(QPS) | 单查询延迟 | 每操作 CPU cycles |
|---|---|---|---|
| Valkey | 1.33M | 263µs | 15,751 |
| Dragonfly | 1.41M | 255µs | 14,384 |
| Redis | 1.51M | 207µs | 9,956 |
| Garnet | 1.54M | 231µs | 13,396 |
| Memcache | 2.60M | 191µs | 13,400 |
| Pogocache | 3.08M | 119µs | 7,052 |
(数值取自 README 渲染图表;README 注释块内另有一版原始表,数值与图表略有出入,以图表为准。)
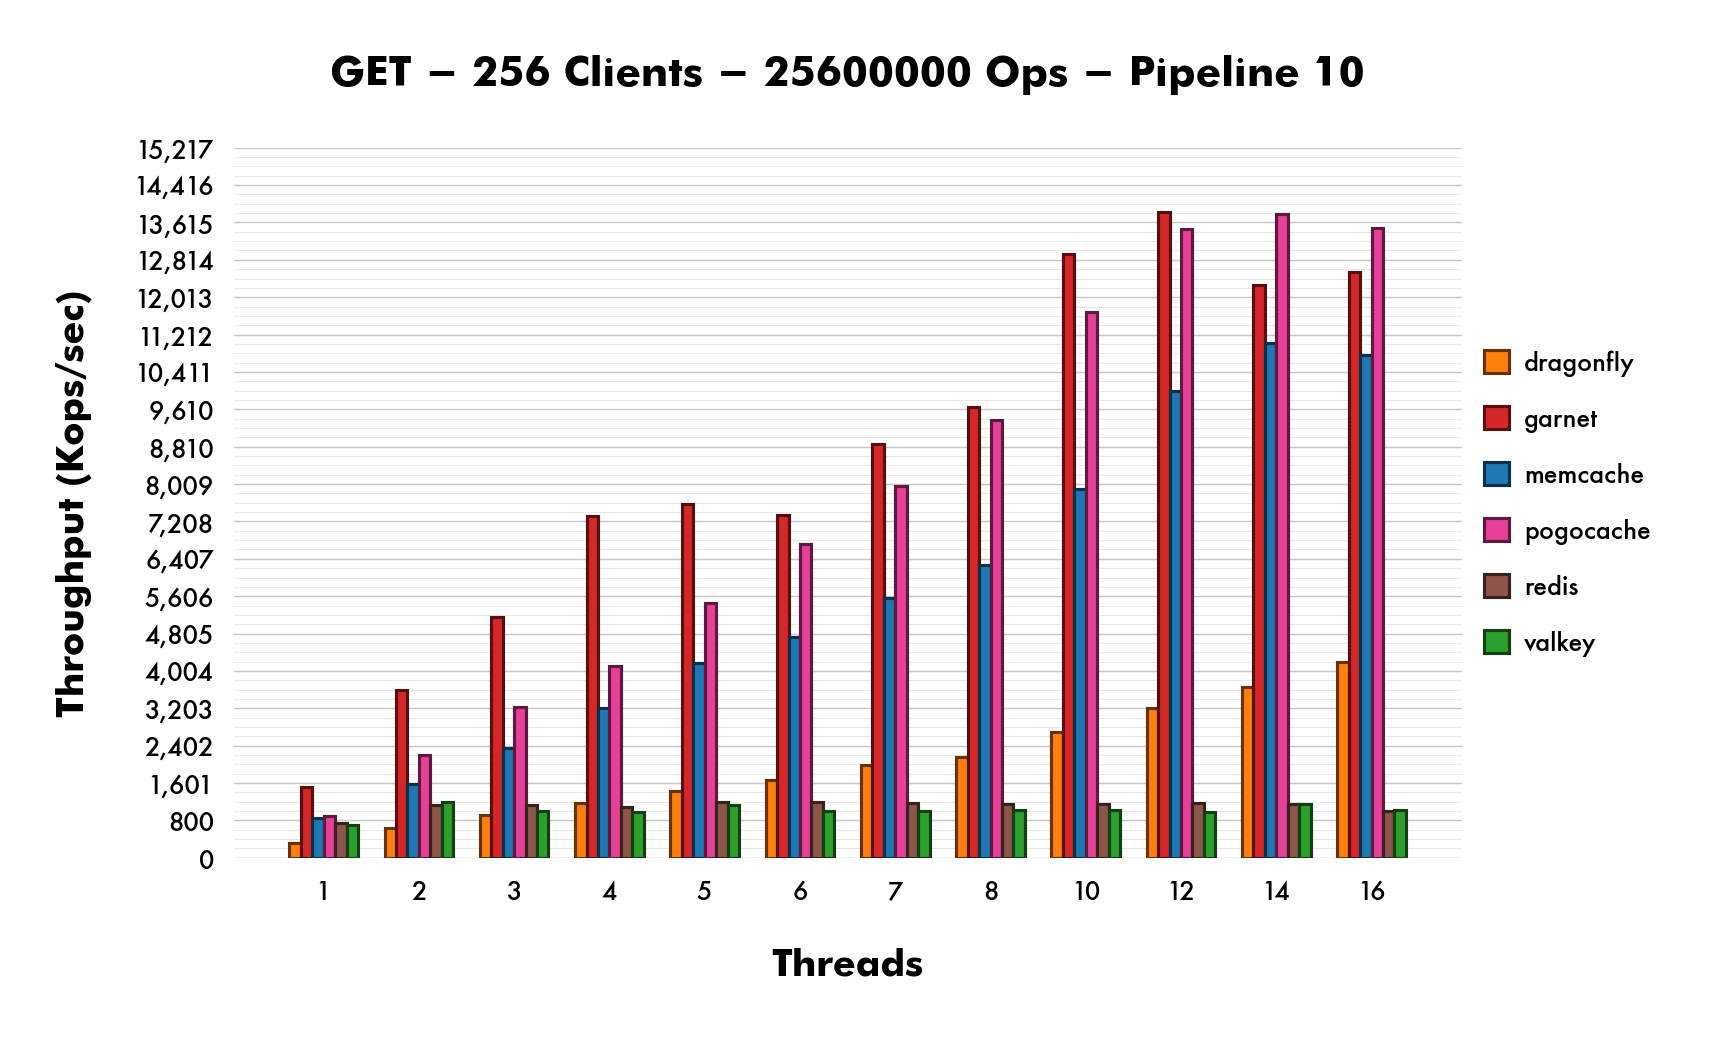
配套的 tidwall/cache-benchmarks 仓库用 memtier_benchmark 作为压测发生器,按 1/10/25/50 条 pipeline、1–16 线程分别测 SET/GET 的吞吐与 p50/p90/p99/p99.9/p99.99/MAX 延迟。上图为 GET、pipeline 10 下吞吐随线程扩展:高线程数下 Pogocache 与 Garnet、Memcache 处于第一梯队,Redis/Valkey 明显偏低。
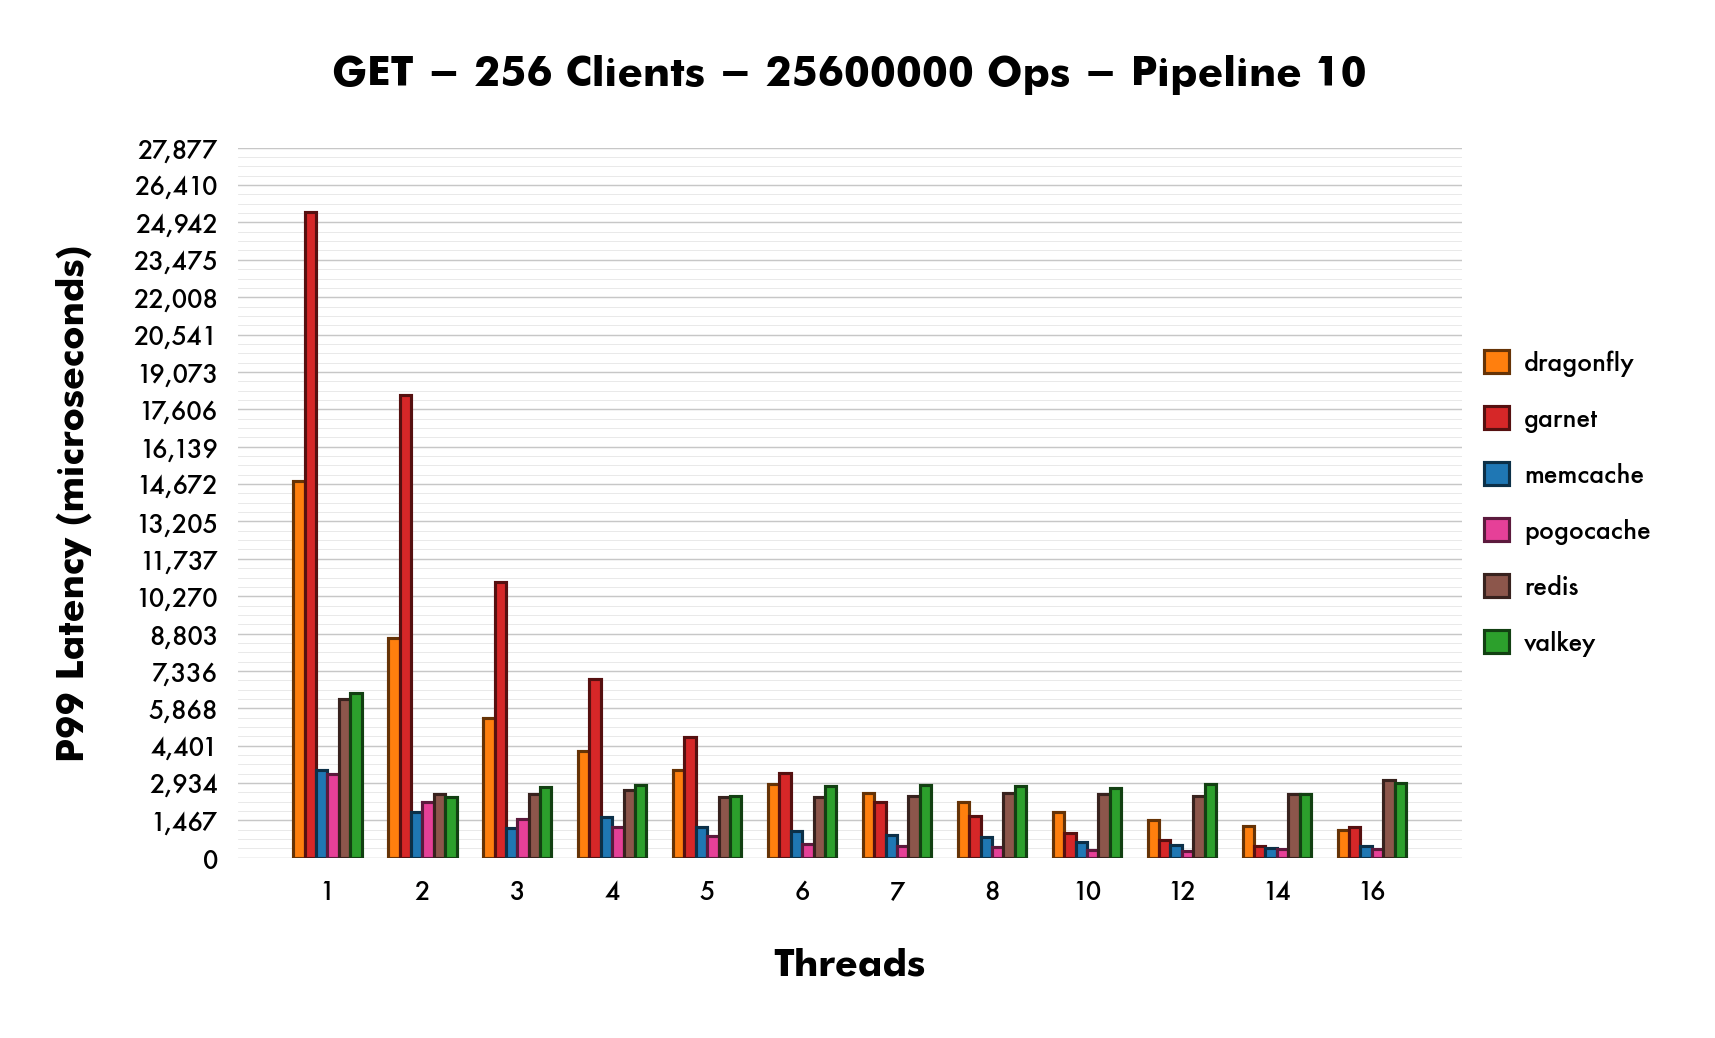
p99 尾延迟图更值得注意:低线程数下 Garnet(红)出现 24ms 级尖峰,而 Pogocache(粉)在各线程档尾延迟都压得较低;线程数拉高后各家收敛到 1–3ms 区间。
五、评测方法的偏向
- 官方自测是自家机器自家配置:8 线程、单实例、GET/SET 短键值,没有覆盖大 Value、混合读写、持久化、网络跨区等生产条件;
- 配套基准仓库与项目同属 tidwall 生态(shardmap/evio/th64 均出自该作者),并非完全中立第三方,复现价值有但不构成独立背书;
- 嵌入式”100M ops/sec”是进程内无网络口径,不能与网络服务的 QPS 直接比较;
- 图表只呈现中位数(median),p99.99 与 MAX 在 README 主图里不可见。
六、适用与不适用
适合:热键值读取、会话/验证码/配置缓存等极简 KV 场景;想省 CPU 核、追求单机极致 GET 延迟的边缘服务;需要把缓存编进同一个 C 进程、消灭网络往返的嵌入式场景。
不适合:需要 Hash/List/ZSet/Stream 等复杂结构、Pub/Sub、Lua 脚本、持久化 RDB/AOF、原生集群分片与故障转移的业务——这些当前路线图尚未提供。
七、优势与局限
优势:
- 热路径延迟与 CPU cycles 官方口径领先,四协议兼容让现有 curl、redis-cli、psql 客户端零改造接入;
- 嵌入式单体 C 文件可直接编译进项目,省掉网络序列化;
- MIT 许可(注:部分二手介绍误传为 AGPL,官方 README 明确为 MIT,源码版权 Polypoint Labs,另提供商业支持选项);
- 默认安全开关齐全(auth、TLS、maxmemory 80%、2-random 淘汰)。
局限/口径:
- 功能集仍是子集:RESP 只支持命令清单内的子集,没有完整 Redis 数据结构与脚本能力,重度 Redis 用户无法平滑迁移;
- 无原生集群:分布式路由、故障转移在官方 Roadmap 中列为”下一步”,当前只能单实例;
- 持久化可选且简单:
--persist指定文件,未见 RDB/AOF 两套机制与恢复验证工具; - 仅支持 64-bit Linux 与 macOS,Windows 不在支持列表;
- 项目年轻(2025-07 创建),生产稳定性、长时运行内存碎片、社区客户端生态都未经大规模验证;
- 所有亮眼数字均为短负载、单机、官方口径,生产前必须用自己的 Value 大小与读写比压测。
八、它意味着什么
Pogocache 代表缓存层的”极简主义回潮”:放弃 Redis 的通用性,把 KV 热路径做到 CPU 最省。对追求单机极致延迟、且业务本身只是简单 KV 的团队,它值得进入压测候选清单;但把它当成”Redis 平替”上生产集群,目前证据远远不够。正确姿势是:拿自己的真实负载在 cache-benchmarks 框架里复现,再决定是否替换。