Plandex:为大型项目设计的终端 AI 编程 Agent
阅读时间: 大约 7 分钟
Plandex:为大型项目设计的终端 AI 编程 Agent
Plandex 是 plandex-ai 开源的终端(CLI/REPL)AI 编程 Agent,MIT 协议,代码主体用 Go 写就(约 93%),作者为 Dane Schneider(@Danenania)。它的定位在 README 里写得很直白:“designed for large tasks and real world projects”——当 Claude Code、Codex 这类工具在项目变大、改动跨几十个文件时开始力不从心,Plandex 想补上这个缺口。本文基于其 GitHub 仓库一手资料,拆解它的机制与真实口径。
一、背景:大项目是 AI 编程工具的分水岭
小项目里,任何 AI 助手都能一通百通;一旦代码库涨到几十万行、一个需求要动十几个文件,普通工具就会遇到上下文塞不下、改完一堆错、无法回滚的问题。Plandex 的三个着力点正是针对这里:大上下文、项目级索引、以及隔离的变更沙箱。
二、是什么:终端里的规划-执行-评审闭环
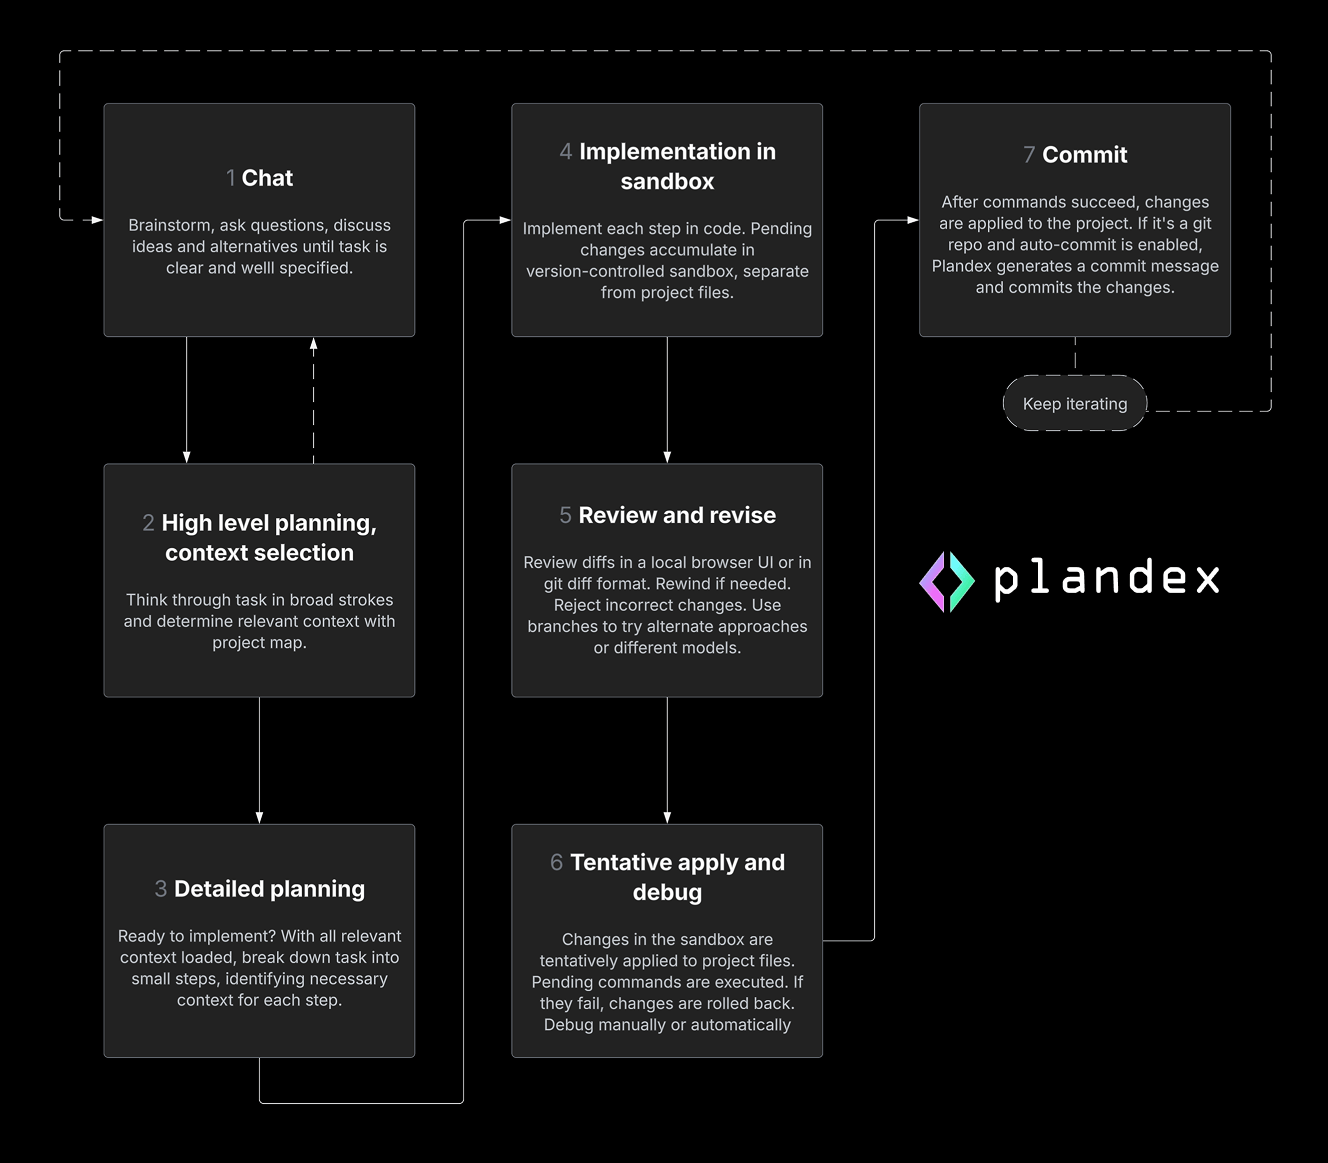
Plandex 不是”让 AI 一把梭写完”,而是把任务拆成七步:① Chat 头脑风暴 → ② 高层规划与上下文选择 → ③ 细化规划 → ④ 在沙箱里实现 → ⑤ 评审与修改 → ⑥ 试应用并自动调试 → ⑦ 提交。整个过程在 plandex(或 pdx)REPL 里完成,支持模糊自动补全。
它的关键工程数字:可直接处理 2M tokens 上下文(约每文件 100k),并用 tree-sitter 项目地图索引 20M tokens 以上的目录、支持 30+ 语言做语法校验。
三、技术机制:沙箱 diff + 多模型组合
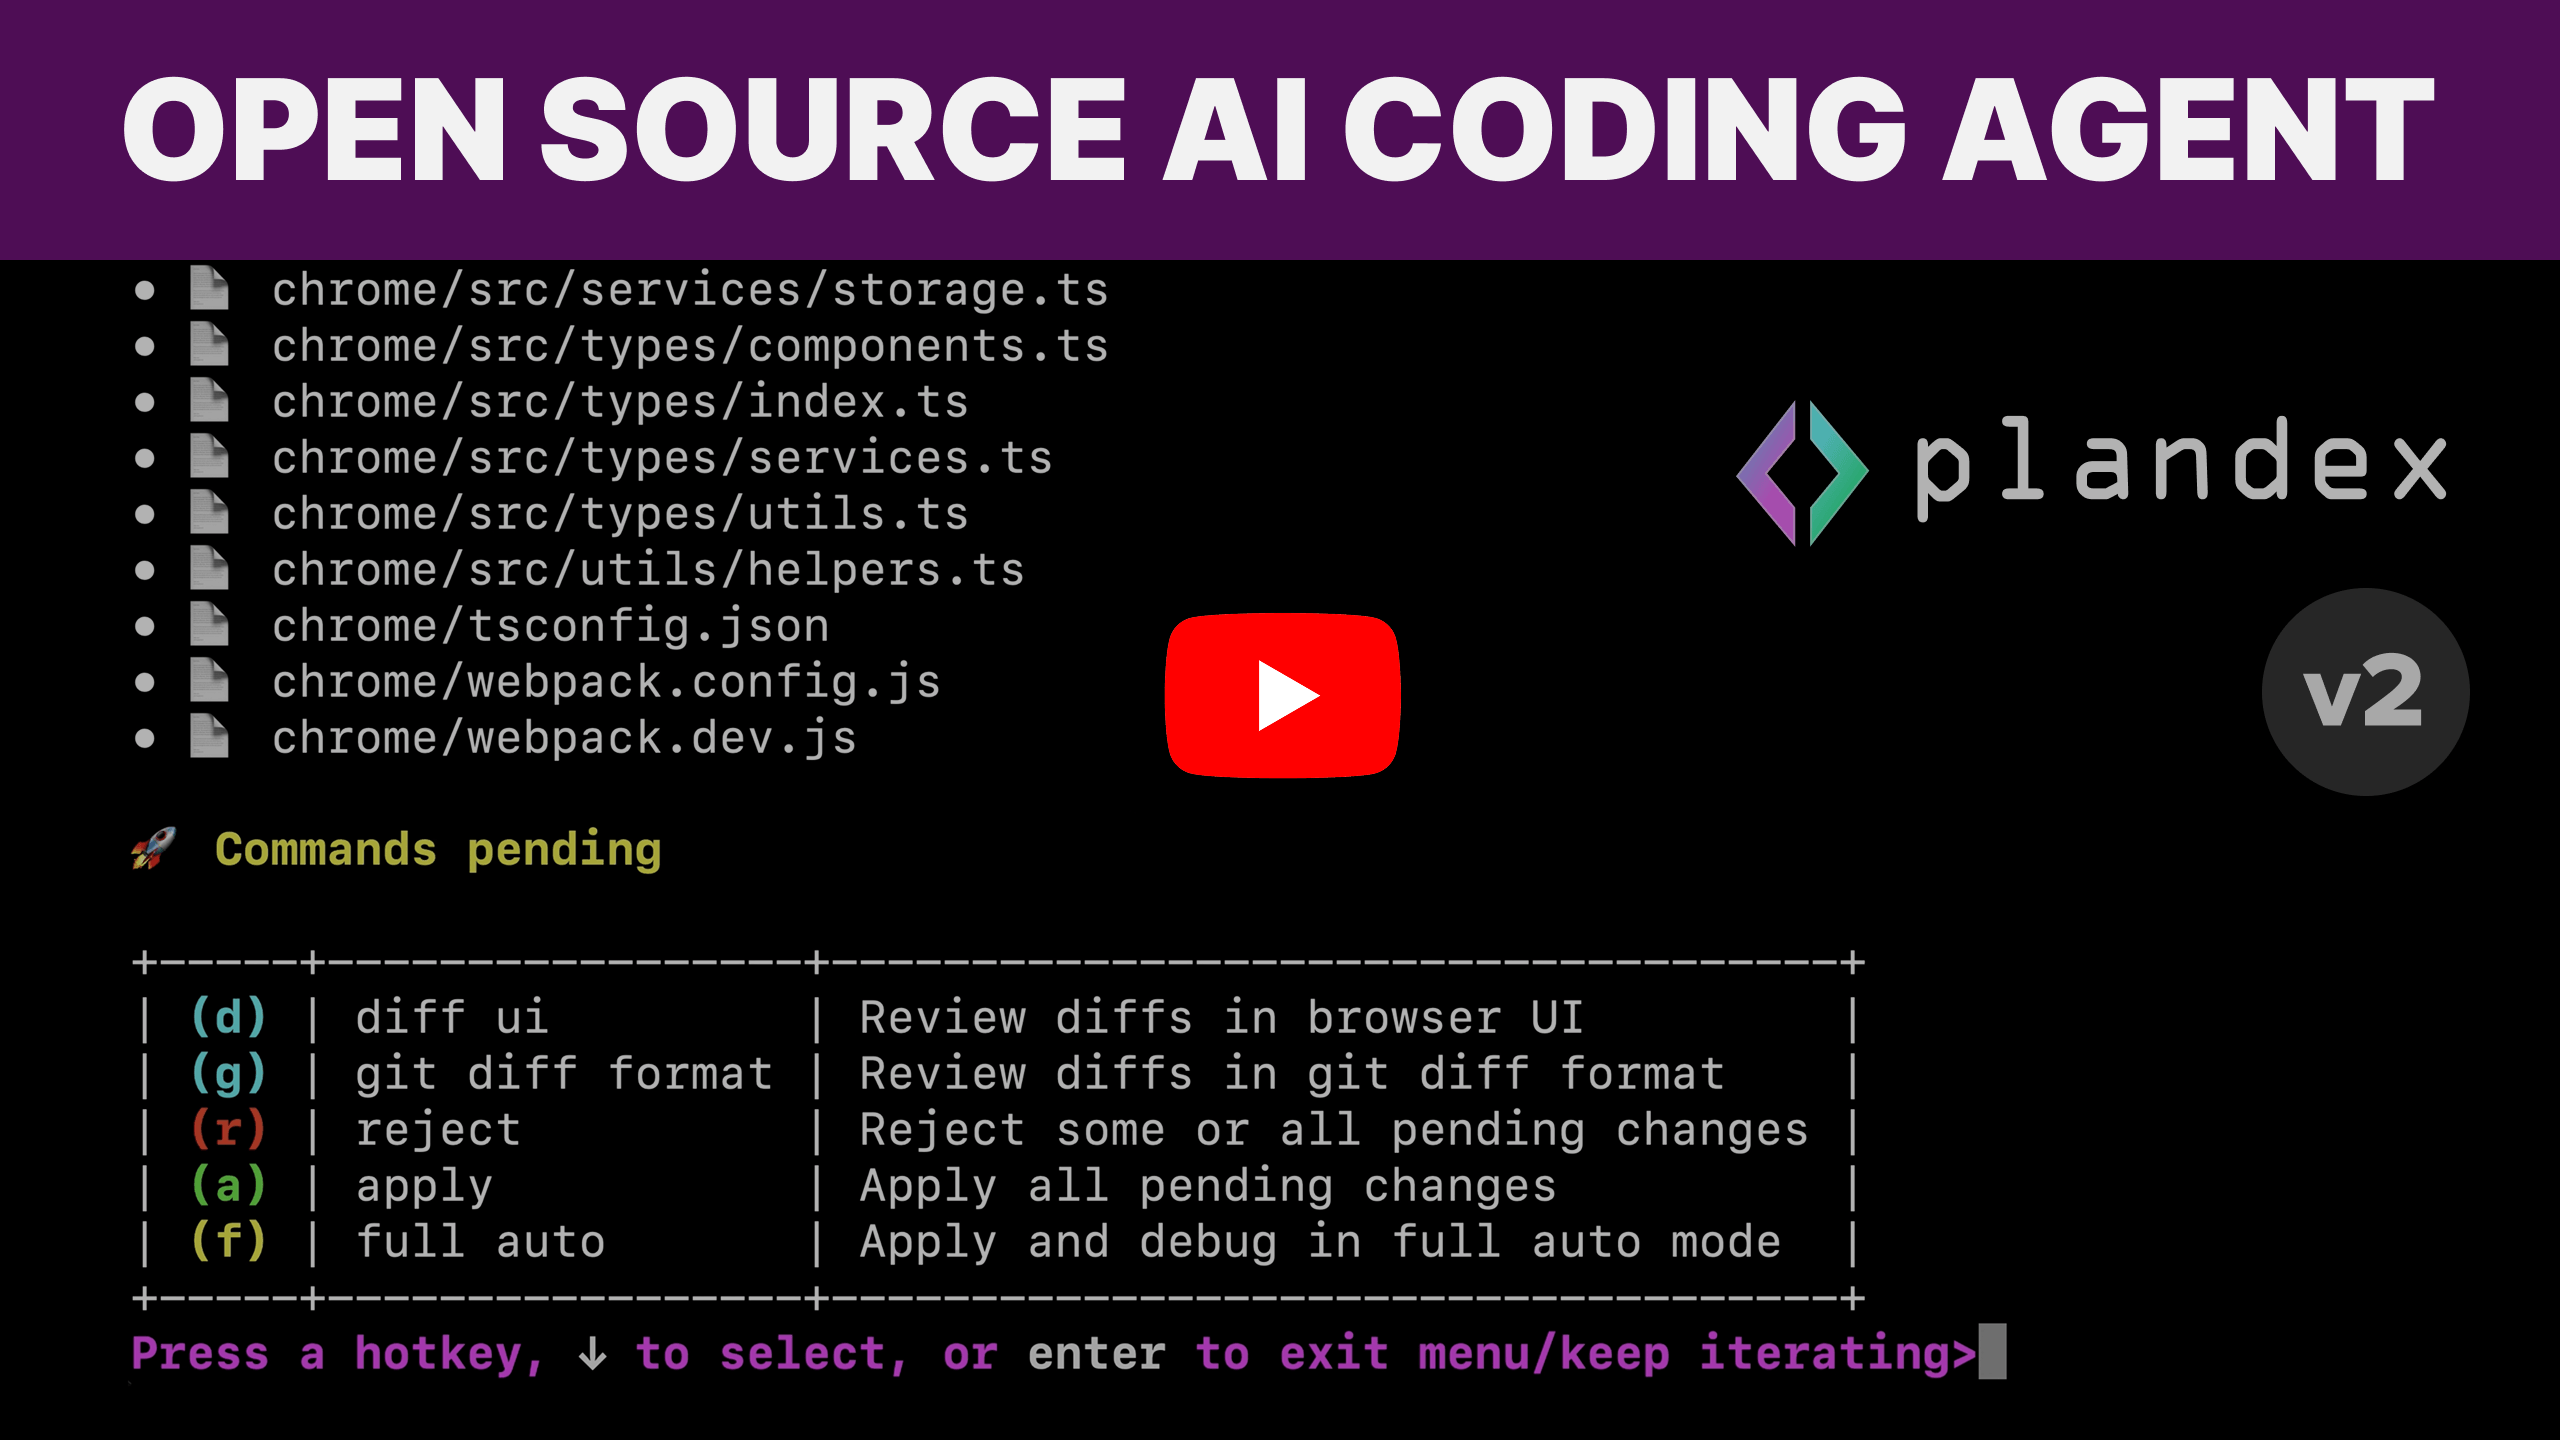
Plandex 最有特色的是它的累积 diff 评审沙箱:AI 生成的改动先堆积在一个受版本控制的沙箱里,与你的真实项目文件隔离,直到你确认无误才应用。命令执行也受控,失败就回滚——这就是它宣称”不让 AI 在你项目里留下一地鸡毛”的实现方式。评审可在本地浏览器 UI 或 git diff 格式里进行,还能用分支去试不同方案或不同模型。
模型层它不绑定单一厂商:可组合 Anthropic、OpenAI、Google 与开源模型,通过 OpenRouter 接入,并对这些厂商普遍启用上下文缓存以降本提速。自动化方面,它能自己跑构建、lint、测试、部署脚本并自动调试;装了 Chrome 还能自动调试浏览器应用。
它能吃下大项目,靠的是 tree-sitter 构建的项目地图:索引时不是把所有文件原文塞进上下文,而是抽出每个文件的符号级结构(函数、类、导出、调用关系),形成一张”地图”。规划阶段 AI 先对着地图判断该动哪几个文件,再按需把具体文件内容加载进来——这就是”20M token 目录、2M token 有效上下文”这套数字背后的真实机制:不是一次性读全仓库,而是像人看目录一样先定位、再精读。
四、关键数据与口径
| 维度 | 官方口径 |
|---|---|
| 有效上下文 | 2M tokens(默认 model pack,约 100k/文件) |
| 可索引目录 | 20M tokens 以上(tree-sitter 项目地图) |
| 支持语言 | 30+(语法校验) |
| 自主性 | 从全自动到逐步人工评审可调 |
| 语言/运行时 | Go 编写;Windows 仅支持 WSL |
这里要特别说明一个容易误读的口径:2M 并不是”某个模型原生上下文窗口 2M”,而是”默认模型包下、每步只加载所需内容后累积出的有效上下文”。Plandex 自己也强调”loads only what’s needed for each step”,本质是靠索引与按需取文件把上下文用满,而非依赖单一超长上下文模型。
五、评测方法批判:它是工程工具,不是跑分玩具
Plandex 没有提供 SWE-bench 之类的跑分数字,卖点全是工程能力描述。这意味着:
- “适合大项目”是自证式主张,没有第三方基准;效果取决于你接的后端模型——接便宜开源模型和接 Claude Opus 是两回事;
- 云服务已关停:README 明确写着 Plandex Cloud “as of 10/3/2025 停止运营、不再接受新用户”,现在官方推荐的是 Docker 本地自托管、自带 OpenRouter key。也就是说,早期”开箱即用托管”的体验已不存在,新用户要自己起服务;
- Windows 原生不可用:官方明确说明在 CMD/PowerShell 下不正常,必须走 WSL,这对 Windows 本地开发者是个实打实的门槛;
- 沙箱隔离与自动回滚是它的卖点,但也意味着比”直接改文件”的工具多一层评审开销,追求极致速度时反而偏重。
六、优势与局限
优势: 一是面向大项目的索引与按需上下文确实切中痛点;二是沙箱 diff + 分支对比 + 自动回滚,把”AI 改坏了”的风险降到可控;三是多模型自由组合、走 OpenRouter,不锁厂商;四是计划本身带版本控制,可回溯、可比较不同模型的方案。
局限: 无公开 benchmark,能力高度依赖后端模型;官方云已停,须自托管;Windows 仅 WSL;相比单文件、小改动的轻量场景,它的流程偏重,杀鸡用牛刀。
七、谁该关注
- 大型遗留项目的维护者:需要跨多文件、多步骤改造,且重视可回滚与可评审;
- 想要多模型自由组合、不被单一 AI 厂商绑定的团队;
- 愿意自托管、用自己的 OpenRouter key 控成本的开发者。
如果你只是改一两个小文件、图省事,Claude Code 这类更轻;Plandex 的主场是”项目很大、改动很复杂、又怕 AI 搞乱仓库”的那类任务。