PicoMQ:把消息队列的"状态"全部搬到对象存储上
阅读时间: 大约 9 分钟
PicoMQ:把消息队列的”状态”全部搬到对象存储上
Kafka 式的日志型消息队列强大,但它有两个长期被吐槽的重负:broker 本地磁盘上的分区副本,以及 Raft/Zab 这类共识协议。PicoMQ 走了一条相反的路:它是一个”durable stream server”,把每一条记录、甚至写前日志(WAL)都放进 S3 兼容对象存储,节点本身零磁盘、无本地状态,集群协调交给一个 SQL 数据库。它用 Rust 编写,Apache-2.0 协议开源。本文基于官方文档与 GitHub README,拆解这一思路的机制、特性与它主动放弃了什么。
一、出发点:把”流”当成小而可丢弃的单元
传统 MQ 习惯把一类消息塞进一个 topic,分区数固定、扩容要 rebalance。PicoMQ 的理念相反——流是一个小的、一次性的单元:用 URL 路径命名,一次请求创建,空闲时不花一分钱。一个部署里可以有十条流,也可以有几百万条流:每个订单一条、每个会话一条、每个设备一条、每个 Agent 对话一条。
让这种粒度在经济上成立的,正是对象存储:每条记录(包括 WAL)都落在 S3 上,所以持久性从不依赖某个节点;一条空闲流只是”注册表里的一条记录 + 它对应的若干对象”。集群协调则走 SQL。官方由此得出结论:没有共识协议、没有 broker 磁盘。
二、架构:无状态节点 + SQL 控制面 + S3 数据面
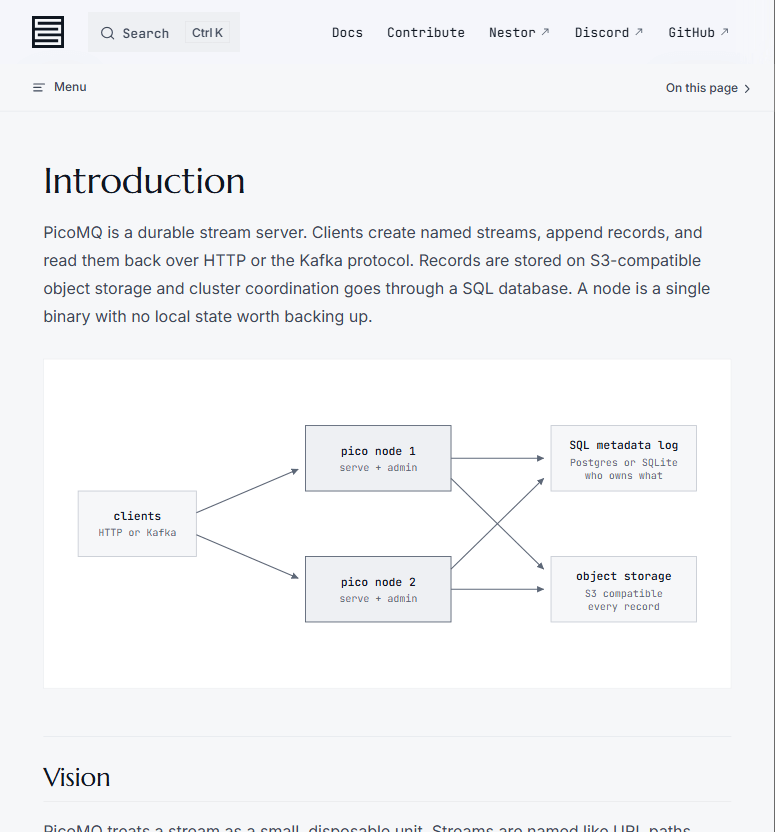
官方把架构分成三层(见上图):
- 节点(pico node):单二进制,既跑 serve 又跑 admin。节点只保留缓存,没有值得备份的本地状态——可以随时停掉、替换,扩容量就是再起一个进程;丢一个节点只带来几秒的重新路由,而不是一场数据 rebalance;
- SQL 元数据日志:集群元数据是一个有序的命令日志,生产环境用 Postgres,单节点可以用 SQLite。所有节点 tail 这份日志、重建出同一份状态——“谁拥有哪条流”由它决定;
- 对象存储:S3 兼容,放每一条记录。
几个关键设计点:
- 零磁盘节点:记录和 WAL 全部在 S3 上,节点只留缓存;
- 三套线协议:原生 Pico 协议、开放的 Durable Streams 协议,以及 Kafka 线协议——同一套引擎,标准 Kafka 客户端可以直接连上来;
- HTTP 语义直观:
PUT创建流、POST追加、GET读取、长轮询或 SSE 尾随。追加响应在Pico-Next-Seq头里返回 assigned 序列号;读可以从seq=now起、用live=long-poll等下一条、用live=sse保持事件流; - 在线流迁移:流的所有权在节点间转移时不丢写,交接以秒计;
- 处处 fencing:节点 epoch 与流 epoch 让僵尸进程无法破坏状态;
- 一个二进制全包:
pico既是服务端、客户端、admin CLI、压测工具,还内嵌了管理 dashboard。
三、上手与运行
最小单机几乎零依赖:
pico serve \
  --meta-url sqlite:./data/meta.db \
  --storage=-2@file://./objects
服务监听 :4437,admin/dashboard 在 :9090,Kafka 协议在 :9092。接上真实基础设施时,同一命令把 --meta-url 指向 Postgres、--storage 指向 s3://bucket 即可。也官方提供了 Docker Compose:harness/aio 一键起 Postgres + RustFS(一个 S3 兼容实现)+ 1 节点;compose.cluster.yml 起 2 节点;compose.lite.yml 用 SQLite + 本地文件,无任何外部依赖。
注意安全默认值:认证默认关闭,一旦监听非回环地址,必须显式 --auth required(或在 .env 里设 PICO_AUTH=required),否则要加 --insecure-allow-remote 这个明显写着”不安全”的开关。
四、关键特性与取舍
| 维度 | PicoMQ 的做法 |
|---|---|
| 数据持久 | 记录 + WAL 全在 S3 兼容对象存储 |
| 集群元数据 | Postgres(或 SQLite)中的有序命令日志,无共识协议 |
| 节点状态 | 仅缓存,可随时替换,扩容=起进程 |
| 线协议 | Pico / Durable Streams / Kafka,三者同引擎 |
| 追加延迟 | 官方称一次对象存储往返,典型几十毫秒 |
| 流粒度 | 每订单/会话/设备/Agent 对话一条,空闲近乎免费 |
| 高可用 | 节点丢失几秒内重路由,无 rebalance |
官方自己把边界划得很清楚:它不是为”个位数毫秒追加”设计的。因为持久性来自对象存储,一次追加就要付一次到对象存储的往返——典型是几十毫秒。这是理解它定位的钥匙:它换来的是无限流粒度、零磁盘节点和极其简单的运维,代价是写延迟。
五、客观优势与局限
优势:
- 运维极简:节点无状态、无本地磁盘要备份,加机器就是起进程,丢机器不 rebalance——这对”想做消息队列又不想养 Kafka 集群”的小团队很有吸引力;
- 粒度经济:把流做成”每实体一条”成为可能,天然契合多租户、每会话/每设备/每 Agent 对话的场景;
- 协议友好:HTTP 语义 + Kafka 协议双吃,老 Kafka 客户端和新 HTTP 客户端都能接;
- 名字与生态诚实:“Pico”取自拉丁语 picus(啄木鸟),组件拆为独立的
s3stream流引擎与picomqhost,Apache-2.0。
局限与官方口径:
- 写延迟不是个位数毫秒:官方明确说”不为此而生”,硬实时、高频小消息场景不是它的菜;
- 依赖外部组件:生产上要 Postgres 当元数据日志、要一个 S3 兼容桶,“零磁盘节点”不等于”零依赖”——只是把状态推给了更成熟的基础设施;
- 项目早期:仓库仍在快速迭代(Issues/Discussions 活跃),线协议与 API 稳定性需自行关注;
- 认证默认关闭:图省事的人若直接绑公网而不开 auth,会把服务裸奔——这是部署时必须自己绷紧的弦;
- 吞吐上限受对象存储制约:每次写都打 S3,极致吞吐场景仍不如本地盘的专用 broker。
六、适合谁用
- 多租户、按实体切流的应用:每个用户会话、设备、聊天、Agent 对话一条流,读者可从任意位置 resume;
- 审计轨迹与每实体事件历史:需要可重放、可追补的有序日志,但又不想养 Kafka;
- 想要 Kafka 协议兼容、却讨厌 broker 磁盘运维的团队:用 S3 当底座,用 Postgres 当控制面;
- 实时投递到大量并发读者:长轮询/SSE 尾随,适合推送类负载。
反过来,如果你的负载是高频、小消息、个位数毫秒级追加的热路径,PicoMQ 官方自己也建议你另选。