PGlite:把完整 Postgres 编译进浏览器的 WASM 数据库
阅读时间: 大约 12 分钟
PGlite:把完整 Postgres 编译进浏览器的 WASM 数据库
「Koala 聊开源」科技周报曾介绍 Crunchy Data 的 Postgres Playground——一个无需在后端起数据库实例、直接在浏览器里就能敲 SQL 的学习环境。其背后的技术脉络,在今天已经收敛到一个事实上的标准:PGlite。它由 Electric(原 ElectricSQL,现 Electric DB Inc.)开源(Apache-2.0),是把 PostgreSQL 整体编译为 WebAssembly(WASM)后封装成 TypeScript 客户端的嵌入式数据库。本文基于 PGlite 官方仓库、官网与 Crunchy Data 官方博客,梳理它到底解决了什么问题、怎么做到的,以及它的硬边界在哪里。
一、背景:为什么要把 Postgres 塞进浏览器
长期以来,浏览器端应用的数据层存在一个断层:要么用 localStorage / IndexedDB 这类 KV 或键值存储,能力弱、不支持 SQL 与事务;要么远程连一个服务器上的 Postgres,受网络与延迟制约,离线即不可用。前端工程师想要的是「本地就能跑一个真正的 Postgres」,以便:
- 做**本地优先(local-first)**应用,离线可用、在线再同步;
- 在文档、教程、IDE 插件、客服工具里内嵌一个可交互的 SQL 沙箱;
- 用与生产环境**同一套 SQL 方言与扩展(JSONB、数组、pgvector、PostGIS)**做开发与测试,避免「本地 SQLite、生产 PG」的方言漂移。
Crunchy Data 在 2022 年 8 月的官方博客(作者 Craig Kerstiens)中就给出了早期答案:Postgres Playground 把 Postgres 编译为 WASM,在浏览器里分配约 512MB 内存运行一个实例,并预置数据集与引导式教程(psql 基础、分区、性能分析、Join、索引、PostGIS、窗口函数与 CTE)。官方特别强调:后端没有跑任何额外的 Postgres 实例,全部计算发生在浏览器内;也正因浏览器沙箱限制,除了内置的 psql 交互界面外,无法从外部直连这个实例。
二、是什么:PGlite 的定位
PGlite 把上述思路产品化、库化。官方仓库的定位很直接:它是「a WASM build of Postgres packaged into a TypeScript client library」,可以在浏览器、Node.js、Bun、Deno 中运行,且无需安装任何其他依赖。安装后一行代码即可起一个内存库:
import { PGlite } from "@electric-sql/pglite";
const db = new PGlite();
await db.query("select 'Hello world' as message;");它既可以是易失的内存数据库,也可以持久化到磁盘(Node/Bun/Deno 写文件系统)或浏览器的 IndexedDB(new PGlite("idb://my-pgdata"))。也就是说,开发者拿到的不是「Postgres 风格的子集」,而是一个真正的 Postgres——包括它的数据类型、SQL 语法与扩展生态。
三、技术机制:为什么不套一个 Linux 虚拟机
很多人第一反应是「在浏览器里跑 Linux 虚拟机再装 Postgres」。官方明确指出:与以往的「Postgres in the browser」项目不同,PGlite 不使用 Linux 虚拟机,它就是 Postgres 本身的 WASM 构建。
其关键技术点有两个:
- Emscripten 把 C 编译为 WASM。PostgreSQL 原生采用「连接进来就 fork 一个新进程」的多进程模型,而 Emscripten 编译出的 WASM 程序无法 fork 新进程,只能单线程顺序执行,这与 Postgres 的进程模型天然冲突。
- 复用 Postgres 的「单用户模式(single user mode)」。Postgres 自带一个原本用于引导启动与崩溃恢复、供命令行使用的单用户模式。PGlite 在这个模式之上构建了一条输入/输出通路,让编译成 WASM 的 Postgres 可以通过函数调用与 JS 层交互,而不必 fork 进程。
代价也因此写在明处:PGlite 是单用户/单连接的。它不是为多并发客户端设计的服务端,而是一个嵌入到单个 JS 运行时里的库。扩展方面,它提供动态扩展加载机制,官方明示支持 pgvector(向量检索)与 PostGIS(空间数据),这意味着在浏览器里做向量相似度查询、地理空间查询都成为可能。
四、关键数据(官方口径)
| 指标 | 数值 | 来源口径 |
|---|---|---|
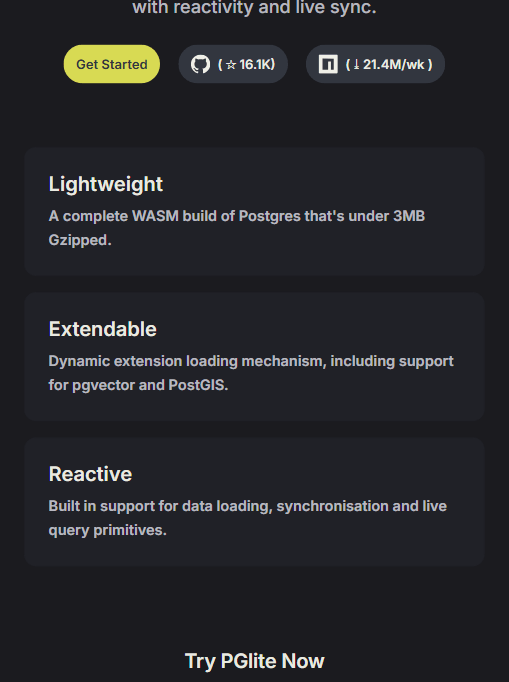
| 体积 | 完整 WASM 构建 < 3MB(gzipped) | 官网首页「Lightweight」 |
| 运行环境 | 浏览器 / Node.js / Bun / Deno | 官方 README |
| 持久化 | 内存、文件系统(服务端运行时)、IndexedDB(浏览器) | 官方 README |
| 并发模型 | 单用户 / 单连接 | 官方 README 明示 |
| 扩展 | pgvector、PostGIS,动态加载 | 官网「Extendable」 |
| GitHub Stars / npm 周下载 | 约 16.1K Stars、约 21.4M 周下载 | 官网首页截图(2026-09) |
| 开源协议 | Apache-2.0 | GitHub 仓库 |
| Crunchy Playground 内存配额 | 约 512MB(早期配置) | Crunchy Data 官方博客 |
需要说明的是:「<3MB」是 gzip 压缩后的分发体积,不是运行时常驻内存;WASM 实例加载后解包、配合 Postgres 自身缓冲,实际内存占用远大于此,Crunchy 早期示例直接给浏览器实例分配了 512MB 就是旁证。Stars 与下载量是官网前端实时渲染数字,会随时间变动,此处为截图时点的约数。
五、评测方法与口径批判
PGlite 官方没有发布独立的 benchmark 数字(如每秒事务数、查询延迟),官网与 README 强调的是「体积、兼容性、可扩展」这类工程指标,而非吞吐。这本身就是一个需要警惕的口径:
- 单连接 + WASM 单线程的架构,决定了它不能拿来对标服务端 Postgres 的 QPS;任何「PGlite 多快」的讨论都应放在「嵌入式、本地、单用户」的前提下,否则就是拿苹果比橘子。
- 「完整 Postgres」指的是 SQL 方言与扩展兼容度,而非并发、复制、高可用这些服务端能力;它没有流复制、没有连接池、没有故障切换。
- Crunchy Playground 的 512MB 内存是「当前配置」,官方博客也明说后续可能调整,不能当作固定规格。
六、适用与不适用场景
适合:
- 本地优先应用、离线优先的协作工具,本地存真 Postgres、再通过同步层上云;
- 教程、文档、AI 工具里的可交互 SQL 沙箱(这正是 Crunchy Playground 的初心);
- 需要在前端跑 pgvector 做本地向量检索、或 PostGIS 做空间分析的轻量场景;
- 单页应用中用 SQL/JSONB 替代手写状态管理,获得事务与查询能力。
不适合:
- 需要多连接、高并发读写的后端服务——那是服务端 Postgres 的地盘;
- 对体积极度敏感的首屏关键路径(3MB WASM 仍需按需加载/动态加载扩展);
- 需要流复制、主从高可用、水平扩展的生产数据库。
七、客观分析:优势与局限
优势:
- 方言一致性:本地与生产用同一套 Postgres SQL 与扩展,消除 SQLite/PG 差异;
- 零依赖、跨运行时:一套包同时跑在浏览器、Node、Bun、Deno;
- 不依赖虚拟机:纯 WASM 构建比「浏览器里跑 Linux」更轻、更快启动;
- 生态顺势:背靠 Electric 的本地优先/实时同步路线,reactive live query 与后续同步能力是其差异化方向。
局限:
- 单连接硬约束:无法作为多客户端共享数据库;
- 无服务端能力:复制、高可用、连接池一概没有;
- 体积与加载成本:3MB gzip 对移动端首屏仍不轻,扩展需按需动态加载;
- 生态年轻:相对成熟服务端,周边 ORM/工具链的深度适配仍在演进。
八、它意味着什么
PGlite 代表了一个明确趋势:数据库正在从「远端服务」下沉为「可嵌入的运行时组件」。当 Postgres 这种重量级关系库都能以 <3MB 的 WASM 形态跑在浏览器里,前端就第一次拥有了「与生产同构」的本地数据层。对开发者而言,它不是要替代服务端 Postgres,而是把 SQL 的能力边界推到了离用户最近的地方——做工具、做教程、做本地优先产品的团队,值得认真评估。