pg_lake:Snowflake 开源的 Postgres 湖仓集成,用 DuckDB 引擎直读 Iceberg
阅读时间: 大约 13 分钟
pg_lake:Snowflake 开源的 Postgres 湖仓集成,用 DuckDB 引擎直读 Iceberg
2025 年 11 月 4 日,Snowflake 在工程博客宣布开源 pg_lake:一组让 PostgreSQL 直接对接数据湖仓(lakehouse)的扩展,开发者可以在 Postgres 里用标准 SQL 创建并管理 Apache Iceberg 表、原地查询 S3 等对象存储中的 Parquet/CSV/JSON 文件,并把查询结果写回对象存储。这套技术并非 Snowflake 从零开发:它源自 2025 年 6 月被 Snowflake 收购的 Crunchy Data,曾以 Crunchy Bridge for Analytics / Crunchy Data Warehouse 的形态商用了一年半以上。本文基于 Snowflake 官方博客、开源仓库 README 与官方文档,对其架构、来源与局限做客观分析。
一、背景:事务库与数据湖之间的 ETL 鸿沟
Postgres 擅长事务型(OLTP)负载,数据湖仓擅长大规模分析(OLAP),两者之间传统上靠 ETL 管道搬运:先把 Postgres 数据抽出来转成 Parquet 落到对象存储,再交给 Spark、DuckDB 或数仓查询。Crunchy Data 团队(曾参与 PostGIS、Citus、pg_cron、pg_partman 等经典扩展)在多年服务客户时反复遇到同一个痛点:业务数据散落在 Postgres 与对象存储两处,打通它们代价高昂。pg_lake 的目标就是把这道鸿沟在 SQL 层填平:用户继续用熟悉的 Postgres,分析能力由外挂的 DuckDB 引擎承担。
二、是什么:三类数据同库查询
按官方 README,pg_lake 让 Postgres 同时容纳三类数据并在同一条 SQL 里联合查询:
- 原生 Iceberg 表:
CREATE TABLE ... USING iceberg,Postgres 自身充当 Iceberg catalog,建表、写入、事务都保留 Postgres 语义,同时表可被其他引擎(如 Spark、Trino)读取; - 对象存储原始文件:用
CREATE FOREIGN TABLE ... SERVER pg_lake OPTIONS (path 's3://.../*.parquet')原地查询,列名与类型自动推断,无需先建表; - 传统堆表(heap):与 Iceberg 表、外部文件在同一查询中 join、聚合,且带完整事务保证。
导入导出走 Postgres 原生 COPY:COPY ... FROM 's3://bucket/file.parquet',也可 COPY (SELECT ...) TO 's3://.../report.csv' 把结果写回对象存储。此外还支持通过 GDAL 读取 GeoJSON、Shapefile 等地理空间格式,内置 map 类型承载半结构化数据。
三、技术机制:Postgres 编排 + 独立 DuckDB 进程
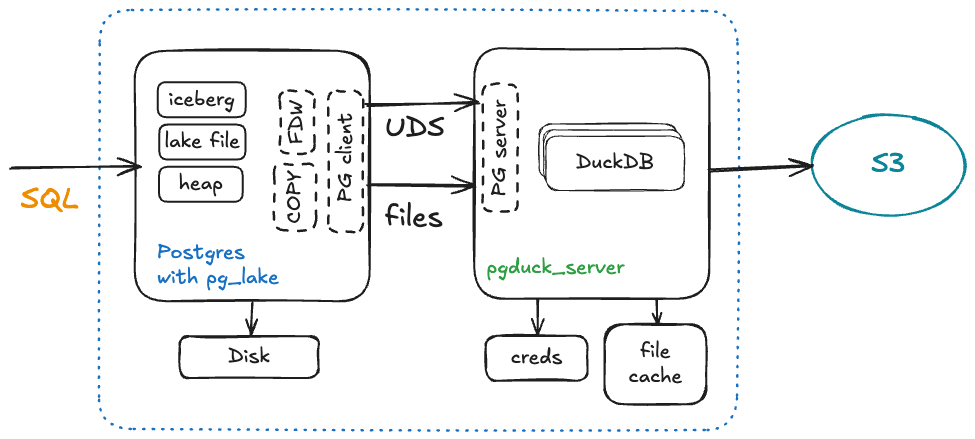
pg_lake 由两大组件构成(官方 README「Architecture」节):
- 带 pg_lake 扩展的 PostgreSQL:负责连接接入、查询规划、事务边界与整体编排,扩展拆成模块化小组件——
pg_lake_iceberg(实现 Iceberg v2 协议)、pg_lake_table(对象存储文件 FDW)、pg_lake_copy(COPY 导入导出)、pg_lake_engine(公共模块)等; - pgduck_server:一个独立多线程进程,本地实现 Postgres 线协议,内部加载 DuckDB(README 示例版本 v1.3.2)与自研
duckdb_pglake扩展(补齐 Postgres 兼容函数),默认监听 Unix 域 socket 的 5332 端口,默认max_clients10000,--memory_limit默认取系统内存的 80%。
官方解释了为什么不把 DuckDB 嵌进 Postgres 进程:Postgres 围绕进程隔离设计,直接内嵌多线程的 DuckDB 会撞上线程与内存安全限制;拆成独立进程后,分析负载走 DuckDB 的向量化、多线程列存引擎,事务与编排仍归 Postgres。
查询下推(pushdown)分两级,这也是理解其性能边界的关键(官方 performance.md):
- 全下推:查询里所有表都是 Iceberg/湖文件、所有函数与运算符都能下推时,整条 SQL(含 join、聚合、排序、LIMIT)整体交给 DuckDB,EXPLAIN 显示单个
Custom Scan (Query Pushdown); - 部分下推:否则每个湖表以 Foreign Scan 方式只下推所需列与可下推过滤条件,DuckDB 读回的行再由 Postgres 完成其余计算。
四、发展脉络:三代产品的开源化
README「History」节给出了完整时间线,这是核实口径的关键:
| 时间 | 阶段 |
|---|---|
| 2024 年初 | Crunchy Data 启动,先做 DuckDB 外部引擎集成以快速上市 |
| 早期 | 以 Crunchy Bridge for Analytics 向托管客户提供查询/导入/导出 |
| 2024 年 11 月 | 重写为 Crunchy Data Warehouse,支持 Iceberg v2 协议与事务 |
| 2025 年 6 月 | Crunchy Data 被 Snowflake 收购 |
| 2025 年 11 月 | 以 Apache 2.0 协议开源,版本号直接定为 3.0(继承前两代) |
官方博客作者为 Craig Kerstiens(软件工程总监),博客发布日期 2025-11-04,标注 11 分钟阅读;GitHub 仓库 Snowflake-Labs/pg_lake 开源后约 1.6k stars(截至调研时)。
五、评测与口径:官方没有公布公开基准数字
需要明确一点:Snowflake 博客与 README 没有给出独立的性能基准(QPS、扫描吞吐、延迟对比表),仓库里的 pg_lake_benchmark 扩展是供用户自行对湖表做基准测量的工具,而非官方发布的对比报告。官方只在性能文档中说明了调优思路(本地缓存远程文件、DuckDB 多线程、分区裁剪在 EXPLAIN 中可见 Data Files Scanned: 2)。因此任何”比 Spark 快多少”的说法目前都缺乏官方数据支撑,本文不做断言。
六、适用与不适用场景
适合:
- 重度依赖 Postgres、又需要直接分析对象存储中原始文件的团队,省掉 ETL 建表环节;
- 小规模分析负载、希望用一套 SQL 同时查事务表与湖文件;
- 已有 Crunchy Data Warehouse 商业版用户(官方称有自动升级路径,部分名称会变更)。
不适合:
- 需要企业级多租户、跨云大规模集群治理的核心数仓;
- 对高并发事务写入 Iceberg 有强需求的在线业务;
- 希望零额外进程、纯 Postgres 进程内完成分析的场景。
七、客观分析:优势与局限
优势:
- SQL 体验统一:建 Iceberg 表、COPY、FDW 都是 Postgres 原生语法,学习成本低;
- 成熟度来自两代商用产品:不是实验室项目,经过 Crunchy Bridge 客户一年半以上检验;
- 架构隔离干净:DuckDB 独立进程避开 Postgres 线程限制,也便于单独调内存与线程;
- Apache 2.0 开源,可自部署、可商用,依赖上游 Avro、DuckDB 保持各自原协议。
局限与官方口径(必须如实写出):
- 下推不完整时性能打折:凡 DuckDB 未实现等价语义的函数、非湖表 join,都退回 Postgres 逐行处理,官方明确”结果一致,只是速度不同”,复杂自定义函数场景不要期待 DuckDB 加速;
- 多了一个常驻进程与内存预算:pgduck_server 默认吃掉 80% 系统内存上限,与同机其他服务争抢资源时需手动
--memory_limit; - 对上游打补丁:README 依赖说明明确,构建时会给 Avro 与部分 DuckDB 扩展打补丁,二次打包分发者须自行审查上游许可条款;
- 开源动机带有商业卡位:Koala 点评亦指出,Snowflake 开源 pg_lake 客观上是在为自家 lakehouse 生态铺路——让 Postgres 用户熟悉 Iceberg 与开放格式,长期导向其商业平台,这与纯粹的社区利他项目动机不同;
- 官方无公开性能基准:选型时应以自有数据复现测试,不宜引用未经验证的加速倍率;
- 版本起点为 3.0 的初始开源版,生态周边(驱动、迁移工具、第三方集成)仍在早期。
八、它意味着什么
pg_lake 与 pg_textsearch 代表同一条大趋势:Postgres 正在从单一事务库向”事务 + 分析 + 搜索”的一体化平台扩张,而开放格式(Iceberg、Parquet)与开源分析引擎(DuckDB)成为粘合剂。对中小团队,它提供了一条不引入 Spark 集群就能”库内看湖”的捷径;对 Snowflake 自身,这是收购 Crunchy Data 后把技术资产回馈社区、争夺 Postgres 开发者心智的一步棋。是否采用,关键看自己的分析规模是否落在 DuckDB 单机/小集群的甜区内。