PageIndex:扔掉向量库,用 LLM 推理在树形索引上做 RAG
阅读时间: 大约 11 分钟
PageIndex:扔掉向量库,用 LLM 推理在树形索引上做 RAG
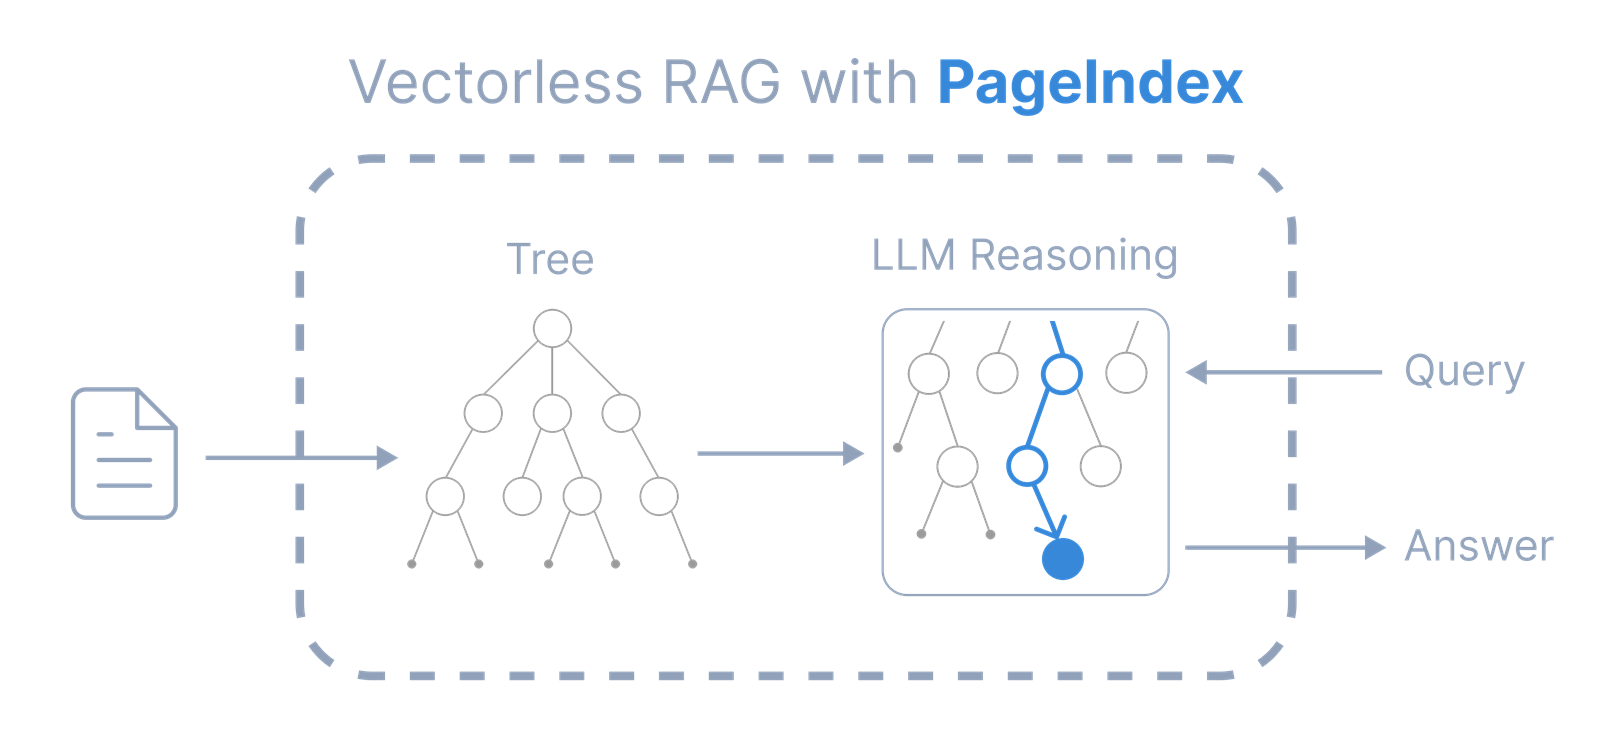
PageIndex 是 Vectify AI 开源(MIT)的一套”无向量、基于推理”的 RAG 引擎:不为文档建向量索引、不做固定分块,而是把文档解析成层级树形目录,再让 LLM 像人翻目录一样在树上推理跳转、定位证据。GitHub 仓库 VectifyAI/PageIndex(访问当日约 39.4k stars、3.4k forks、151 个开放 Issue,Python 为主,2025 年 4 月创建)。本文基于官方 README、2026 年 8 月 26 日发布的 PageIndex Flash 博客与作者自评的 FinanceBench 仓库,梳理其机制、成本与口径。
一、动机:相似性 ≠ 相关性
传统向量 RAG 把文档切成固定大小的 chunk、转成 embedding,按语义相似度召回。官方的批评是:在财报、法规、技术手册、教科书这类长专业文档里,回答问题的段落可能与查询用词完全不同(相关但不相似),而语义相近的段落却与任务无关(相似但不相关)。相似性匹配解决不了”需要上下文、领域知识和多步推理才能找到证据”的问题。PageIndex 的主张是:检索需要的是 relevance(相关性),而相关性需要 reasoning(推理)。
二、机制:先建树,再在树上推理
检索分两步(官方框架):
- Index(建树):为每份文档生成层级树索引,节点包含标题、页码区间、摘要与嵌套子节,相当于一份”为 LLM 搜索优化的目录”;
- Retrieve(树上检索):LLM Agent 拿着问题在树上逐级判断”该进哪个分支”,只读取推理路径上到达的节点,最后给出带页码引用的答案。
2026 年 8 月 26 日发布的 PageIndex Flash 是本地默认索引器:它直接读取 PDF 自身的版式结构(标题、章节、页码),而不是让视觉模型从头推断大纲,因此建树又快又便宜;索引模型只需对已定位的章节做摘要,官方建议用便宜模型(如 gpt-5.6-luna),检索模型才用最强模型。SDK 把二者解耦:index= 指定建树模型,chat= 指定树上检索模型,换 chat 模型无需重建索引。
三、成本数据(官方实测口径)
建树成本:以 gpt-5.6-luna 为索引模型,本地建树约 $0.001/页;一本 1,000 页教科书一次性索引”一美元出头、几分钟”,之后所有问题复用同一棵树。同一批基准文档(9–1,098 页共 9 个 PDF)索引耗时约 13 秒到 4.5 分钟,随页数可预测地增长。
查询成本对比整份直喂:另一条路线是每次提问把整本 PDF 塞给模型。官方在”两条路线答案一致”的文档上测得(gpt-5.6-sol,不计 prompt cache):
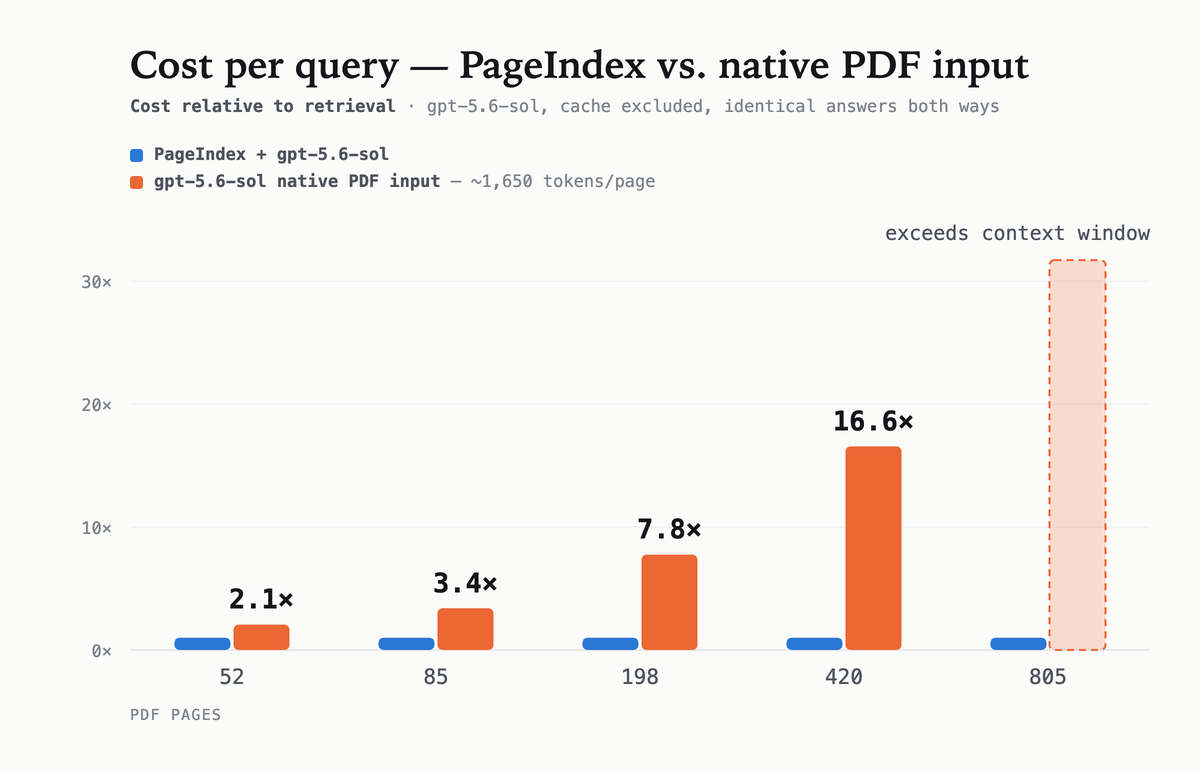
| PDF 页数 | 直喂成本倍数 |
|---|---|
| 52 | 2.1× |
| 85 | 3.4× |
| 198 | 7.8× |
| 420 | 16.6× |
| 805 | 超出上下文窗口,无法直喂 |
OSS 基准(PageIndex-OSS-Benchmark):本地 Flash、无 OCR,在取自 MMLongBench-Doc-V2 的 34 个 PDF(1,945 页)上做 62 个事实查找题;题目答案都是正文陈述的事实,所以答错归为”检索或阅读失败”而非推理失败。官方给出的成本-准确率阶梯:gpt-5.6-luna high 推理约 96.8%(单题约 $0.003 档),gpt-5.6-sol medium/high 推理达 100%(单题约 $0.10 档),每升一档模型成本约差一个数量级。
四、FinanceBench 98.7%:必须拆开看的口径
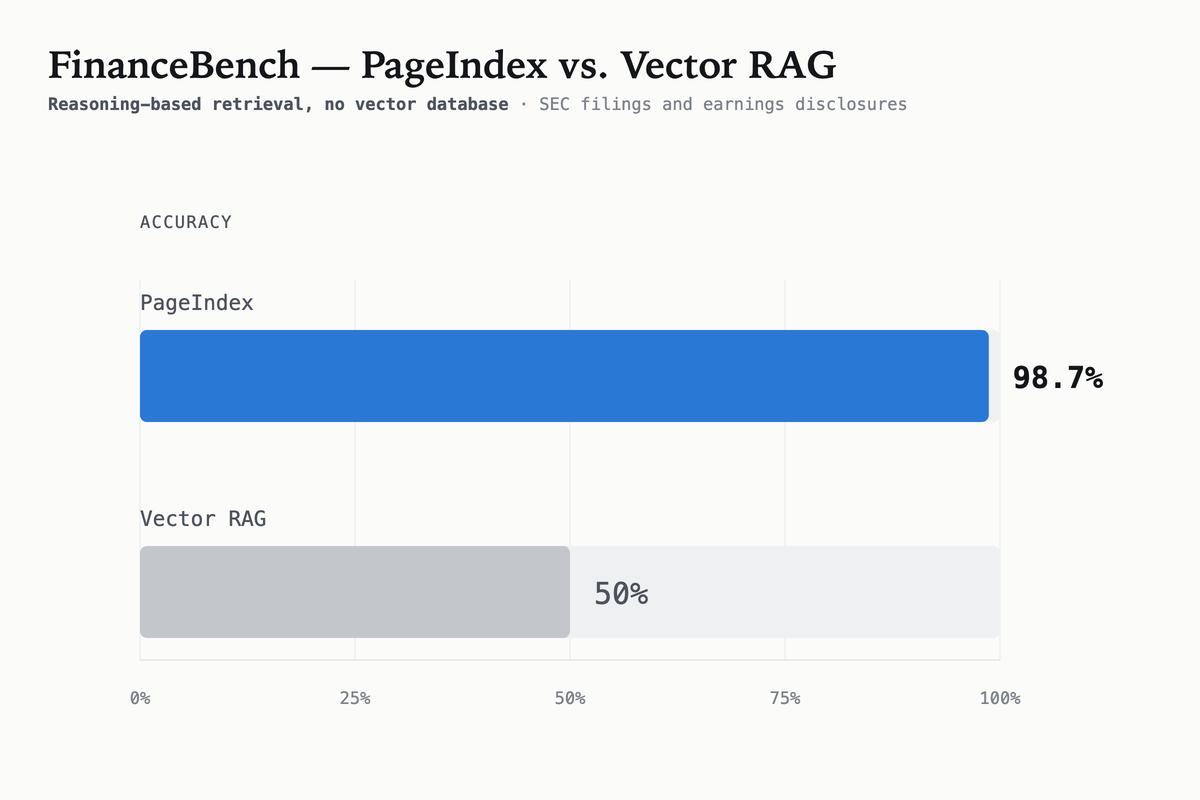
README 宣称在金融 QA 基准 FinanceBench 上达到 98.7% 准确率,远超向量 RAG 的 50%。但拆开自评仓库 Mafin2.5-FinanceBench 后需要注意四点:
- 98.7% 属于 Mafin2.5 系统,不是开箱即用的 PageIndex SDK。Mafin2.5 是作者基于 PageIndex 构建的金融专用 RAG 模型系统,98.7% 是这套系统在 FinanceBench 公开集上的成绩;
- “Vector RAG 50%“是作者自己搭的对照实现,不是 FinanceBench 官方排行榜数字,未公开其 chunk 大小、embedding 模型与召回配置;
- 竞品数字来源不一、口径不齐:表中 Quantly 94%(全量、结果未公开)、Fintool 98%(仅 66.7% 覆盖、未公开)、ChatGPT 4o+Search 31%、Perplexity 45%(均为 66.7% 覆盖,引自第三方文章),与 Mafin2.5 的全量 100% 并不可直接比较;
- 模糊题由作者方专家人工裁定,评估代码虽开源,但 ground truth 的人工判定环节无法独立复核。
自评仓库自己列出的局限也应转述:FinanceBench ground truth 本身存在歧义与错误;基准以单文档简单检索为主,缺少跨文档多步推理任务。模型演进上,官方称 Mafin 1 为 38.0%、Mafin 2.5 为 98.7%,并报告在 ChatGPT 4o 与 Deepseek v3 两个底座上都达到同样的 98.7%(均为自报)。
五、本地与云端分层
| 能力 | Local(开源 SDK) | PageIndex Cloud |
|---|---|---|
| 文档类型 | 文本型 PDF | 文本、扫描件、图片密集文档 |
| OCR / 图像理解 | 无 | 有 |
| 索引与存储 | 本机目录 | 托管 |
| 引用粒度 | 页级 | 块级 |
| 元数据 / 文件夹 | 无 | 有 |
| MCP server | 无 | 有 |
本地版要求文本型 PDF(管线直接读版式、不跑 OCR),扫描件必须上 Cloud;Cloud 还提供面向全语料的 PageIndex File System 文件级树索引层与 MCP server,模型层仍兼容你自带的 provider。
六、优势与局限
优势:
- 无需向量库与分块,索引是人类可读的目录树,检索路径可追溯、可解释;
- 建树便宜、一次建成反复用,长文档下查询成本不随页数线性膨胀;
- 本地可跑、数据不出机器,适合受监管文档工作流;索引模型与检索模型解耦,成本可控;
- 开源 MIT,可接入 OpenAI Agents SDK、Claude Agent SDK 等框架,也支持通过 Claude Code 订阅调用模型。
局限:
- 强项是单文档事实查找,跨文档多步推理是官方自认的基准空白,并非已经解决;
- 本地版不吃扫描件/图片 PDF,这类文档被迫进入付费 Cloud;
- 旗舰数字来自专用系统自评,开箱 SDK 的表现以 OSS 基准(96.8%–100% 区间)为准,不能把 98.7% 直接等同于 SDK 能力;
- 树上检索依赖强模型逐级判断,简单短文档场景相比向量 RAG 没有成本优势,反而多一次建树;
- 项目 2025 年才创立,API 与 Cloud 能力仍在快速变动。
七、适合谁
- 处理财报、招股书、法规、技术手册等长文本专业文档,且受困于向量召回”答非所问”的团队;
- 要求文档本地存储、不想引入向量数据库的合规场景;
- 需要可追溯引用(页码/章节)作为审计证据的金融、法务用户。
短篇文档、海量碎片化知识库、需要跨数千文档混合召回的场景,仍应优先评估成熟向量/混合检索方案。