OpenPipe ART:用 GRPO 给你的 Agent 做"在岗培训"
阅读时间: 大约 8 分钟
OpenPipe ART:用 GRPO 给你的 Agent 做”在岗培训”
ART(Agent Reinforcement Trainer)是 OpenPipe 开源的强化学习训练库,Apache-2.0 协议,作者团队以 Brad Hilton 为首(2025)。它的口号是”Give your agents on-the-job training”——不再靠堆 prompt,而是让多步 Agent 从自己的成败里学习。核心算法是 GRPO,支持 Qwen3.6、GPT-OSS、Llama 等主流开源模型。本文基于其 GitHub 仓库一手资料,拆解它怎么把 RL 塞进普通 Python 工程,以及那张”14B 小模型打过 o3”的图该怎么读。
一、背景:Agent 的下一个提升杠杆是 RL
大模型能力到了一定阶段,光靠换更强的基座模型或调 prompt 收益递减。OpenAI、DeepSeek 等已证明:把 RL(尤其是可验证奖励下的强化学习)用到 Agent 工作流上,能显著提升多步任务的可靠性。但自己搭 RL 训练循环门槛极高——要管 rollout、vLLM 推理、LoRA 更新、奖励设计。ART 想把这部分工程化。
二、是什么:客户端 + 服务器的解耦
ART 的设计是把”你的业务代码”和”重训练基建”分开:
- OpenAI 兼容客户端:留在你自己的代码库里。你像平时一样调模型跑 Agent 流程(通常并行多 rollout 以采数据),每条 system/user/assistant 消息被记成一条 Trajectory;
- GPU 服务器:在有卡的机器上跑,用 vLLM 加载模型最新的 LoRA 权重做推理,并在 rollout 结束后训练。
训练循环是:① 你的代码跑并行 rollout,请求被路由到 ART 服务器上最新 LoRA;② 一个 rollout 结束后,由你的代码给这条 Trajectory 打奖励分;③ 把成组轨迹发给服务器,推理暂停,服务器用 GRPO 从最新 checkpoint(首轮为空 LoRA)训练;④ 新 LoRA 存盘并热加载进 vLLM,推理恢复,进入下一轮。
也就是说,你不需要改写自己的 Agent 逻辑,只要在现有代码库里挂上 ART 客户端、再定义一个奖励函数,RL 就跑起来了。pip install openpipe-art,客户端在笔记本上、服务器起临时 GPU 环境或本地 GPU 都行。
它选 GRPO 而非经典 PPO 是有工程考量的:GRPO 对同一批(group)rollout 算出相对优势,省掉了 PPO 里那个额外的价值(critic)网络,显存占用和实现复杂度都更低,特别适合”一个任务跑多条轨迹再比较”的 Agent 场景。训练侧只更新 LoRA 适配器、不动全量权重,配合 vLLM 热加载,让”推理—训练—再推理”的切换足够快——这也是它敢把这套循环做成普通 Python 库的原因。
三、关键数据:ART·E 邮件 Agent
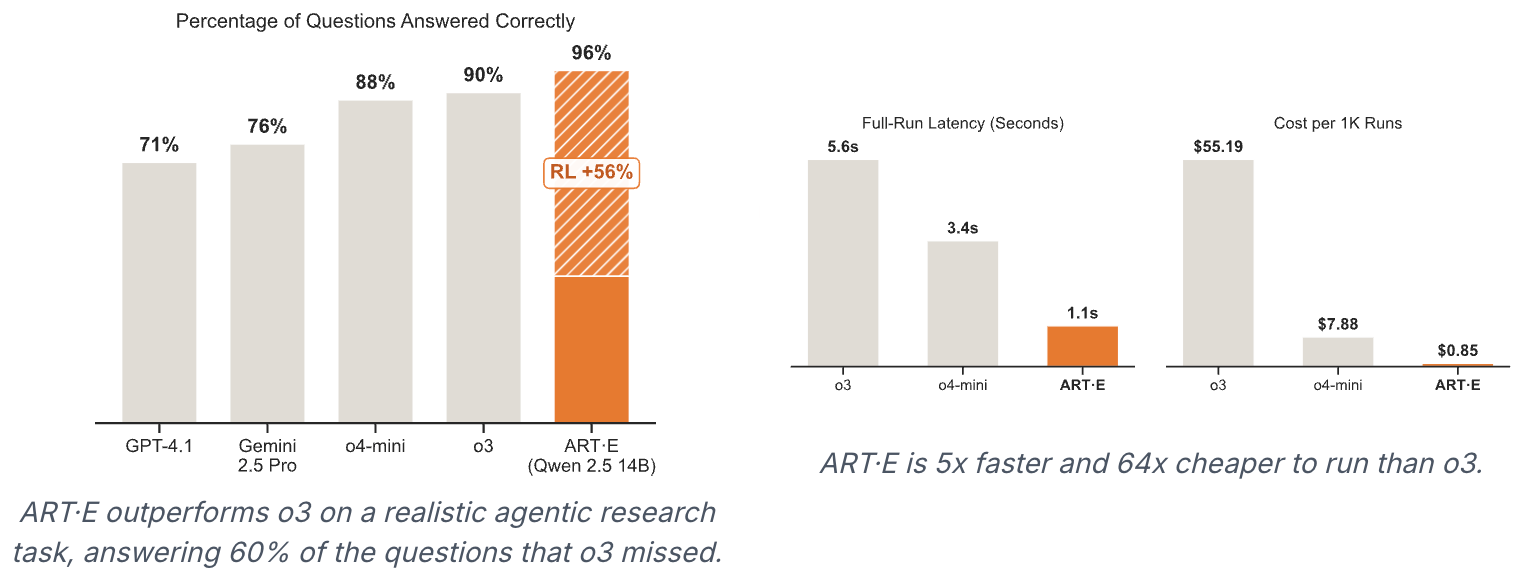
ART 仓库最有冲击力的是它的旗舰案例 ART·E:一个用 Qwen 2.5 14B 训练的邮件检索 Agent。官方对比图数据如下:
| 模型 | 答题正确率 | 全流程延迟 | 每千次运行成本 |
|---|---|---|---|
| GPT-4.1 | 71% | — | — |
| Gemini 2.5 Pro | 76% | — | — |
| o4-mini | 88% | 3.4s | $7.88 |
| o3 | 90% | 5.6s | $55.19 |
| ART·E(Qwen 2.5 14B,RL 后) | 96% | 1.1s | $0.85 |
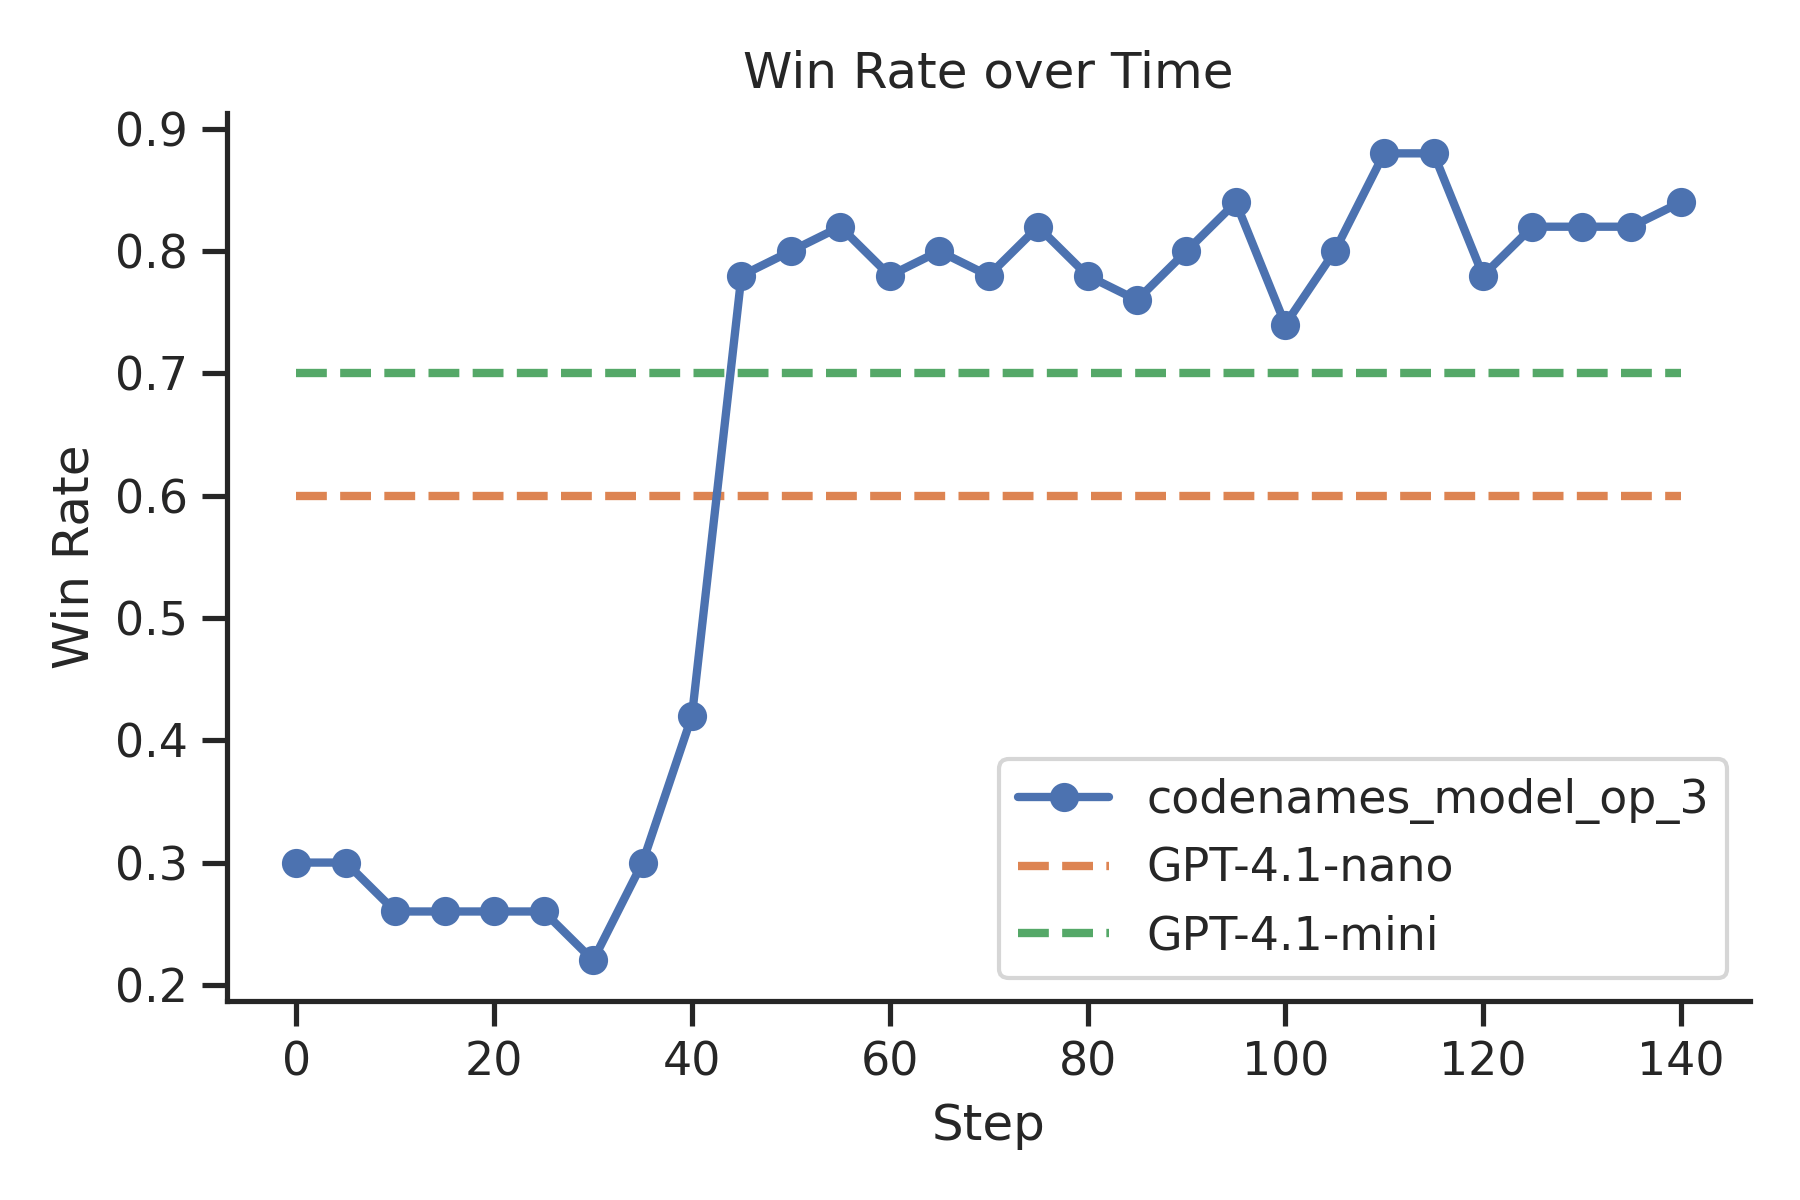
官方据此宣称:ART·E 在一个真实的 agentic 研究任务上比 o3 快约 5 倍、便宜约 64 倍,并”答对了 o3 漏掉的 60% 问题”。仓库还附了 2048、井字棋、Codenames(随训练胜率上升)、LangGraph 邮件 Agent、MCP·RL 等一系列 notebook。
四、评测方法批判:这张图的边界在哪
这个结果很漂亮,但必须拆清口径:
- “打过 o3”只在一个特定任务上成立:是”邮件检索/研究”这一个 agentic 任务,不是通用推理基准(没有 MMLU、AIME 之类)。换个任务,14B 小模型未必还能赢 o3;
- 96% 是 RL 微调后的数字:图上的 “RL +56%” 说明提升来自训练,基座 Qwen 2.5 14B 原始分远低于此——这证明的是”RL 有效”,不是”Qwen 天生比 o3 强”;
- 5x/64x 是该任务上的自算值:延迟与成本高度依赖模型规模、部署方式与并发,不是普适倍数;
- W&B Serverless 的”成本降 40%、训练快 28%“是 WandB 的服务营销口径:共享推理集群、2000+ 并发是其托管服务的卖点,与 ART 框架本身的开源能力是两回事;
- 不是所有模型都支持:官方明确说 Gemma 3 暂不支持,且依赖 vLLM/HF-transformers 或 Unsloth 兼容的因果模型。
五、优势与局限
优势: 一是把 GRPO 训练循环抽象成 OpenAI 兼容客户端,业务代码几乎不用改;二是奖励函数由你自己定义,RULER 还能自动生成奖励,降低手写 reward 的门槛;三是从 3B 小游戏到 27B 真实 Agent 都有 notebook 可复现;四是与 W&B、Langfuse、OpenPipe 打通可观测性,Serverless 模式省去 GPU 运维。
局限: RL 本身贵——要跑大量 rollout、占 GPU、推理与训练交替阻塞,不是笔记本随手能跑;奖励函数设计质量直接决定训练上限,reward 写错就会刷出”会钻空子”的模型;框架仍在快速迭代(76 open issue、102 PR),API 可能变动;它是训练工具,不是即开即用的产品。还要注意,GRPO 是 on-policy 方法:每轮都要用当前策略重新采样 rollout,不能像 SFT 那样吃一份静态数据集反复训,因此 GPU 时长与推理调用量都会随任务复杂度线性上升,这也是 Serverless 模式被主推的现实原因。
六、谁该关注
- 有明确业务闭环、可自动打分的 Agent 团队:例如客服、检索、代码工具调用,能用真实任务奖励持续微调自己的模型;
- 想摆脱闭源 API、追求低成本低延迟:ART·E 证明了 14B 开源模型经 RL 后可在特定任务上媲美顶级闭源模型;
- 做 RL/Agent 研究的工程师:ART 提供了一个能跑通、可读的 GRPO 工程样板。
如果你的任务无法自动判定对错(没有可验证奖励),ART 这类 RL 框架就使不上劲——那类场景还是先把 prompt 与 RAG 做好更划算。