Mooncake:Kimi 背后那套「以 KVCache 为中心」的推理基建
阅读时间: 大约 11 分钟
Mooncake:Kimi 背后那套「以 KVCache 为中心」的推理基建
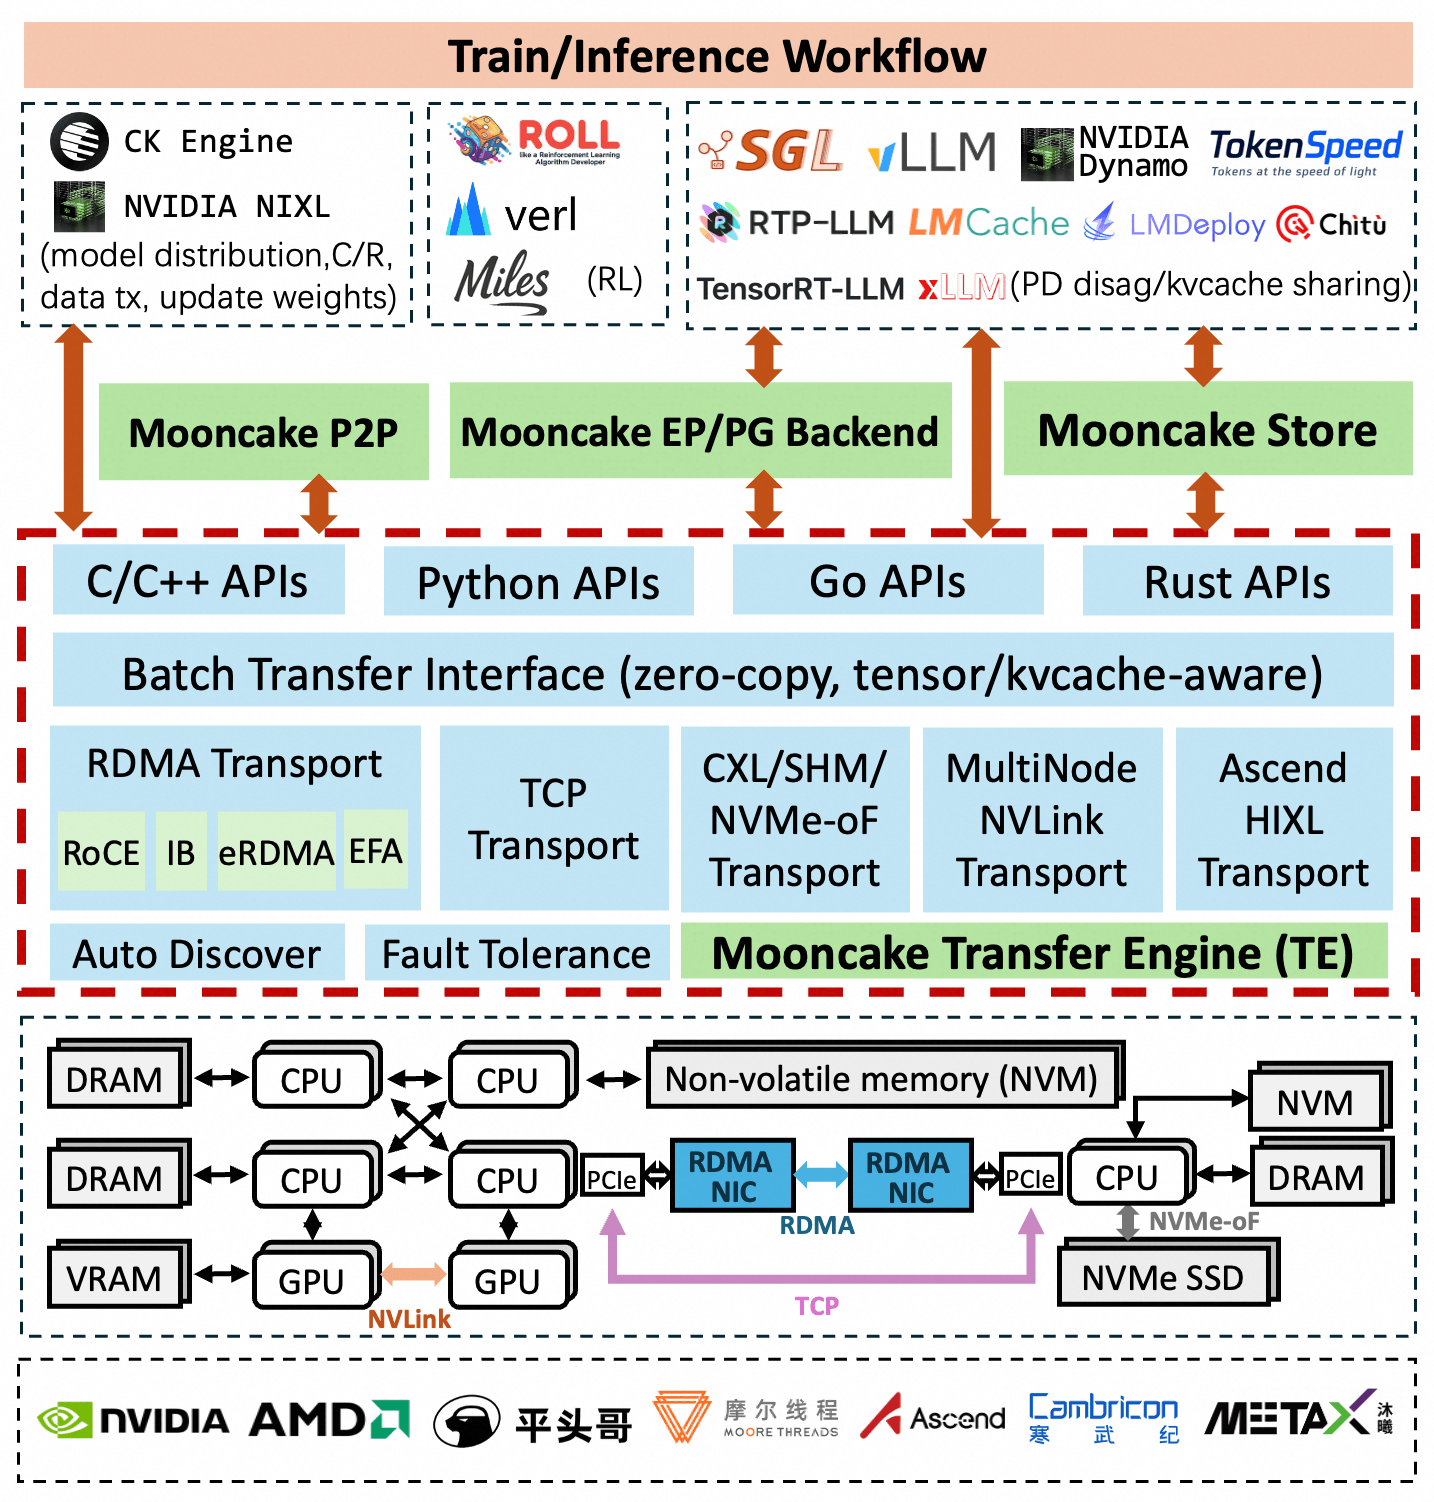
当一个国产大模型聊天服务要扛住成百上千路并发对话时,瓶颈往往不在「单次推理算得多快」,而在「上下文重复计算太多、KV Cache 跨机器搬不动」。Mooncake 就是月之暗面(Moonshot AI)为 Kimi 自研、后于 GitHub 开源(kvcache-ai/Mooncake,Apache-2.0)的那套基础设施。它的论文《Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot》发表于 USENIX FAST 2025(pp. 155–170)。本文基于其官方仓库与文档,梳理它到底解决了什么问题、由哪几块组成,以及哪些数字是 Kimi 自家生产口径。
一、背景:LLM 推理的两个老问题
LLM 服务在真实负载下有两个结构性痛点。其一,prefill(处理提示词)与 decode(逐词生成)对资源的需求不同:prefill 是计算密集、吃算力,decode 是内存带宽密集、吃显存带宽——把两者混在同一批 GPU 上调度,会互相拖累。其二,多轮对话与长提示词里存在大量重复前缀(系统提示、历史对话、RAG 文档),如果每个请求都重新 prefill,等于把 GPU 算力反复花在早已算过的 token 上。
Mooncake 的思路一句话概括:用更多存储换更少计算——把 GPU 集群里平时闲置的 CPU、DRAM、甚至 SSD 利用起来,搭一个分布式的 KVCache 池,让 prefill 结果可以跨实例复用;同时把 prefill 集群和 decode 集群拆解开(PD 分离)。官方称,在 Kimi 的真实工作负载下,这套架构让 Kimi 在满足 SLO 的前提下多处理了 75% 的请求——注意这是 Moonshot 自己生产环境的口径,没有第三方审计。
二、三大组件:Transfer Engine、Store、EP/PG
根据仓库 README,Mooncake 由三块组成,自下而上:
- Transfer Engine(TE,传输引擎):核心。一个高性能数据传输框架,对上提供统一的批量传输接口(zero-copy、感知 tensor/KVCache),对下屏蔽多种网络与加速器——RDMA(RoCE、InfiniBand、eRDMA、AWS EFA)、TCP、CXL/SHM/NVMe-oF、多机 NVLink、昇腾 HIXL。特性包括拓扑感知路由、多网卡带宽聚合、自动故障切换。
- Mooncake Store:建在 TE 之上的分布式 KVCache 与模型权重存储引擎,负责对象存储、副本、淘汰(eviction)与高带宽搬运。
- Mooncake EP 与 PG:把能力从「数据搬运」延伸到「容错的分布式执行」,面向大规模 MoE 推理。EP 做专家并行的 dispatch/combine,PG 是一个 PyTorch 分布式 process-group 后端,能探测失败 rank、上报并在不重启整个服务的前提下恢复 rank。
它已经和 SGLang、vLLM 深度集成:vLLM 官方在 2026 年 5 月专门介绍了 Mooncake Store 作为跨实例 KV Cache 共享后端;SGLang 则用它做 PD 分离下的 KV 传输、多级缓存 HiCache、容错专家并行,以及 RL 训练里的权重同步。
三、关键数据:官方性能图与生产数字
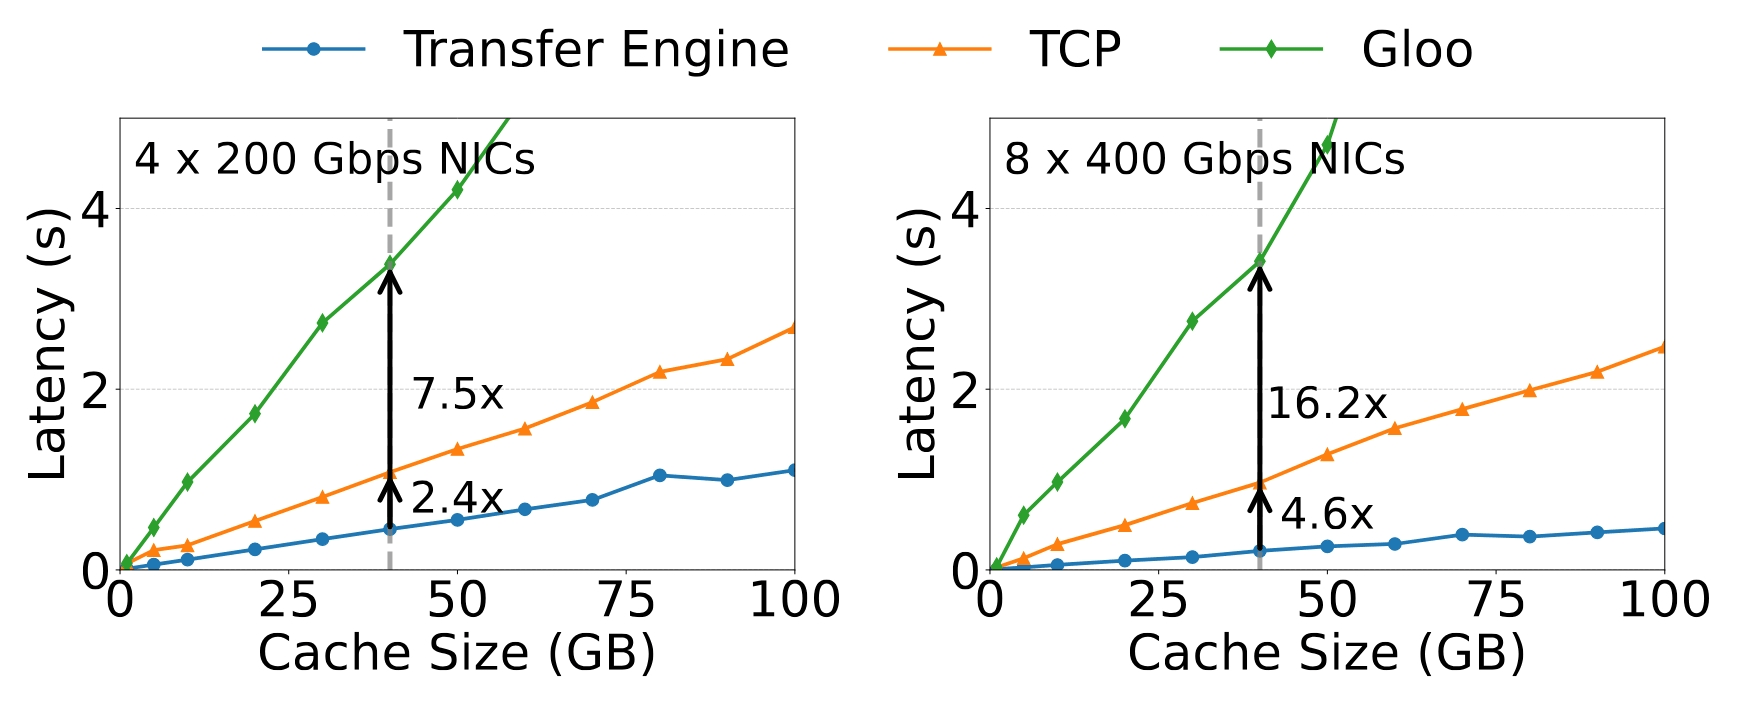
最值得看的官方图是 Transfer Engine 的传输时延对比(下图):在固定缓存规模下,TE 相对 TCP、Gloo 的时延优势随网卡带宽放大而急剧拉大。
把仓库里可核对的数字汇总如下:
| 指标 | 官方数字 | 口径 |
|---|---|---|
| Kimi 生产吞吐提升 | 满足 SLO 下多处理 75% 请求 | Moonshot 真实工作负载自述,非第三方 |
| TE vs TCP(4×200Gbps,~40GB) | 时延低约 2.4× | 仓库官方 benchmark 图 |
| TE vs Gloo(4×200Gbps,~40GB) | 时延低约 7.5× | 同上 |
| TE vs TCP(8×400Gbps,~40GB) | 时延低约 4.6× | 同上 |
| TE vs Gloo(8×400Gbps,~40GB) | 时延低约 16.2× | 同上 |
| Kimi-K2(1T)权重更新 | 53s → 7.2s(约 7×) | SGLang + Mooncake TE 跨数千 GPU 零拷贝 RDMA |
工程交付物方面:pip install mooncake-transfer-engine(区分 CUDA 12 / 13 / NPU / ROCm / MUSA / EFA 等多个 wheel),Docker 镜像 kvcacheai/mooncake:0.3.14;仓库共 32 个 release、约 370 位贡献者,C++ 占 79.3%。官方还开源了脱敏后的真实请求 trace(请求到达时间、输入/输出 token 数、重映射后的 block 哈希),以及两个工具:KV Cache Size Calculator(估算各模型族的缓存容量)和 KV Cache Hit Rate Simulator(规划缓存容量)。
四、评测口径与需要警惕的地方
- 「75% 更多请求」:写在 README 首页,属于 Kimi 自家生产负载下的结论,SLO 阈值、负载构成、对比基线都未公开,适合作为「量级参考」而非可复现结论。
- TE 性能图的偏向:对比对象是 TCP 与 Gloo。Gloo 是 PyTorch 生态里的 CPU collective 通信库,并非为跨机大缓存搬运设计,在大缓存规模下时延近乎线性爆炸——选它做对照天然放大了 TE 的优势;真正生产里的对手是 NCCL、自研 RDMA 栈,那张图里并未出现。
- 硬件门槛高:TE 的 2.4×~16× 优势建立在多张 200/400Gbps RDMA 网卡、NVLink、NVMe-oF 之上;在普通 TCP 局域网、单台机器上,这些数字基本不成立。
- 迭代极快、版本尚未稳定:README 的 updates 列表排到 2026 年 8 月,仍在频繁接入新场景(AgentX/InferenceX v3、Miles、Speculators、TorchSpec),API 与部署形态可能快速变动。
五、适用与不适用
适合:
- 已经有多机 GPU 集群、跑 SGLang/vLLM、做 PD 分离或跨实例 KV 复用的中大型推理团队;
- 做大规模 RL 训练/rollout,需要在推理 worker 与 trainer 之间高速搬 hidden-state、同步权重;
- 需要 MoE 大模型的容错专家并行(单点 rank 挂掉不重启整个服务)。
不适用:
- 个人开发者、单卡或小机器跑模型——这是数据中心级基建,不是 Ollama 式本地工具;
- 没有 RDMA/高速网络、又想白嫖那十几倍传输提升的团队——网络不达标时收益大打折扣;
- 追求开箱即用、不愿读部署文档的小团队——它需要 master/store/worker 一整套组件。
六、客观分析:优势与局限
优势:它把 LLM 推理里「被浪费的存储」和「被闲置的 CPU/DRAM/SSD」变成了可复用的 KVCache 资产,并用一个统一的传输引擎把 GPU、CPU、NVM、RDMA 网卡拧成一张网;背靠 Kimi 日活级真实流量打磨,又被 vLLM/SGLang 收编为主流后端之一,生态位很扎实。对国产算力(昇腾、寒武纪、摩尔线程、平头哥、沐曦)的适配广度,在同类项目里少见。
局限:复杂度与门槛高,是「基建队」的工具而非「应用开发者」的工具;核心亮眼数字多为厂商自测或自家生产口径;且项目仍在高速演化,API 稳定性与文档成熟度需要持续跟进。
七、它意味着什么
Mooncake 代表了超大规模 LLM 服务的一个共识方向:推理优化的重心正从「把单张 GPU 算得更快」转向「把 KV Cache 与跨节点数据流动管好」。它把月之暗面在 Kimi 上踩出来的工程经验开源出来,客观上也成了国产大模型 infra 对外输出的一张名片。对做推理系统、尤其要做多机 PD 分离或 RL 的团队,Mooncake 已经是绕不开的参照实现。