Mirrord:让本地进程"冒充"集群 Pod,把云环境搬到你的调试器里
阅读时间: 大约 8 分钟
Mirrord:让本地进程”冒充”集群 Pod,把云环境搬到你的调试器里
在 Kubernetes 时代,后端开发者常卡在一个两难里:本地起一套依赖数据库、队列、下游服务的完整环境,成本高、易过时;直接把代码部署到云端 staging 再调试,又慢且危险——一次错误改动可能影响整组共享环境的同事。MetalBear 出品的 mirrord(GitHub 5.3k Star、MIT 协议、Rust 编写)给出第三条路:让你的本地进程”冒充”集群里的某个 Pod,把它的网络流量、文件系统和环境变量代理到你本机。本文基于官网、文档与仓库,拆解它怎么做到的,以及这份”魔法”背后的代价。
一、它是什么:OS 级的”本地进程 + 集群上下文”
mirrord 官网的一句话定义是:让你的整个团队对着一个真实环境开发,每个开发者和 AI agent 从第一行代码起就连上真实的 API、数据库与服务。仓库 README 的技术描述更直白——在你本机跑任意进程,但 mirrord 把它的流量、文件、环境变量都路由到集群里的一个目标 Pod 上。它工作在操作系统层,不需要改代码、不需要语言插件,因此官方称可接任意语言、任意 IDE、任意 Kubernetes 集群。
二、技术机制:Operator + CLI + 目标 Pod 代理
接入分三步,全部是命令行:
- 平台团队在集群装 Operator:
helm install mirrord-operator mirrord/mirrord-operator,由它管理会话、RBAC、流量路由与隔离,让多人安全共享一个环境; - 开发者装 CLI:
brew install metalbear-co/mirrord/mirrord(也可在 IDE 里点一下); - 接管目标:
mirrord exec --target deployment/my-service -- <启动命令>,本地进程随即以该 Deployment 为目标运行。
底层上,mirrord 在目标 Pod 侧启动一个代理(agent),把本机进程的出站连接导向集群内真实服务,并把入站流量按模式镜像(mirror)或拦截(steal)到本机;文件系统与环境变量也从 Pod 透传。它使用你本机默认的 kubeconfig 访问 Kubernetes API,因此权限边界和你自己的集群账号一致。
三、关键数据:这些数字大多是官方自测口径
| 项目 | 数字 | 口径 |
|---|---|---|
| GitHub Star / Fork | 约 5.3k / 219 | 2026-09-30 查看仓库页 |
| 累计提交 | 约 3,695 | 仓库页,Rust 编写,活跃维护 |
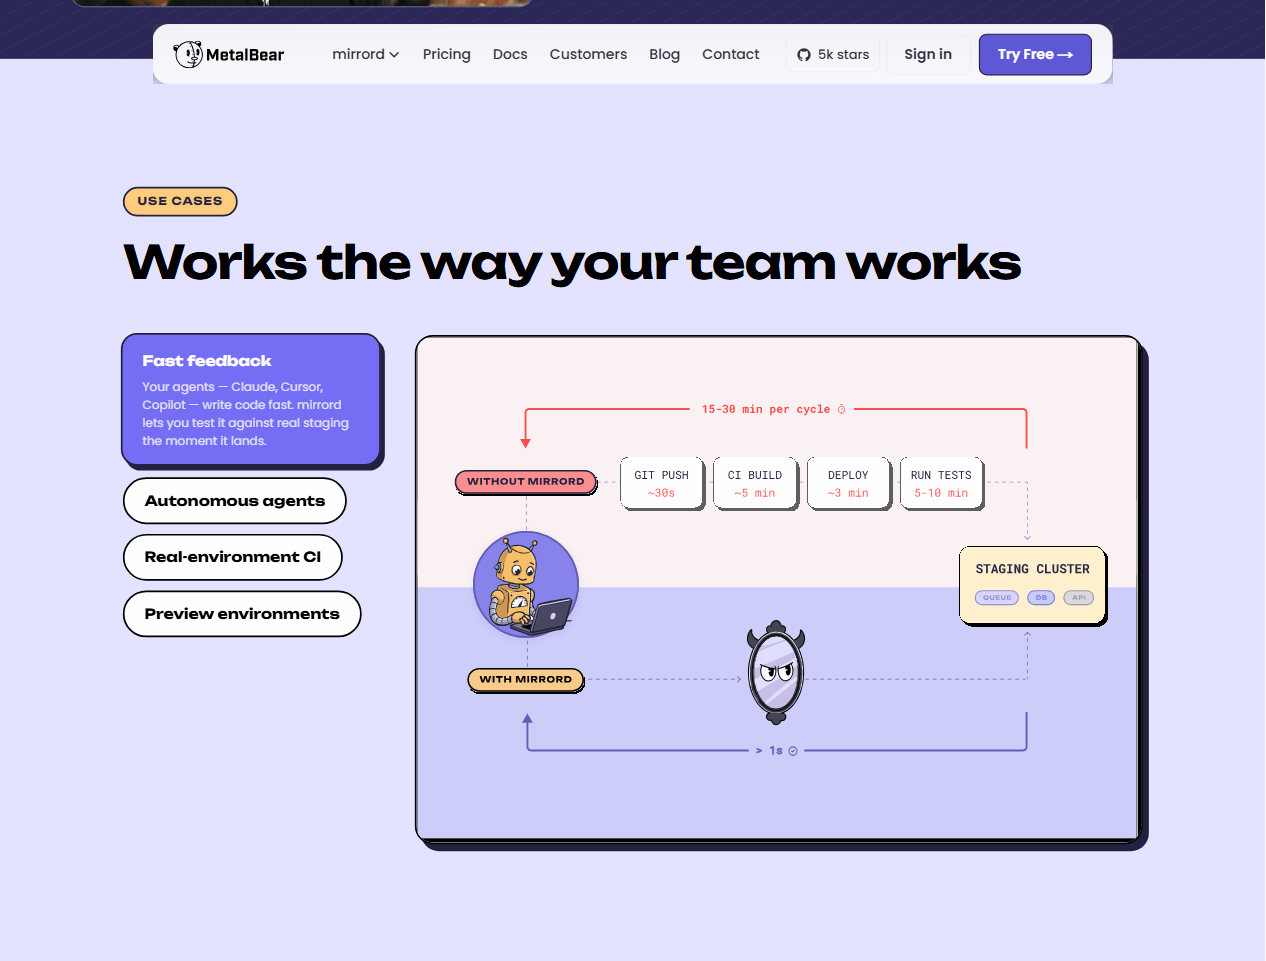
| 无 mirrord 循环 | 约 15–30 分钟/次 | 官方示意图:push ~30s + CI ~5min + 部署 ~3min + 测试 5–10min |
| 有 mirrord 反馈 | 约 >1 秒 | 官方”直连 staging”示意 |
| 开发循环提速 | 官方称 98% | 案例研究口径,非通用基准 |
| 接入耗时 | 官方称”15 秒内” | 已有 operator 与 staging 集群的前提 |
| 协议 | MIT(核心) | 企业能力(RBAC/会话/共享集群隔离)走商业层 |
需要强调:表中 15–30 分钟与 1 秒的对比来自官网营销示意图,把”push→CI→部署→测试”整条流水线压缩进一次循环,再与”本地直接连 staging”对比——这是一个理想化叙事,实际收益取决于你的 CI 时长、服务依赖数量与网络延迟。
四、为什么现在火:它恰好接住了 AI Coding Agent 的痛点
mirrord 的叙事重心已经转向 AI agent:当 Claude Code、Cursor、Copilot 在分钟级批量生成 PR 时,最大的瓶颈是”怎么验证这段代码真的能跑”。传统验证要等部署与 CI(小时级),mirrord 让 agent 把进程挂到真实 staging 上秒级得到通过/失败反馈。官网引用了 Claude Code 作者 Boris Cherny 的观点:给 agent 一个验证其工作的反馈回路,能把最终结果质量提升 2–3 倍——这正是 mirrord 想提供的回路。
五、局限与口径:别被”15 秒接入”遮蔽代价
- steal 模式会影响真实流量。 拦截(steal)模式会把本应发给目标 Pod 的请求导到你本机;若目标是共享 staging,你的调试可能让同事收到错误响应或重复处理请求。官方 Operator 的 RBAC 与隔离正是为多人共享设计的,但配错风险真实存在。
- 额外的集群与权限复杂度。 它不是”零依赖”:需要在集群里跑 operator/agent、需要 kubeconfig 权限、某些文件系统/网络拦截在 Linux 上需要额外权限;项目库点评即指出,这套代理式调试引入了新的运维复杂度。
- 对比数字是营销口径。 “98% 提速""15 秒接入”都以已有 operator、已有 staging 集群、理想网络为前提,不应外推到所有团队。
- open core。 核心 MIT 开源,但团队级会话管理、RBAC、共享环境隔离、企业支持属于 MetalBear 的商业层;大团队真实用起来,付费几乎是必然。
- 不是唯一选项。 官网自己也并列了 Telepresence、Bridge to Kubernetes、Signadot 等替代方案;选型应按”是否需要 AI agent 秒级反馈”这一核心诉求来定,而不是只看速度数字。
六、适用 / 不适用场景
适合:微服务/分布式后端团队,依赖多、本地起不全;用 AI coding agent、需要快速验证改动;希望直接在真实(预发)依赖上调试而不部署;已有 Kubernetes 与平台工程能力。
不适合:单体或本地即可跑全依赖的小项目;没有 Kubernetes 平台能力、连 operator 都维护不动的团队;对 staging 稳定性极敏感、不允许流量被个人进程拦截的生产环境调试。
七、它意味着什么
mirrord 把”远程开发”从”把代码部署上去”变成”把环境拉到本地”,本质是用 OS 级代理换反馈速度。在 AI agent 大量写代码的今天,它的价值不再只是开发者调试效率,而是给自动化代码提供一条”秒级验证回路”。代价是额外的集群组件与权限模型——想清楚你是否真的需要这条回路,再决定要不要为它引入这层复杂度。