llmfit:探测你的硬件,替你从 879 个本地模型里挑出能跑的
阅读时间: 大约 8 分钟
llmfit:探测你的硬件,替你从 879 个本地模型里挑出能跑的
本地跑大模型这两年从极客玩具变成了真实需求,但选型方式还停留在”翻论坛帖子 + 一个个试”。AlexsJones 开源的 llmfit 想把这件事工程化:它是一个用 Rust 写的终端工具,先自动探测你的 CPU、系统内存、显卡显存与加速器,再把目录里数百个模型按四个维度打分,直接告诉你哪几个在你这台机器上真的跑得动。本文基于其 GitHub README 与官方 TUI 截图,拆解它怎么打分、接哪些后端,以及”估算”和”实测”之间的差距。
一、它解决什么痛点
一个典型用户的问题是:“我这台 128GB 的机器,到底能跑哪些开源模型?该选哪个量化?“答案取决于参数规模、上下文长度、量化格式、显存/内存带宽的交叉计算,手算很容易错。llmfit 把这道题自动化:探测硬件 → 建模型兼容性 → 给出排序后的推荐。
二、它怎么打分
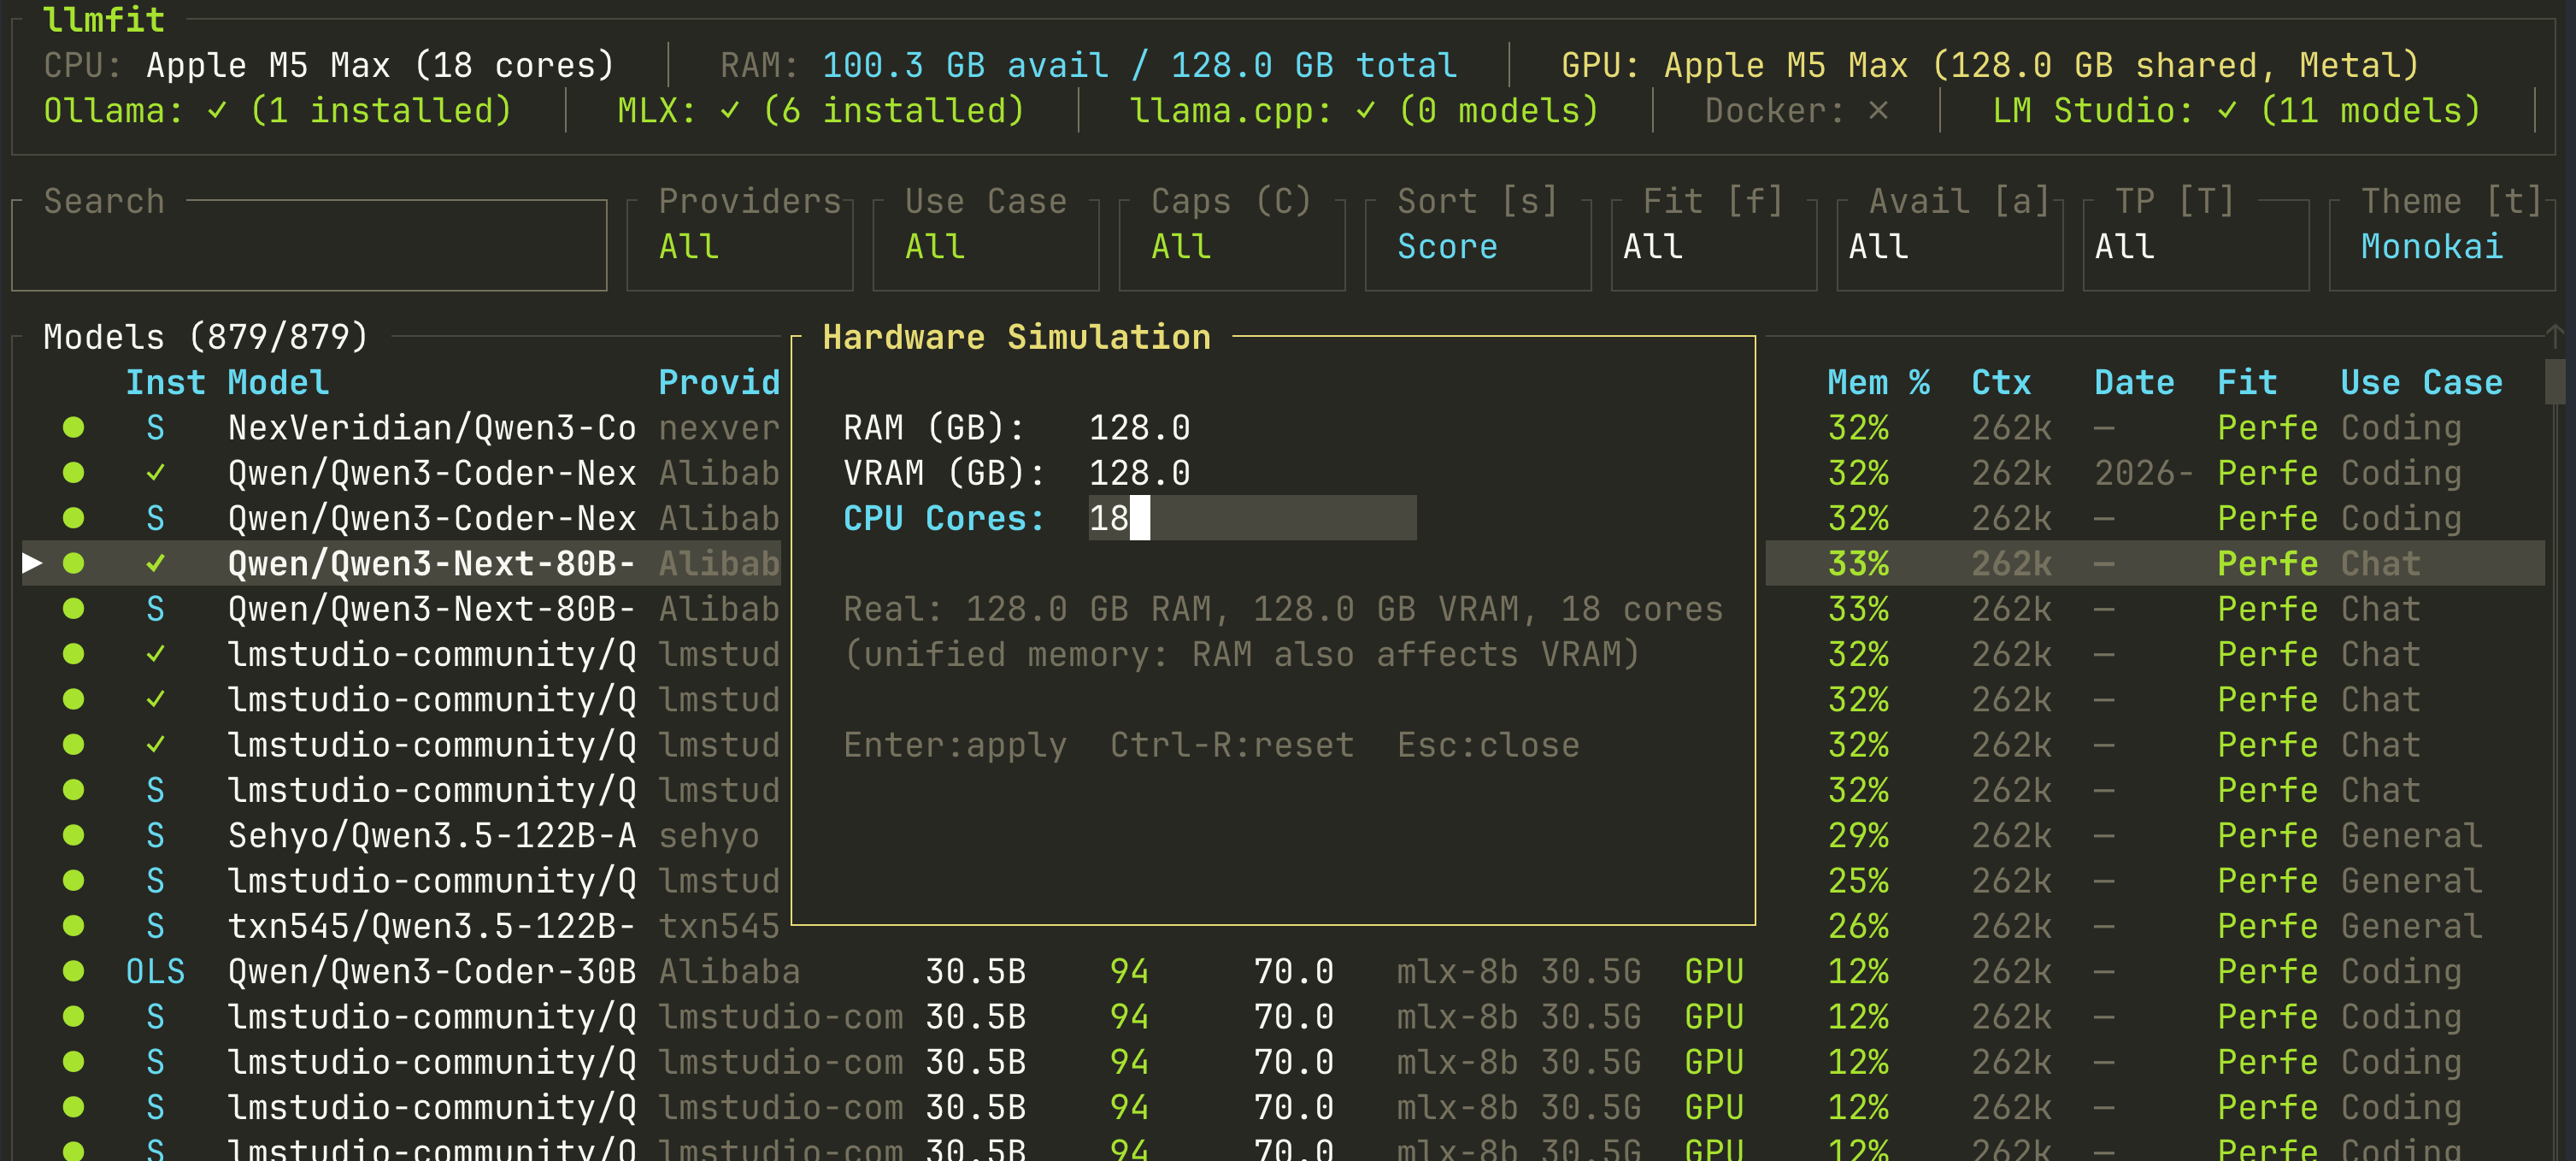
从截图能看到它的工作方式:
- 顶部自动探测:截图里识别出 CPU 是 Apple M5 Max(18 核)、RAM 100.3GB 可用/128GB 总量、GPU 是 M5 Max 统一内存(128GB shared, Metal);同时扫描已装的运行时——Ollama 装了 1 个、MLX 装了 6 个、LM Studio 里有 11 个模型。
- 四维评分:每个模型按 memory fit(装不装得下)、estimated speed(跑多快)、quality(质量)、context(上下文多长) 打分,目录里显示 879/879 个模型。
- 硬件模拟器:中间那个 “Hardware Simulation” 面板可以手动调 RAM/VRAM/CPU 核数,实时看 fit 变化——等于在买新硬件前先”云预测”升级后的效果。
- 量化自适应:支持 GGUF、AWQ、GPTQ、EXL2 等格式,自动推荐合适的量化档位。
速度估算的来历值得说明:官方称它来自一个基于内存带宽的模型,并用运行时采样与社区实测校准。关键是它”每个估算都附带输入参数”——llmfit info <model> 会显示这个数字假设了什么、怎么在本机验证。这比给一个拍脑袋的 tok/s 数字要诚实。
三、接哪些后端与形态
llmfit 不自己跑模型,而是当选型层:
- 运行时后端:Ollama、llama.cpp、MLX、Docker Model Runner、LM Studio、vLLM;
- 三种形态:交互式 TUI(默认)、经典 CLI(
llmfit recommend、llmfit fit、llmfit info、llmfit bench)、Web Dashboard + REST API(/api/v1/system、/api/v1/models),方便接编排系统; - 跨平台:macOS(Apple Silicon/Intel)、Linux(x86_64/ARM64)、Windows(x86_64);
- 安装:scoop / Homebrew / MacPorts / uv(pip) / Docker 镜像皆可。
它还支持多 GPU、MoE 架构识别、SSD 容量规划(llmfit storage --keep 3)。
四、社区实测:把估算变成实测
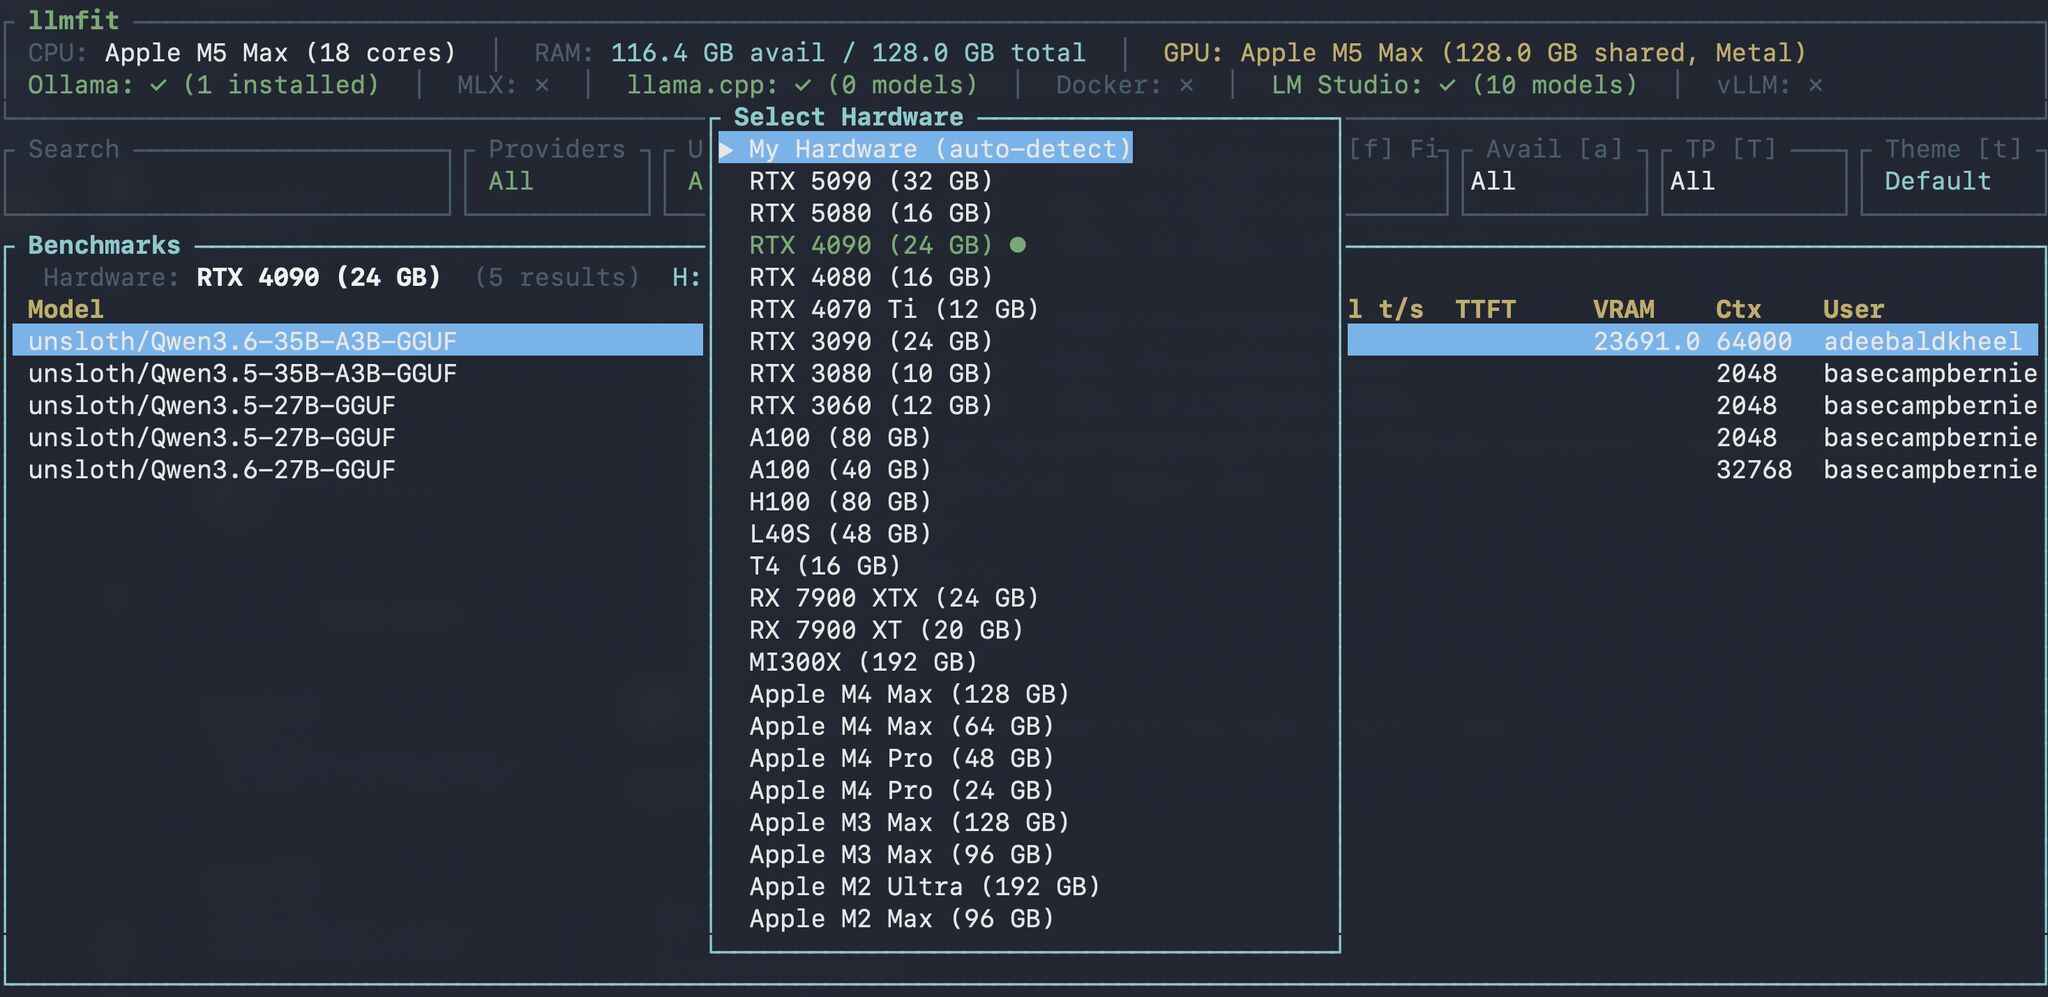
README 最有意思的新功能是”benchmark & share”:你在本机下载一个模型、起服务、用 llmfit bench 测真实 tok/s 与 TTFT,再用 llmfit bench --share 把结果以 PR 形式贡献回项目——不需要 gh CLI、不需要第三方账号。每次运行先本地保存,你自己的实测会替换掉 fit 表里的估算值;合并后随下一个版本发布,和你同硬件的人在自己跑 benchmark 之前就能看到标了 ✓ 的实测数字。上面第二张图就是这个社区榜:按硬件档位(RTX 5090 32GB 一直到 Apple M2 Max 96GB)列出不同用户在具体模型上测得的 tok/s、TTFT、VRAM、上下文。
五、口径与局限
- 估算不是实测:在没有社区实测数据的机型上,速度列是带宽模型推算的。官方诚实地让每个估算可追溯,但推算和真实 tok/s 之间仍有差距——
llmfit bench的存在本身就承认了这一点。 - Windows 二进制可能未签名:官方通过 SignPath 做 Authenticode 签名,但只有完整签名流水线成功才签名;如果签名被跳过或失败,发布物可能是未签名的 Windows 包。需要签名的人应自行校验。
- 它是选型器,不是运行器:llmfit 帮你选模型、看 fit,但真正的推理仍交给 Ollama/llama.cpp/MLX 等后端;别把它当推理引擎。
- 对比工具的盲点:官方自己推荐的替代品 llm-checker 走的是”真用 Ollama 拉模型跑一遍”的实测路线,但不支持 MoE——把 Mixtral/DeepSeek-V3 这类 MoE 当稠密模型算内存,会高估需求。llmfit 明确支持 MoE,这是它的差异点。
- 模型库靠社区维护:新模型要加进目录需贡献 PR,冷门或新出模型可能尚未收录。
六、适用与不适用
适合:刚入手本地大模型、不知道自己机器能跑什么的用户;想在买新内存/新卡前做”硬件模拟”预判的人;需要把选型结果接进自动化流水线(REST API)的团队;想把自己实测分享出去帮到同硬件用户的人。
不适合:已经有固定后端、只想要一个”直接拉模型跑”的工具(llm-checker 那类更直接);对速度数字精度要求极高、不接受带宽模型估算的人(那就自己 llmfit bench 实测)。
七、它意味着什么
llmfit 代表了本地大模型生态走向成熟的一个侧写:当模型数量爆炸到几百个、硬件配置千差万别,“选型”本身成了一个需要专门工具解决的问题。它的聪明之处在于两点:一是把”四维评分 + 可追溯的带宽估算”做成了透明的工程模型,而不是黑盒推荐;二是用 bench --share 把社区实测沉淀成公共数据,让”和我一样的机器实际能跑多快”这件事第一次有了众包答案。对本地玩家而言,它把过去靠论坛试错的选型,压缩成了一条命令 + 一个 TUI。