Lightpanda:用 Zig 从零写的、为 AI Agent 而生的 headless 浏览器
阅读时间: 大约 10 分钟
Lightpanda:用 Zig 从零写的、为 AI Agent 而生的 headless 浏览器
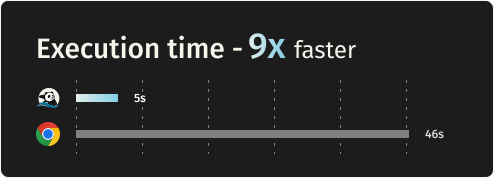
现代网页自动化早就不是发个 HTTP 请求那么简单:SPA、无限滚动、React/Vue/Angular 都靠 JS 渲染。于是业界普遍拿完整的 Chromium 跑 headless 模式来爬数据、做测试、驱动 AI Agent。问题是——一个完整桌面浏览器跑在服务器上,几百上千个实例一起压,RAM 和 CPU 根本扛不住。Lightpanda 的回答是:不要再 fork Chromium 了,从零写一个专为自动化的浏览器。它用 Zig 编写,官方宣称比 Chromium 轻 16 倍、快 9 倍。本文基于官方 README 与基准数据,拆解它的机制、口径与真实边界。
一、背景:为什么 Chromium 不适合大规模 headless
Lightpanda 在 “Why Lightpanda” 里把痛点讲得很清楚:在服务器上跑完整桌面浏览器虽然能用,但不好扩展——吃内存吃 CPU、难打包部署维护、而且 headless 场景下很多图形功能根本用不上。当自动化是几百上千个并发实例时,“用 Chrome” 这个默认选项在成本上就不成立了。
二、是什么:不是 Chromium 分支,而是新造的浏览器
官方在标题下就把立场写死了:“Not a Chromium fork. Not a WebKit patch. A new browser, written in Zig.” 它的关键技术取舍:
- 不用 Chromium / Blink / WebKit,从零用 Zig(一门显式内存控制的底层语言)写;
- 没有图形渲染引擎——headless 自动化不需要把页面画成像素;
- JS 仍用 V8,HTML 解析用 Servo 系的 html5ever,HTTP 加载用 libcurl。
也就是说,它保留了现代 web 自动化最刚需的东西(真实 JS 执行、DOM、网络栈),砍掉了最重的图形渲染与布局分支。
三、技术机制:CDP 兼容 + 原生 Agent/MCP
Lightpanda 没有逼你换工具链,而是直接兼容现有自动化生态:
- CDP 服务器:默认
127.0.0.1:9222,Puppeteer 通过browserWSEndpoint连上来即可,其余脚本几乎不改; - WebDriver Bidi:
--protocol webdriver即可启用; - Dump 模式:
lightpanda fetch --dump html|markdown|png|pdf直接把页面转成文本/Markdown/图片/PDF; - Agent 模式与 MCP:内置
lightpanda agent可用自然语言驱动浏览器,输出是一份叫 PandaScript 的确定性 JS——用 LLM 原型、但产物运行时不再需要模型,token-free 且可重放;同时提供 MCP server(stdio 或 HTTP),支持多会话隔离。
四、关键数据:官方基准的真实数字
官方基准的工况是:在 AWS EC2 m5.large 上,通过网络请求 933 个真实网页。核心对比表如下:
| 指标 | Lightpanda | Headless Chrome | 差距(官方口径) |
|---|---|---|---|
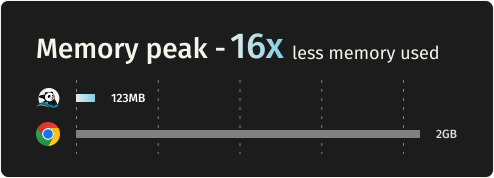
| 峰值内存(100 页) | 123MB | 2GB | 约 16 倍更少 |
| 执行时间(100 页) | 5s | 46s | 约 9 倍更快 |
五、评测方法批判:基准是”爬虫负载”,不是”全功能页面”
Lightpanda 这组数字很漂亮,但要读出口径:
- 测的是”请求 933 个真实网页”的爬虫/抓取负载,指标是”100 页的执行时间与峰值内存”——这是它的目标场景(爬虫、数据提取、Agent 浏览),不是完整渲染一个重交互 SPA、截图、录视频的场景。
- 对比对象是 Headless Chrome,且没有说明 Chrome 的版本、flags、是否关掉了自身的 headless 优化;“16x/9x”是官方在自家 demo 仓库(lightpanda-io/demo)里跑出来的,机型固定为 m5.large、过真实网络。
- 没有图形渲染是它省内存的根本原因,也是它的能力上限:当你的任务需要真实截图、视觉回归测试、或渲染 Canvas/WebGL 时,Lightpanda 反而不能用——它的
--dump png/pdf是”文本渲染”路线,不等同于 Chrome 的像素级截图。 - Web 平台兼容性靠每日跑 Web Platform Tests(WPT)公布在 perf.lightpanda.io,但 README 的功能清单里很多 DOM API 仍是”部分支持”,复杂站点的 JS 能不能跑通要逐站验证。
六、口径偏差与官方自承认的局限
这一节全是官方自己写明的坑:
- 遥测默认开启:README 明确 “By default, Lightpanda collects and sends usage telemetry”,必须设
LIGHTPANDA_DISABLE_TELEMETRY=true才关闭——自部署到对数据出网敏感的内网时要注意。 - glibc 绑定,Alpine/musl 跑不起来:Linux 发行版二进制链接 glibc,在 Alpine 等 musl 系统上会报
cannot execute: required file not found;Android/Termux 同样不行(Bionic libc 缺动态链接器)。官方建议用 debian/ubuntu 基础镜像。 - 没有原生 Windows 二进制:Windows 用户必须在 WSL2 里跑,好在 WSL 会自动转发
localhost:9222。 - 它是 nightly/快速演进项目:发布走 nightly tag,不是稳定版节奏;生产前要锁定版本并做兼容性验证。
七、适用与不适用场景
适合:
- 大规模网页抓取、数据提取、把网页转 Markdown 喂给 LLM 的管线;
- AI Agent 的浏览后端——内存/成本敏感、要跑成百上千并发实例;
- 已有 Puppeteer/Playwright 脚本、想在爬虫类负载上大幅降本的团队。
不适合:
- 需要真实像素截图、视觉回归测试、Canvas/WebGL 渲染的前端测试;
- 跑在 Alpine/musl 或 Android、又不想换基础镜像的环境;
- 要求稳定 API、长期不随 nightly 漂移的生产关键路径。
八、客观分析与谁该关注
优势:从零设计 + 无渲染引擎,在抓取/Agent 场景下把 headless 浏览器的内存与时延压到 Chromium 的零头(官方工况 123MB vs 2GB、5s vs 46s);兼容 CDP 让 Puppeteer/Playwright 平滑接入;PandaScript “LLM 原型、无模型生产”的思路对 Agent 工程很有价值。局限:省内存的代价是砍掉了渲染与重交互能力,复杂站点兼容性仍在追 WPT;遥测默认开、glibc/Windows 有门槛、项目仍处 nightly 阶段。如果你是做爬虫或 AI Agent 后端、被 Chromium 集群成本压得头疼,Lightpanda 值得用自己的目标页面集做一轮 A/B;但需要像素级渲染或要在 musl/原生 Windows 上跑的场景,Chromium 仍是更稳的选择。