Langfuse:被 ClickHouse 收编的开源 LLM 可观测与评测平台
阅读时间: 大约 11 分钟
Langfuse:被 ClickHouse 收编的开源 LLM 可观测与评测平台
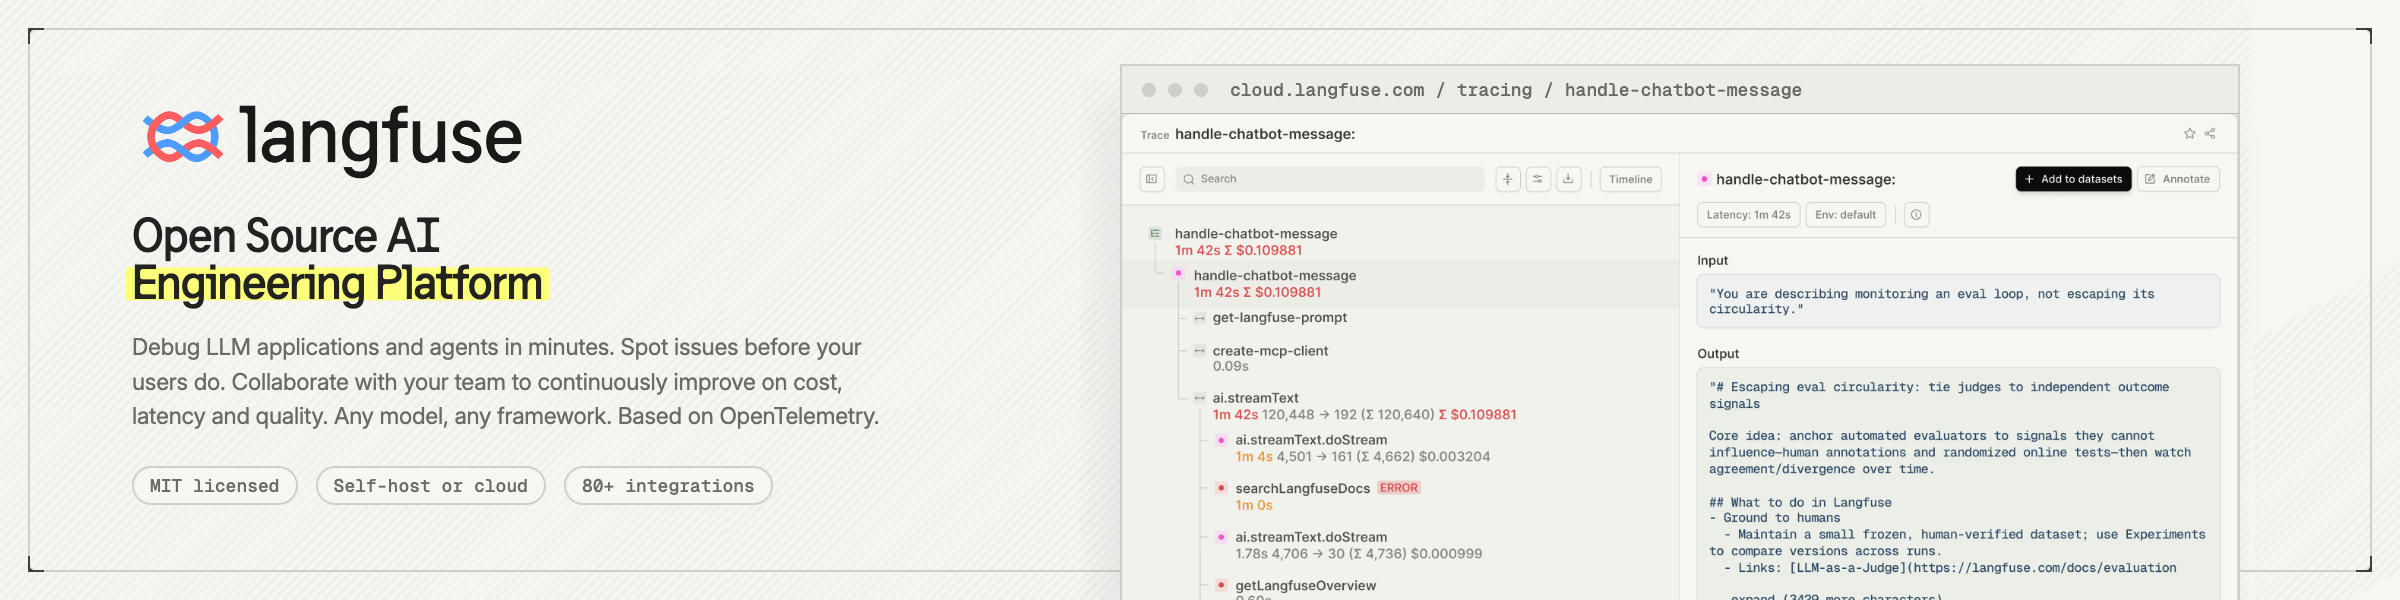
当 LLM 应用从 demo 走向生产,团队最先缺的往往不是模型,而是「眼睛」:一次请求里经历了哪些检索、调用了几次模型、花了多少钱、哪一步超时、输出为什么变差。Langfuse 就是来当这双眼睛的——一个开源的 LLM 工程平台,把可观测、prompt 版本管理、自动评测、数据集基准、playground 和开放 API 收进同一套系统。2026 年 1 月起,它正式成为 ClickHouse 旗下项目(README 开篇即「since January 2026 we’re part of ClickHouse」,并强调「Proudly made with ClickHouse」)。本文基于其 GitHub 仓库(langfuse/langfuse)梳理它做什么、怎么部署,以及开源协议与自托管的真实门槛。
一、它把 LLM 工程拆成六件事
根据 README「Core Features」,Langfuse 的六大模块是:
- 可观测(Observability):用 SDK 或 OpenAI/LangChain/LlamaIndex 等集成埋点,把 LLM 调用、检索、embedding、Agent 动作作为 trace ingest 进来,可检查复杂日志与用户会话;
- Prompt 管理:集中管理、版本化、协同迭代 prompt,并靠服务端与客户端强缓存,让换 prompt 不增加线上延迟;
- 评测(Evaluations):支持 LLM-as-a-judge、代码评测器、用户反馈收集、人工标注,以及通过 API/SDK 自定义评测流水线;
- 数据集(Datasets):维护测试集与基准,用于部署前测试、结构化实验,与 LangChain/LlamaIndex 无缝对接;
- LLM Playground:在 trace 里看到坏结果可一键跳进 playground 调 prompt 与模型参数;
- 完整 API:提供 OpenAPI、Postman collection 与 Python、JS/TS 类型化 SDK,用来搭自建 LLMOps 流水线。
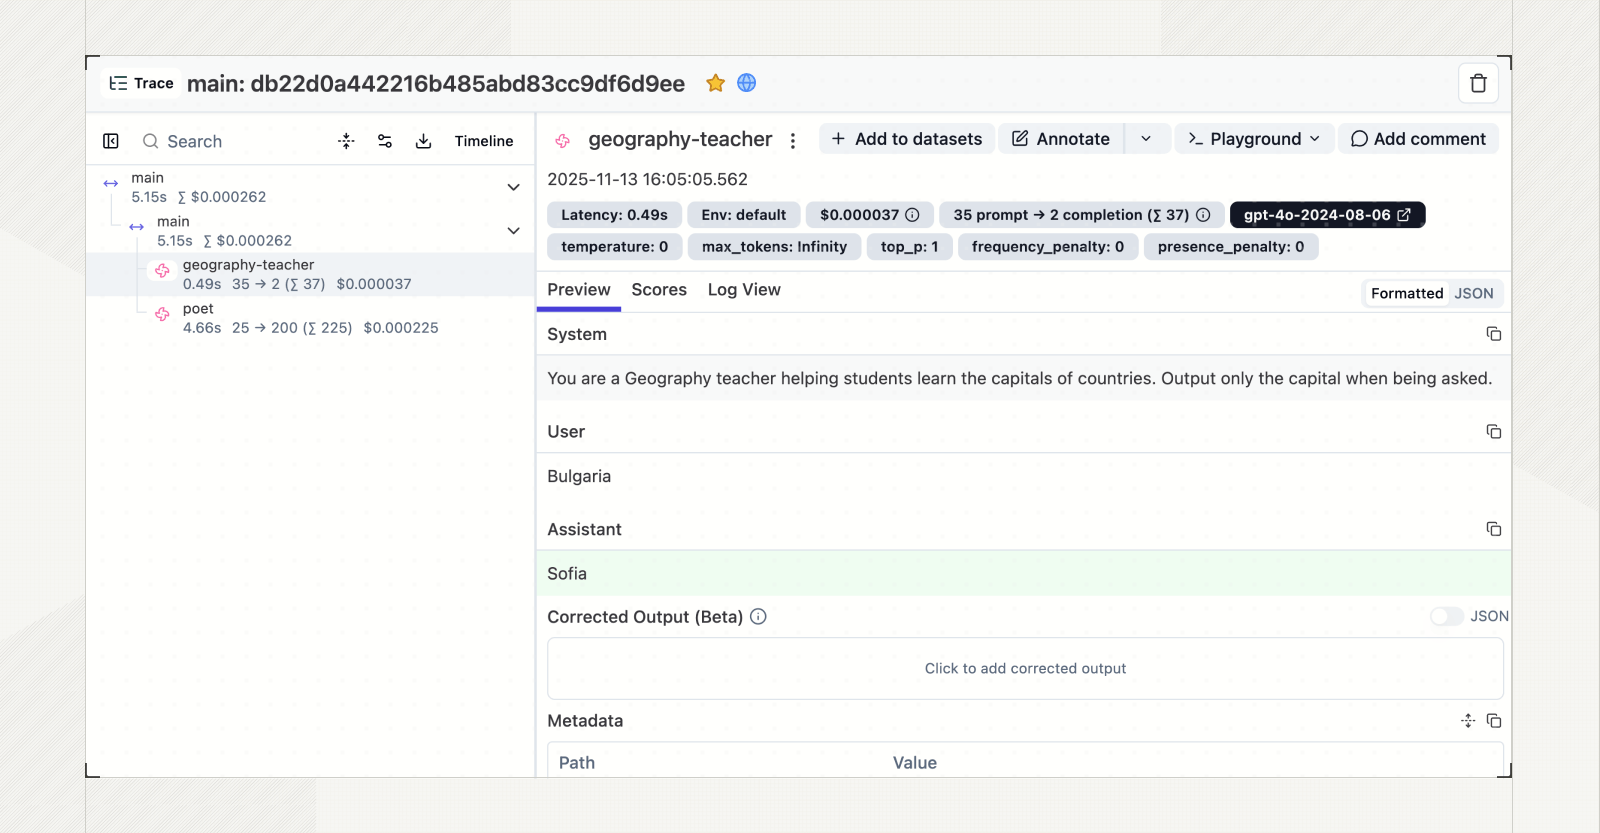
埋点非常轻:Python 里 pip install langfuse openai,用 @observe() 装饰器包住函数、再用 langfuse 封装的 OpenAI client,就能自动把模型参数、token、成本收进 trace。它还提供 EU(cloud.langfuse.com)与 US(us.cloud.langfuse.com)两个云区域,满足数据驻留要求。
二、生态位置:谁在用它
README 公布了「按 star 排序、使用 Langfuse 的开源项目」榜单,能直观看到它的渗透度:
| 使用 Langfuse 的开源项目 | 公开 star(约) |
|---|---|
| langflow | 116k |
| open-webui | 109k |
| screenshot-to-code (abi) | 70k |
| lobe-chat | 65k |
| ragflow (infiniflow) | 64k |
| firecrawl | 57k |
| LlamaIndex (run-llama) | 44k |
| Flowise | 44k |
| LiteLLM (BerriAI) | 29k |
| langfuse 自身 | 约 16k |
集成面覆盖主流框架:OpenAI SDK drop-in、LangChain、LlamaIndex、Haystack、LiteLLM、Vercel AI SDK、Mastra;并被 Instructor、DSPy、Mirascope、Ollama、Bedrock、AutoGen、Dify、Flowise、Langflow、OpenWebUI、Promptfoo、Gradio、CrewAI 等包所集成。README 称有 80+ 集成。
三、部署:五分钟起来,生产另说
README 给了三条路:
- Langfuse Cloud:官方托管,慷慨免费档、无需信用卡;
- 自托管(docker compose):
git clone --depth=1后docker compose up,官方称 5 分钟在本机跑起来; - 生产形态:单 VM 用 Docker Compose,Kubernetes 用 Helm(官方称这是生产首选),并提供 AWS/Azure/GCP 的 Terraform 模板。
需要特别注意的是,README 自己在部署章节就发了告警:默认 docker-compose.yml 继承 Docker daemon 的 json-file 日志驱动,默认不轮转,会把磁盘写爆;必须配置 max-size/max-file,且这只覆盖容器 stdout,不覆盖数据库与 ClickHouse 自身日志。这从侧面说明:自托管 Langfuse 背后是 Postgres + ClickHouse + web + worker + 对象存储的一套系统,「五分钟 demo」和「生产运维」之间有明显落差。
四、许可证与口径:open core,不是全 MIT
这是选型时最该看清楚的一条:仓库主体是 MIT,但 ee/ 目录(企业版)不在其列。也就是说,它是典型的「核心开源、企业功能闭源」的 open core 模式。团队规模、SSO/SCIM、细粒度权限、审计等能力往往落在 ee 一侧,自托管版能用多少,需要对着官方 pricing/self-host 文档逐项核对,不能想当然认为「MIT 就全免费」。
其他需要分开看的口径:
- 「battle-tested」「80+ 集成」是市场表述;真正决定选型的是它是否覆盖你的语言栈与模型网关。
- 它是可观测/评测平台,不是模型网关——做不到限流、路由、密钥管理那一层;要那一层得和 LiteLLM 等网关搭配。
- 2026 年 1 月并入 ClickHouse 后,产品方向大概率会向 ClickHouse 商业化(云数仓、计费)倾斜;长期自托管路线是否与云版同步,需观察。
- trace 是高写入、高存储负载,随调用量线性增长;自托管的 ClickHouse 容量与保留期策略,才是长期成本大头。
五、适用与不适用
适合:
- 已经在生产跑 LLM 应用、需要统一 trace、成本与时延留痕的团队;
- 想把「LLM-as-judge + 人工反馈 + 数据集回归」做成闭环、持续迭代 prompt 的团队;
- 需要数据驻留(EU/US 区域或完全自托管)、又不想从零搭可观测栈的团队。
不适用:
- 个人小项目/玩具 demo——为几条调用搭一套带 ClickHouse 的系统过重;
- 想要开箱即用企业 SSO/权限、又不愿为 ee 版付费的团队;
- 把它当 LLM 网关用的团队——职责错位。
六、客观分析:优势与局限
优势:在开源 LLM 可观测赛道里,Langfuse 的完成度与生态集成(80+)属于第一梯队,trace/prompt/eval/dataset/playground 一体化,且基于 OpenTelemetry、支持自托管与云双形态;背靠 ClickHouse 后,海量 trace 的存储与查询有了数据库大厂背书。
局限:open core 协议意味着关键企业能力要付费;自托管不是「一个容器」那么轻,ClickHouse+Postgres 的运维、日志轮转、容量规划都要自己扛;并入 ClickHouse 后的路线仍在演变中,选型时应把「未来是否被推向云版」纳入考量。
七、它意味着什么
Langfuse 的走红,本质上是 LLM 工程成熟的信号:团队的竞争焦点正从「用哪个模型」转向「怎么把每一次调用观测、评测、并持续改进」。它把过去散落在各框架里的日志、成本、人工反馈,收敛成一个可协作的平台。对任何要把 AI 应用带上生产的团队,Langfuse(或同类的 Helicone、LangSmith)已经是基础设施级别的必选项——只是要在动手前,先想清楚走云版、自托管社区版、还是为企业版付费这三条路的边界。