KubeShark:用「故障模式优先」治住 LLM 写 K8s 清单时的幻觉
阅读时间: 大约 13 分钟
KubeShark:用「故障模式优先」治住 LLM 写 K8s 清单时的幻觉
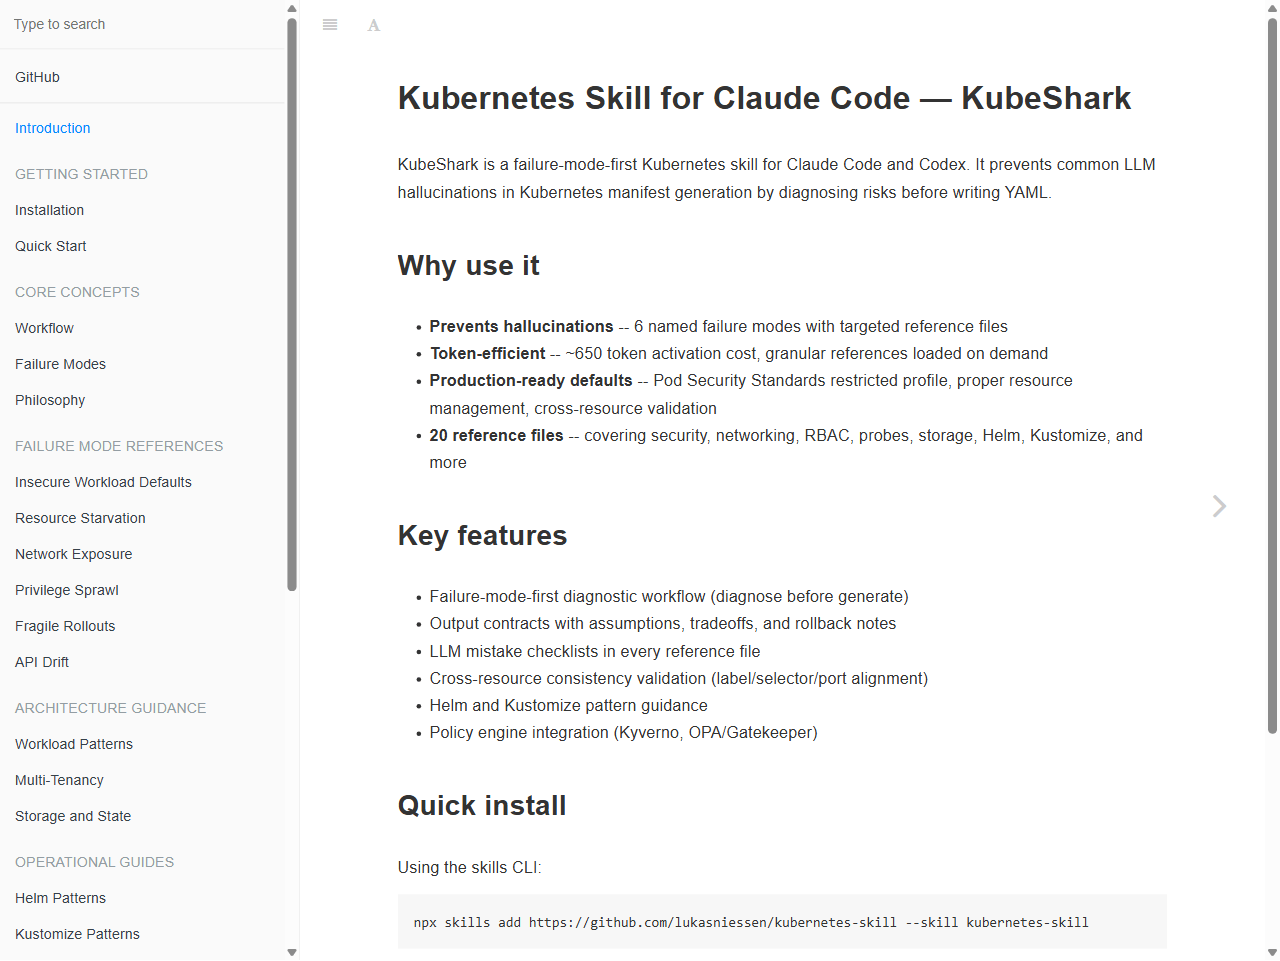
让大模型直接写 Kubernetes YAML 很爽,但它写出来的东西往往「能 apply、能跑、却不安全」:以 root 运行、忘了 requests/limits、Service selector 和 Pod label 对不上却不报错、Ingress 还在用 Kubernetes 1.22 就删掉的 extensions/v1beta1。KubeShark(作者 Lukas Niessen,MIT 协议)是一个专门给 Claude Code 和 Codex 用的「Skill」,它的核心主张是:别让模型一上来就写 YAML,先按 6 类已知故障模式诊断风险,再动手。本文基于其官方文档,拆解这套方法到底做了什么、有效在哪,以及它的边界。
一、它要解决的问题:LLM 不是不懂 K8s,而是复制了错误默认值
KubeShark 把问题归因得很直白:LLM 的训练语料里充满了博客和 Stack Overflow 上的「能跑就行」的示例——上游示例和 Helm chart 默认值极少带 securityContext,模型就照抄这些宽松配置。它的口号是 failure-mode-first(故障模式优先):写 YAML 之前,先判断这次任务会触发哪几类生产事故。
二、六类命名故障模式
KubeShark 把风险收敛成 6 个「有名有姓」的故障模式,每一类都配一份专门的参考文件,并明确写了「症状 → 常见成因 → 风险剧本」:
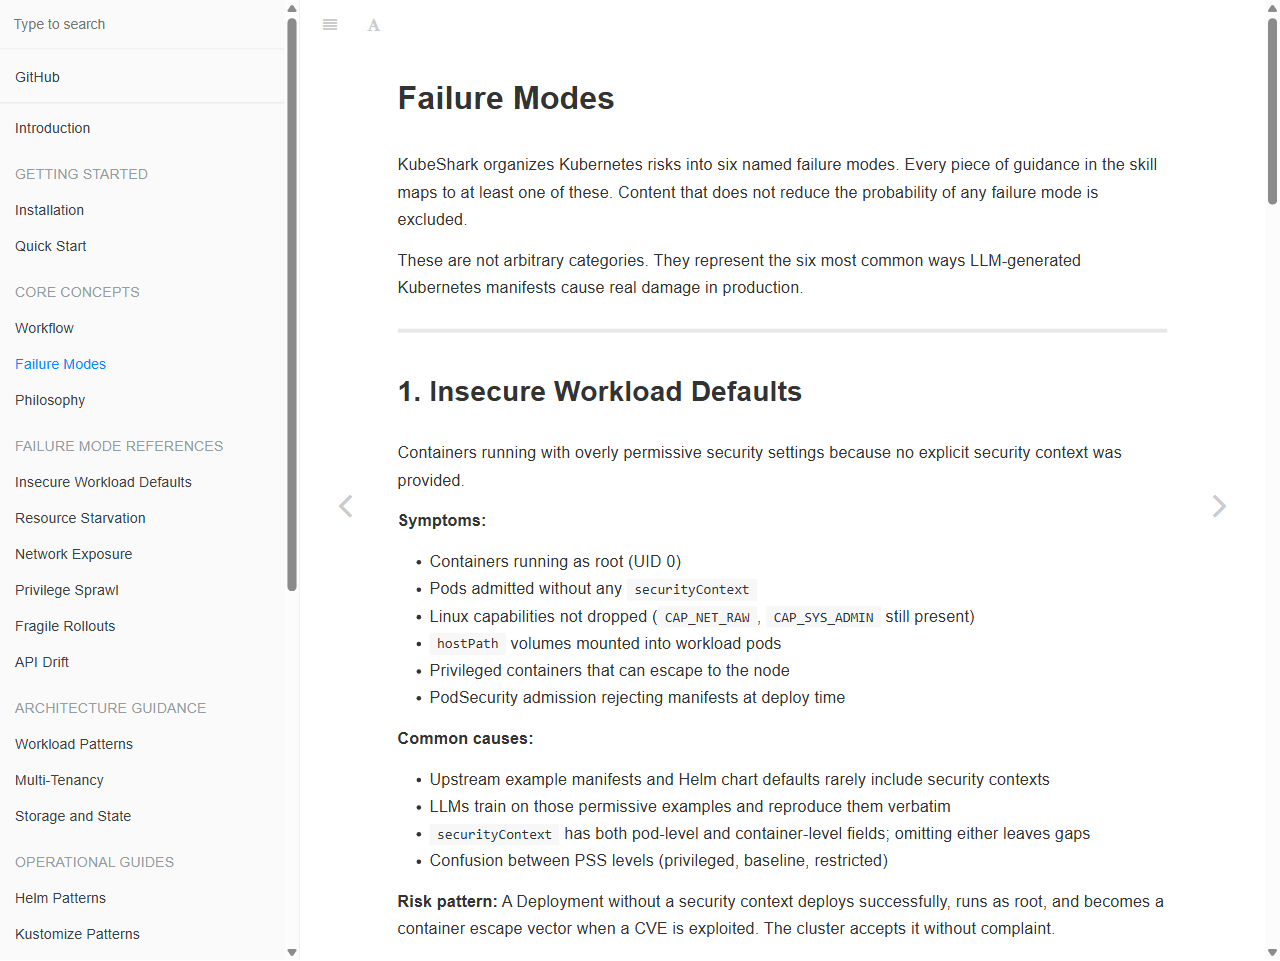
- Insecure Workload Defaults(不安全的工作负载默认值):容器以 root 运行、没有 securityContext、没 drop
CAP_NET_RAW/CAP_SYS_ADMIN、挂了 hostPath。风险剧本:一个没 securityContext 的 Deployment 顺利部署、以 root 跑,一旦被打 CVE 就变成容器逃逸入口,而集群全程不报错。 - Resource Starvation(资源饥饿):完全没写 requests/limits(BestEffort QoS,第一个被驱逐)、拍脑袋写
cpu: 1、没有 PDB、CPU limit 贴太近导致 CFS 限流。风险剧本:Pod 在超卖节点上被 kubelet 驱逐,新 Pod 又落到另一个超卖节点,循环往复直到服务不可用。 - Network Exposure(网络暴露):K8s 默认「所有 Pod 互通」,没有 NetworkPolicy;LLM 动不动就给 NodePort/LoadBalancer;Service selector 匹配不上 label 时零报错、零流量。风险剧本:一个命名空间里被攻陷的 Pod,因为没有网络策略,能直接连到另一个命名空间的数据库。
- Privilege Sprawl(权限蔓延):给工作负载 ServiceAccount 绑了
cluster-admin、rules 里写verbs: ["*"]、用 default SA、从不调 API 的 Pod 还自动挂载 token、secret 用环境变量注入(kubectl describe一眼可见)。 - Fragile Rollouts(脆弱发布):liveness 探针去探数据库导致全 Pod 同时重启、readiness 过早通过导致 502、用
:latest可变 tag、没 preStop 导致在途请求被掐。 - API Drift(API 漂移):生成
extensions/v1beta1的 Ingress(1.22 已删除)、把「deprecated 还能用」和「removed 直接报错」混为一谈——因为训练数据停在 1.18–1.21 时代。
三、七步工作流:诊断先于生成
KubeShark 的全部逻辑写在一个 7 步流水线里,每次 K8s 任务都从头跑一遍:
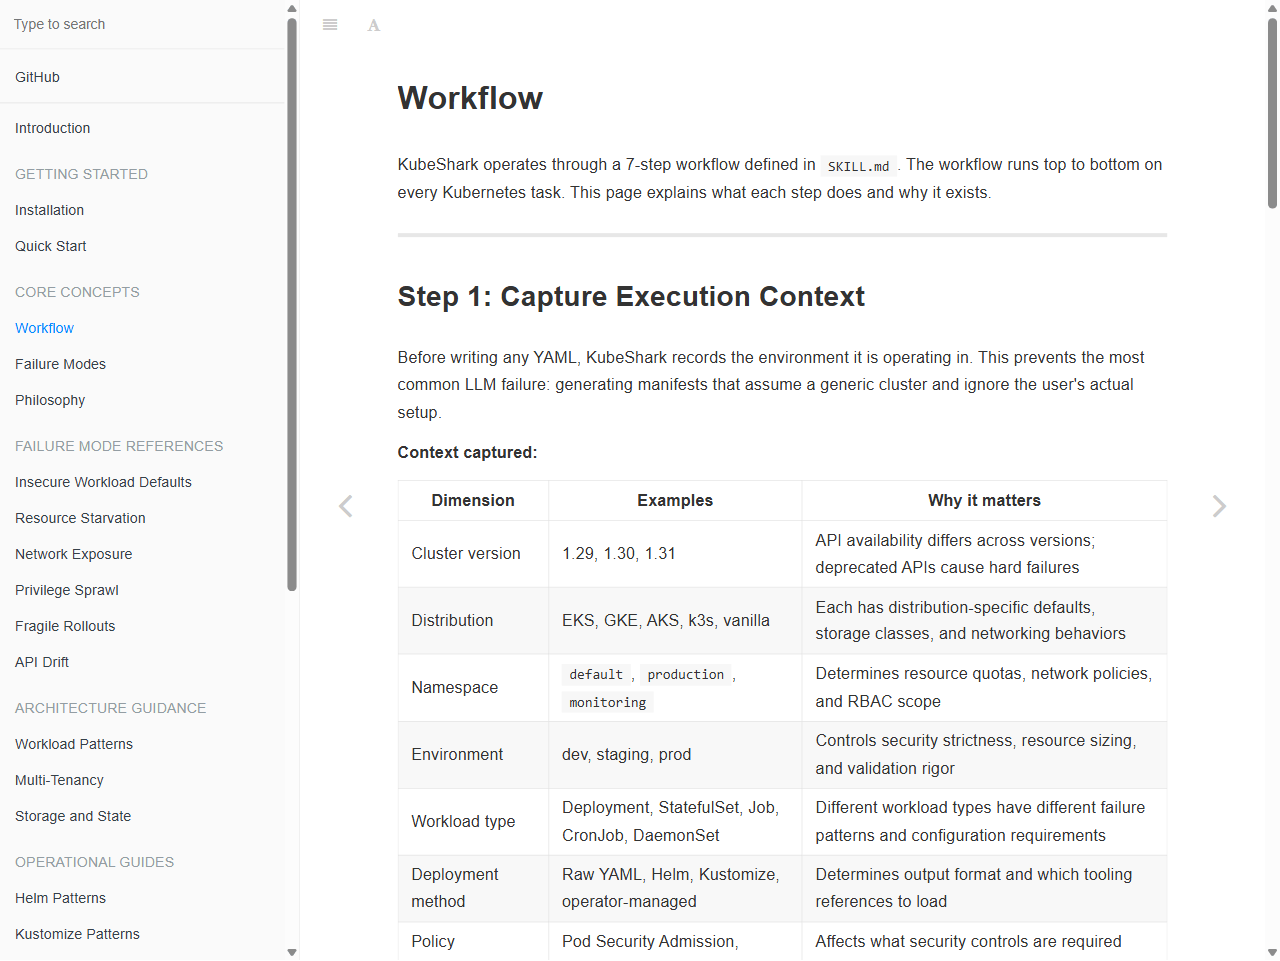
- 采集执行上下文:先问清集群版本(1.29/1.30/1.31)、发行版(EKS/GKE/AKS/k3s)、命名空间、dev/staging/prod、工作负载类型、部署方式(裸 YAML/Helm/Kustomize)、策略引擎。任何一项未知就显式声明假设,而不是默默猜。
- 诊断故障模式:判断本任务触发上面 6 类里的哪几类(一个「建 Deployment + Ingress」通常至少触发不安全默认、网络暴露、脆弱发布三类)。
- 按需加载参考:仓库有 20 份参考文件,但每次只加载 1–2 份——问探针就只加载 fragile-rollouts.md,绝不把全部知识塞进上下文。
- 给出修复路径:每条建议都附三句——为什么能治这个故障、修了还可能出什么事、护栏/验证命令是什么。
- 生成产物:YAML 默认按 Pod Security Standards restricted profile 输出:
runAsNonRoot: true、allowPrivilegeEscalation: false、readOnlyRootFilesystem: true、drop: ["ALL"]、RuntimeDefault seccomp。 - 验证:
kubectl apply --dry-run=server/kubectl diff、kubeconform 按目标集群版本做 schema 校验、跨资源一致性检查(label/selector/port 是否对齐)、策略扫描。 - 输出契约:每次回答结尾固定输出五段——假设与版本下限、选中了哪些故障模式、取舍了什么、验证计划、回滚方式(
kubectl rollout undo等),让整段输出可审计。
四、关键数据与口径
| 维度 | 官方说法 |
|---|---|
| 激活成本 | 约 650 token(每次任务启动时) |
| 参考文件总数 | 20 份,单次按需加载 1–2 份 |
| 命名故障模式 | 6 类 |
| 安装方式 | npx skills add https://github.com/lukasniessen/kubernetes-skill --skill kubernetes-skill,或 git clone 到 ~/.claude/skills/ |
| 默认安全基线 | PSS restricted profile(非 root、只读根文件系统、drop ALL capabilities 等) |
五、评测方法批判:它是「提示词工程」,不是运行时强制
这是最需要冷静读的一节。KubeShark 的全部交付物本质上是 Markdown 形态的方法论与参考文件——它通过约束 LLM 的生成流程来降低幻觉概率,而不是在集群侧强制任何东西。因此:
- 「~650 token 激活成本」「20 份参考」都是作者自报的工程数字,文章里没有给出「用了 KubeShark 前后,LLM 生成清单的真实事故率下降了多少」的对照实验;
- 6 类故障模式是作者经验归纳,不是对真实事故数据库的统计聚类,覆盖面取决于作者本人的见过的坑;
- 它依赖底层模型真的会遵守 7 步流程——换个较弱的模型,完全可能跳过 Step 2 诊断直接写 YAML,skill 的效果随之打折;
- 安全默认值只是「建议输出」:真正拦住 root 容器、拒绝特权的,仍然是集群侧的 Pod Security Admission、Kyverno 或 OPA/Gatekeeper。KubeShark 自己也把这些写进了 Step 6 验证清单,等于承认「我负责提醒, enforcement 交给平台」。
换句话说,它把「专家的 checklist」塞进了 Agent 的上下文,但 checklist 不会自己执行。
六、优势与局限
优势:
- 方法论对路:failure-mode-first 把「先想会怎么坏、再决定怎么写」变成固定流水线,比让模型凭通识默写可靠得多;
- token 经济:650 token 激活 + 按需加载 1–2 份参考,避免了把整本 K8s 最佳实践每次都塞进上下文;
- 输出契约可审计:假设、取舍、回滚都写在结尾,方便人 review,而不是一段裸 YAML。
局限:
- 无强制力:它是 prompt/skill,不是 policy engine;别指望它替代 PSS/Kyverno;
- 效果依赖底座模型:弱模型可能跳过诊断步骤;
- 缺少量化背书:没有前后对比的事故率数据,「防幻觉」目前更多是设计哲学而非实测结论;
- 生态较新:覆盖面(Helm/Kustomize/多租户/可观测)在快速扩充,但成熟度需时间检验。
七、谁该关注
- 已经在用 Claude Code / Codex 写 K8s 清单、又踩过「selector 对不上没报错」这类坑的平台工程师:把这份 skill 装上,相当于给 Agent 配了个资深 SRE 的 checklist;
- 想给团队 LLM 编码流程加一道「写前审查」的人:它的「输出契约 + 验证命令」结构可以直接借鉴;
- 但如果你的集群没有 Pod Security Admission 或策略引擎兜底,请先把平台侧的强制力建起来——skill 再细,也只是「提醒」,不是「护栏」。