Kiro:AWS 的 spec-driven AI 编程工具,把"先写规格再让 Agent 写码"做成默认流程
阅读时间: 大约 10 分钟
Kiro:AWS 的 spec-driven AI 编程工具,把”先写规格再让 Agent 写码”做成默认流程
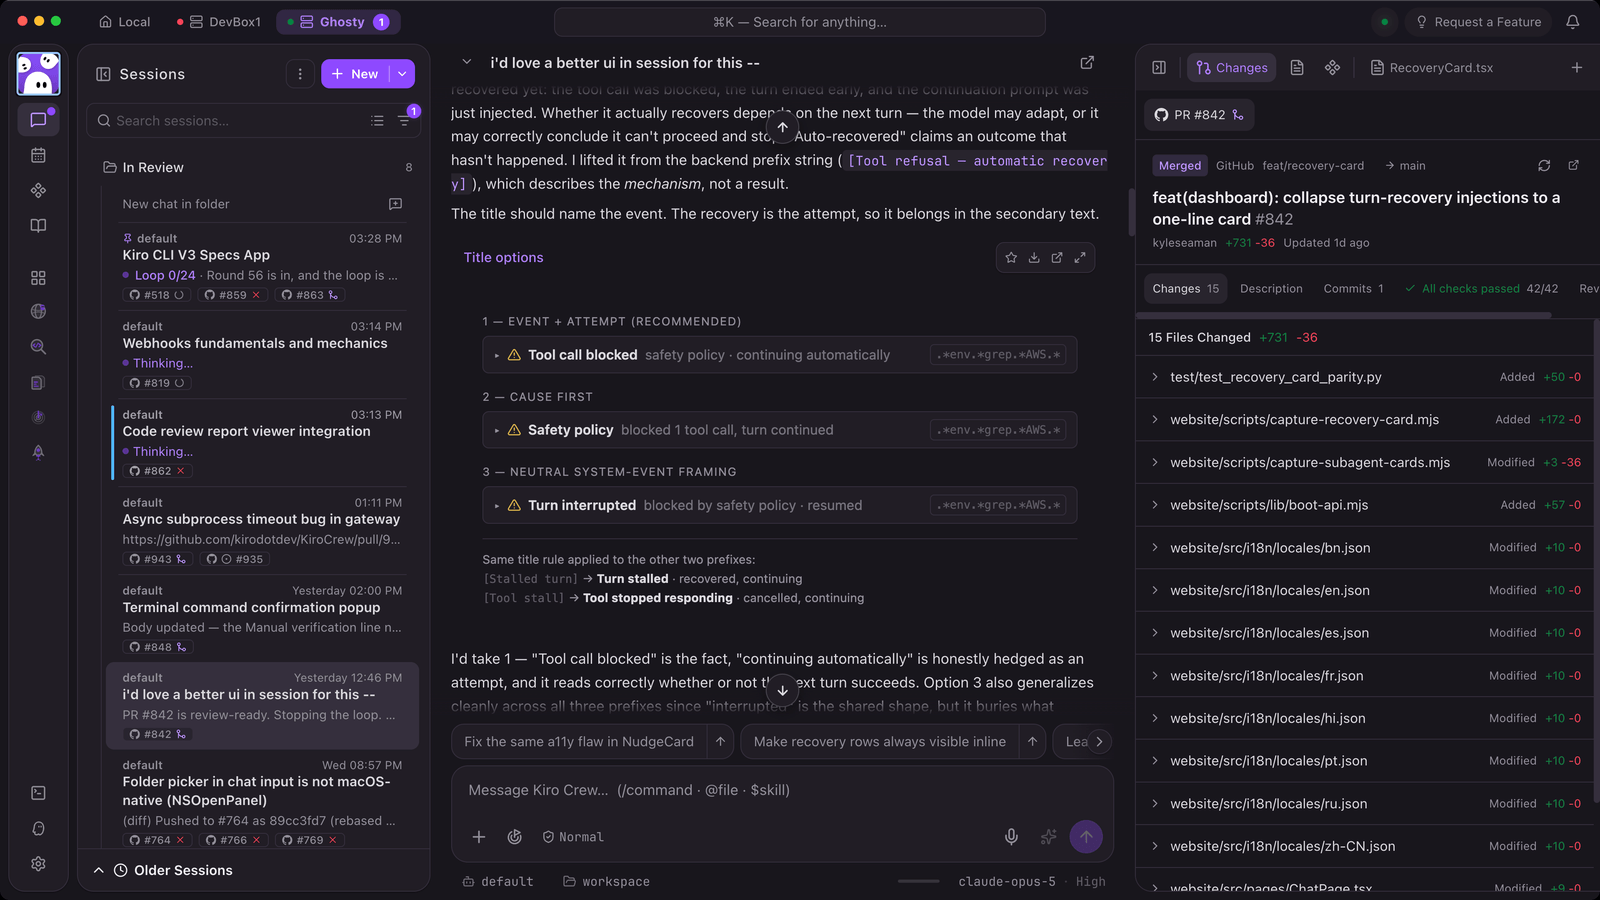
Kiro 是 AWS 推出的 AI 编程产品(官网 kiro.dev),定位从”AI coding”进一步抬到”agentic engineering”:不是给一个补全框,而是把 prompt 转成可执行的规格(spec),由并行 Agent 实现,再用属性测试校验代码正确性。科技周报首次介绍它时,它还是 Preview 排队阶段;如今已形成 IDE、CLI、Web、移动端与开源工作区 Kiro Crew 五个入口。本文基于 kiro.dev 官网与官方 FAQ 做一手分析,区分官方宣称与可核实事实。
一、背景:vibe coding 的短板催生 spec-driven
官网 FAQ 直接对比了两种模式。Vibe coding(凭感觉写码)在复杂任务与大型代码库上的问题,官方归纳为三点:需要过多手把手引导、容易误解上下文、过程中做过的决策难以记录并同步给团队。Kiro 的解法是 spec-driven development:先定义需求(requirements)、系统设计(design)、待实现任务(tasks),再动代码,把推理与实现决策显式写成文档,从而”用更少的轮次完成更复杂的任务”。这与传统瀑布式文档不同——规格由 Agent 与用户共同快速生成,而不是提前写完一本厚手册。
二、核心机制:三段规格 + 属性测试
官网描述的工作流分为三层:
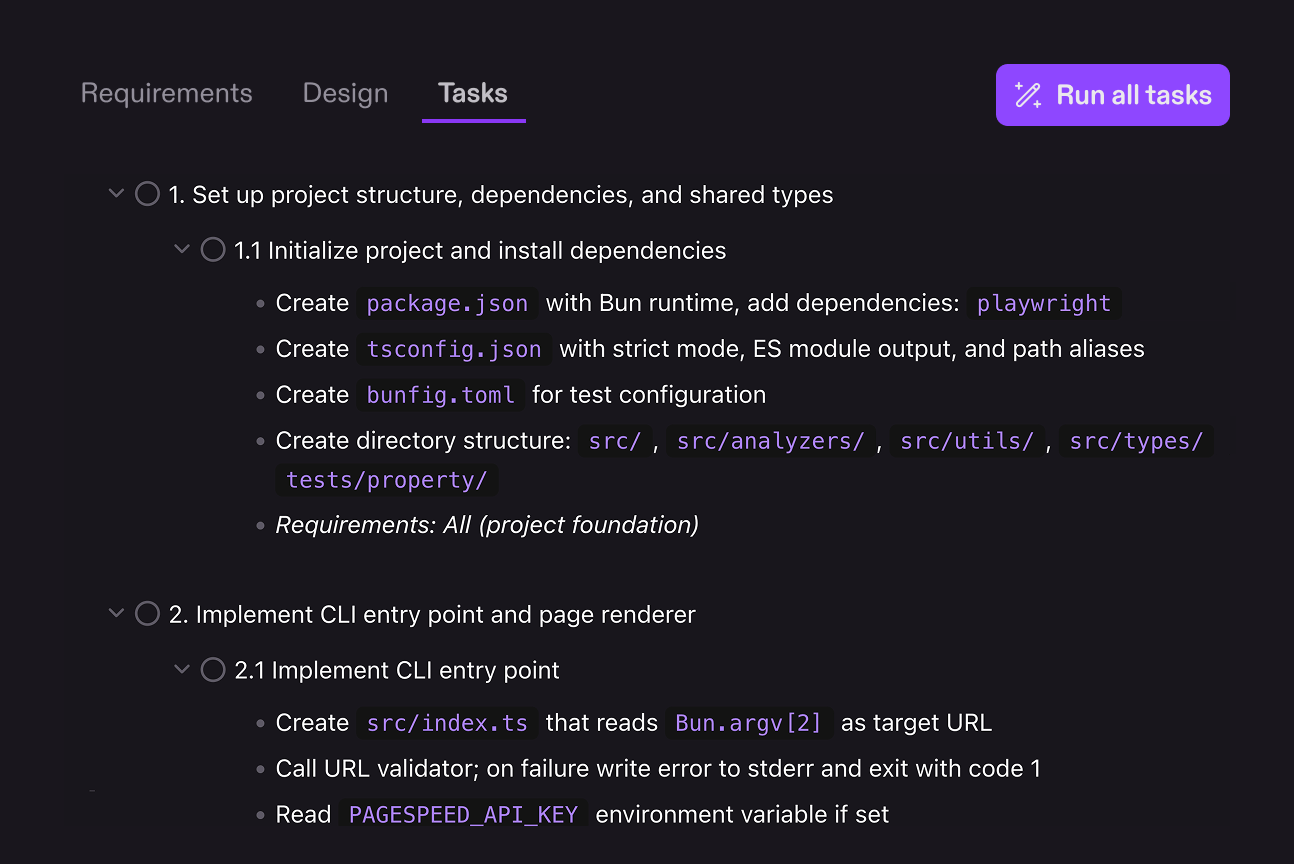
- Requirements(需求):Agent 先把自然语言 prompt 整理成需求条目;
- Design(架构设计):产出系统设计方案;
- Tasks(顺序化任务):拆成可执行的层级清单,支持 “Run all tasks” 批量下发给并行 Agent。
写代码之前,Kiro 先用自动化推理检查需求里的矛盾与缺口(contradictions and gaps);实现阶段由并行 Agent 在本地或云端大代码库上工作。质量侧的特色是属性测试(property-based tests,类似 fuzz testing):不像单元测试只校验几个样例输入,而是断言”对所有输入都必须成立的规则”,从而抓住”单元测试通过、生产却崩”的边界情况。
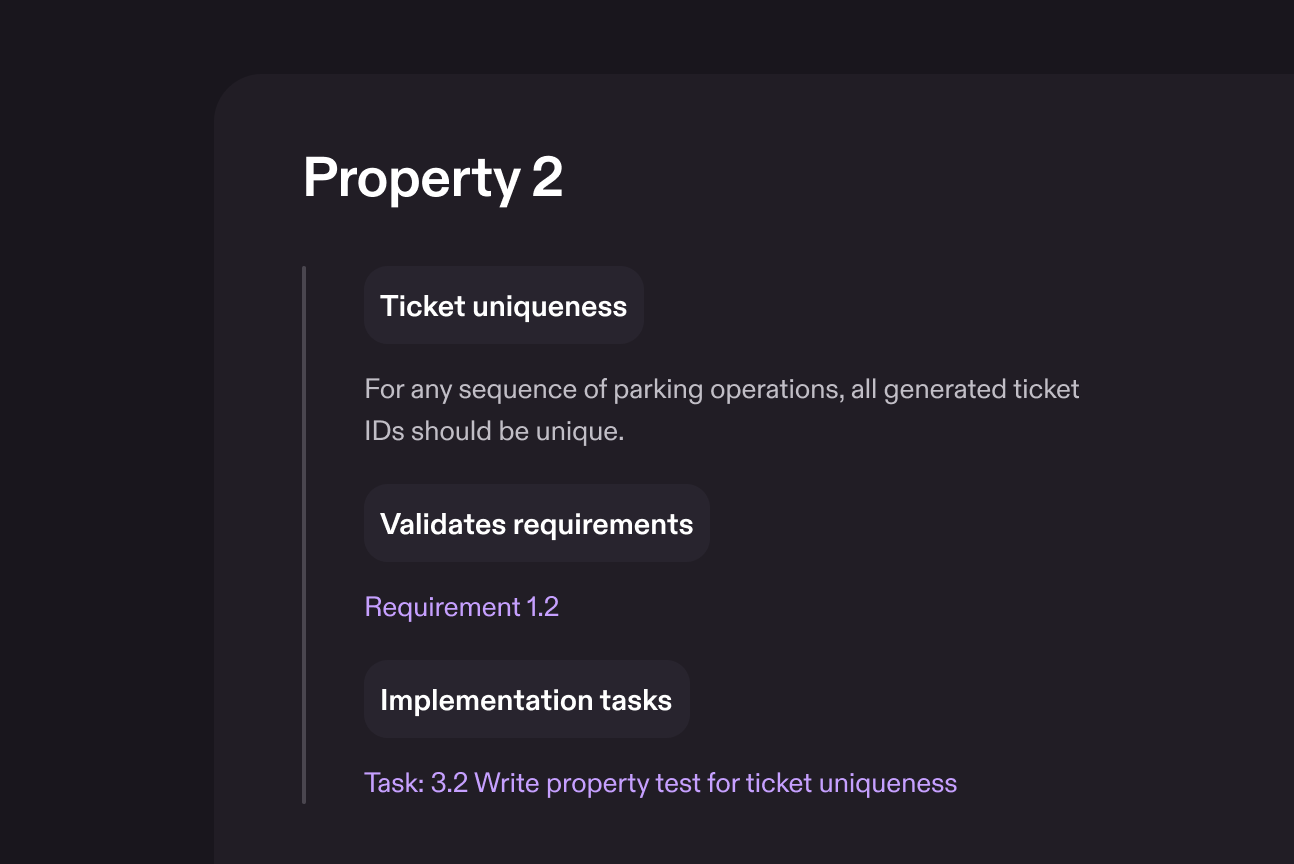
这张官方截图展示了规格的可追溯性:一条属性(“任意停车操作序列下,生成的票号 ID 都应唯一”)向上绑定 Requirement 1.2,向下绑定 Task 3.2”为票号唯一性写属性测试”,形成需求—属性—任务的闭环。
三、产品形态与开放标准
- 五个入口:Kiro IDE(本地实时协作)、Kiro CLI(终端工作流、自定义 Agent、部署流水线,可 headless 跑进 CI/CD 评审 PR、修 bug)、Kiro Web(浏览器委派,云端隔离沙箱会话,合上笔记本继续跑,对接 GitHub/GitLab)、移动端、Kiro Crew(本机持久化开源工作区,跨会话保留);
- 开源标准兼容:Agent 兼容 Agent Client Protocol(ACP),支持
AGENTS.md、Skills.md、MCP;IDE 基于 Code OSS,可导入 VS Code 设置、主题与 Open VSX 扩展;CLI 适配 bash/zsh/fish 与 500+ 常见 CLI; - 语言覆盖(官网列举):Python、Java、JavaScript、TypeScript、C#、Go、Rust、PHP、Ruby、Kotlin、C、C++、shell、SQL、Scala、JSON、YAML、HCL。
四、模型与计价:信用点 + Auto 路由,倍率相对值
Kiro 不绑定单一模型,模型菜单列出多档可选,Auto 按复杂度综合模型质量、时延与成本自动选模型,信用成本以 Auto=1.0x 为基准(官网数值,相对倍率,非绝对美元价):
| 模型档位(官网菜单) | 相对 Auto 的信用倍率 | 官方定位 |
|---|---|---|
| qwen3-coder-next | 0.05x | 预算友好的长编码会话、错误恢复强 |
| minimax-m2.1 | 0.15x | 上一代 MiniMax |
| deepseek-3.2 / minimax-m2.5 | 0.25x | 开源权重 / 低成本前沿编码 |
| claude-haiku-4.5 | 0.4x | 快速迭代与子 Agent |
| glm-5 | 0.5x | 大型代码库仓库级 Agent |
| gpt-5.6-luna | 0.6x | 高频快速任务 |
| claude-sonnet-5.5 / 5 / 4.6 / 4.5 / 4 | 1.3x | 近 Opus 的 Agent 编码 |
| gpt-5.6-terra / claude-opus-5.5 / opus-5 / 4.8/4.7/4.6 | 2.0–2.2x | 高可靠多文件多 Agent |
| kimi-k3 | 2.4x | 长时编码与知识工作,1M 上下文 |
| gpt-5.6-sol | 4.4x | 最难多步任务,1M 上下文 |
| claude-fable-5.1 | 6.0x | 企业预览,1M 上下文,仅 US East |
计价为信用点制(credit-based),官网称无每日/每周速率限制、超额预付,避免突发账单。企业侧由 AWS 构建运营,提供 IAM/SSO、用量看板、成本管控、带模型排除的 IP 赔偿、治理与管理控制;但使用 Kiro 不需要 AWS 账号,可用 GitHub、Google、AWS Builder ID 或 IAM Identity Center 登录。
五、口径批判:官网没有公开独立基准
读官网材料要注意四条偏差:
- 倍率是相对值:4.4x、6.0x 是相对 Auto 的倍数,绝对每信用点多少钱未在首页披露,成本核算需进入定价页实测;
- 模型池动态变化:菜单自身标注 claude-opus-4 已于 2026-10-14 EOL,可选清单会持续增删,表内快照不代表长期状态;
- 属性测试由 Agent 生成:property 本身可能写错(把错误规则写成”必须成立”),PBT 替代不了人工评审与回归套件;
- 首页证言与”learn from every session”是营销口径:官网未公布独立第三方编码基准分数,证言来自用户推荐位,“跨会话学习”的具体机制未公开。
六、客观分析:优势与局限
优势:
- 规格先行对抗上下文遗失:需求—设计—任务显式留痕,复杂任务决策可追溯、可交给团队;
- 属性测试补单元测试盲区:全输入规则断言比样例测试更能暴露边界 bug;
- 多形态 + 开放标准:IDE/CLI/Web/ Crew 同源,ACP/MCP/AGENTS.md 降低锁定,可嵌入 CI/CD;
- 企业合规现成:AWS 运营、IAM/SSO、IP 赔偿对中大型团队友好。
局限:
- 规格有开销:改个文案、修个 typo 也要走三段规格,小任务性价比低;写好 spec 本身就是技能;
- 规范流程牺牲即兴探索:Koala 点评同样指出,人类编程并不总从 spec 开始,过于严格的流程会压缩试错空间;
- 无公开基准:与 Claude Code、Cursor 等的胜负需要团队用自有仓库实测;
- 企业预览模型地域受限(如 claude-fable-5.1 仅 US East),非美国团队不可用。
七、谁该关注
- 中大型代码库的团队:规格留痕 + 并行 Agent + 仓库级模型,适合多人协作与合规场景;
- 需要 CI/CD 自动化评审:headless CLI 跑 PR 检查是明确卖点;
- 强依赖企业合规(SSO/IP 赔偿)的组织:AWS 运营背景直接可用;
- 个人快速原型:小任务建议先用轻量 vibe 模式,不必为每个改动起 spec。