Kimi K3:月之暗面 2.8 万亿参数开源旗舰的架构与账本
阅读时间: 大约 11 分钟
Kimi K3:月之暗面 2.8 万亿参数开源旗舰的架构与账本
2026 年 7 月,月之暗面(Moonshot AI)发布 Kimi K3——一个 2.8 万亿(2.8T)参数的 MoE 模型,官方称之为”全球首个开源 3T 级模型”。它原生支持视觉输入、上下文窗口 100 万 token,发布当天即在 Kimi.com、Kimi Work、Kimi Code 与 Kimi API 上线,完整权重承诺于 2026 年 7 月 27 日前放出。本文不堆砌营销话术,而是回到官方技术博客本身,把它的架构主张、可核对数字、以及官方自己写明的口径偏差摊开来看。
一、背景:开源阵营第一次摸到 3T
过去大模型的参数规模上限长期被闭源旗舰占据。月之暗面在官方博客中称,“过去 12 个月中有 9 个月,Kimi 模型都在刷新开源模型的规模上限”。K3 把这条线从千亿、两千亿直接推到 2.8T,是开源权重模型第一次进入”3T 俱乐部”。
但规模不是卖点本身。官方开篇就把话说得很直白:K3 整体仍落后于最强的闭源模型 Claude Fable 5 与 GPT 5.6 Sol,只是在其评测套件内”稳定优于其他受测模型”。这种把短板写在第一段的姿态,在国产大模型发布稿里并不常见,也为后文理解那些漂亮的柱状图提供了必要的冷背景。
二、技术机制:KDA + AttnRes + Stable LatentMoE
K3 的架构由三块新东西组成:
- Kimi Delta Attention(KDA):一种改进的注意力机制,旨在提升跨序列长度的信息流动效率,也是支撑 100 万上下文下推理成本可控的关键;
- Attention Residuals(AttnRes):不在每层均匀累加表示,而是跨网络深度有选择地”取回”历史表示;
- Stable LatentMoE:把 MoE 稀疏度大幅拉大——896 个专家每次只激活 16 个。
官方称这套结构配合改进的训练与数据配方,相比 K2 实现了约 2.5 倍的整体缩放效率(scaling efficiency),即每单位算力转化出的智能更高。在 896 选 16 的极端稀疏下,路由本身成了一阶难题:官方给出 Quantile Balancing(直接用 router 分数分位数分配专家,去掉了敏感的平衡超参)、Per-Head Muon(按注意力头独立优化 Muon 优化器)、SiTU 激活与 Gated MLA 等配套手段。
工程上两个细节值得记住:其一,从 SFT 阶段起就做量化感知训练,权重用 MXFP4、激活用 MXFP8,以扩大硬件兼容面;其二,官方明确建议把 K3 部署在 64 卡及以上的超节点上,因为更大的高带宽通信域才有利推理效率,且 KDA 对传统 prefix caching 不友好,月之暗面已向 vLLM 社区贡献了对应的 KDA prefill cache 实现。
三、关键数据:基准与定价
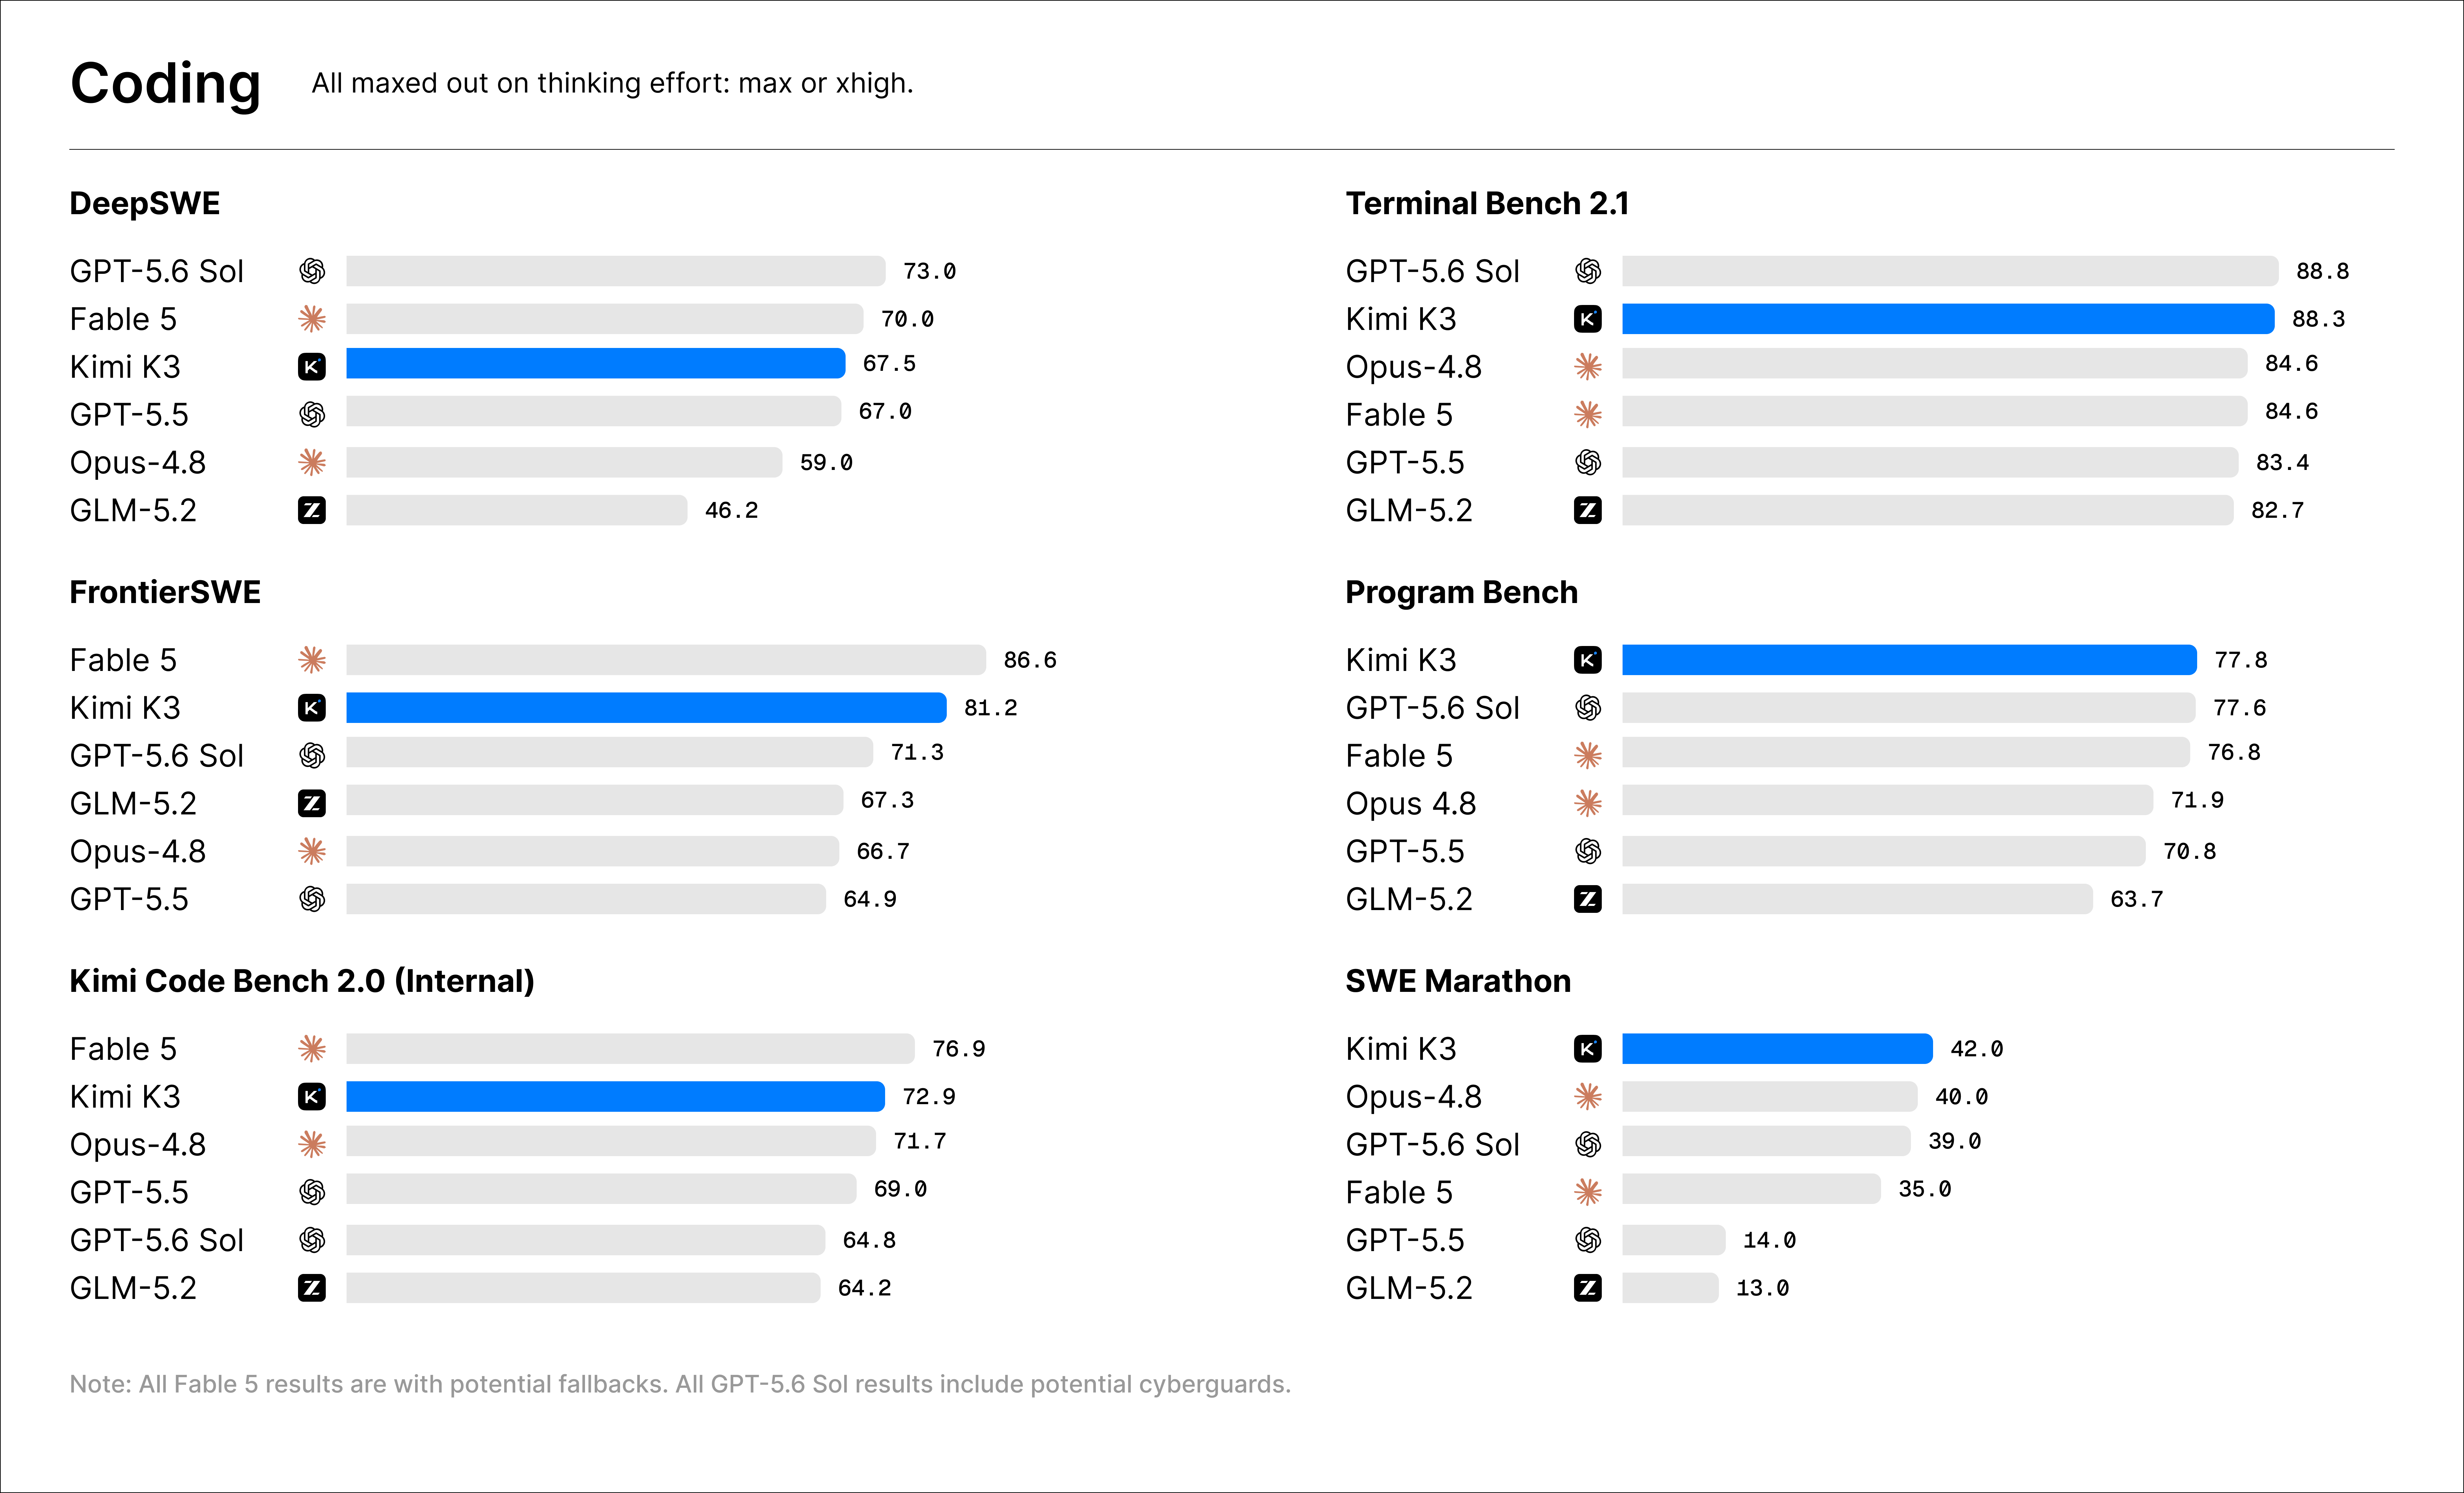
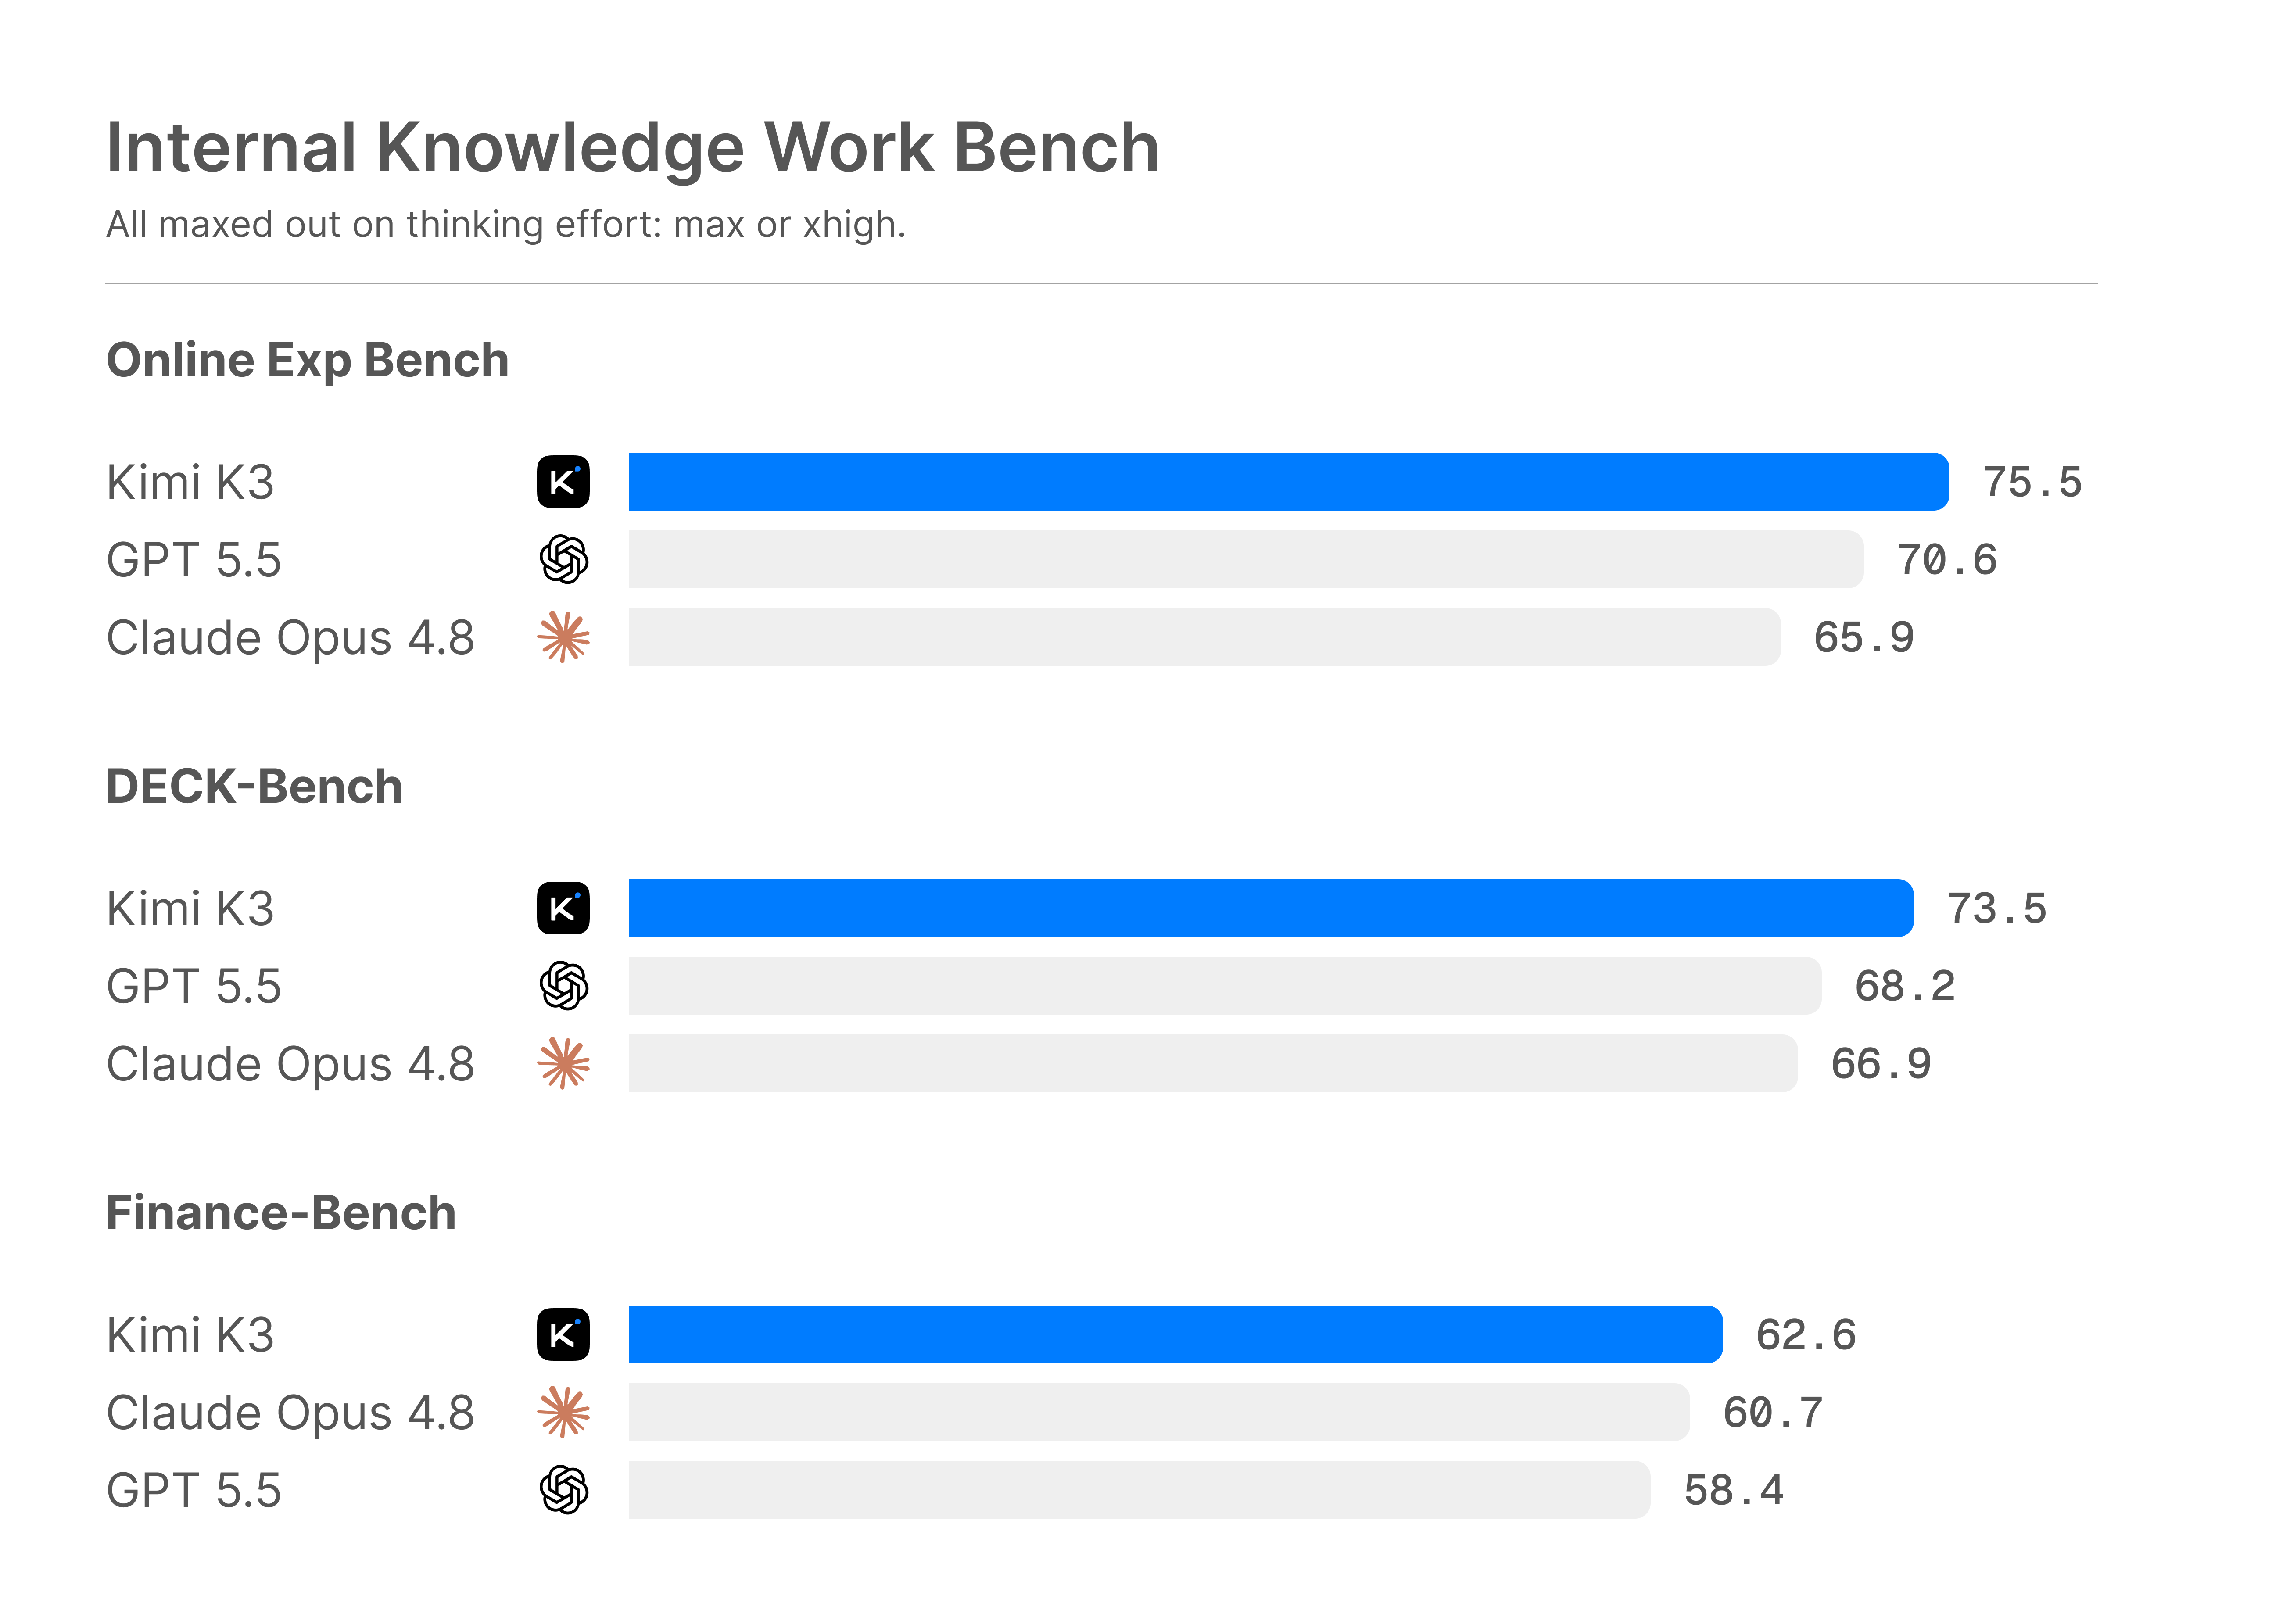
官方公布的基准全部设定在”max / xhigh 思考强度”、temperature=1.0、top-p=1.0。摘取若干有代表性的数字(柱状图读数):
| 基准 | Kimi K3 | 最强对手(分值) | K3 位置 |
|---|---|---|---|
| DeepSWE | 67.5 | GPT-5.6 Sol 73.0 / Fable 5 70.0 | 第三 |
| Terminal Bench 2.1 | 88.3 | GPT-5.6 Sol 88.8 | 第二 |
| FrontierSWE | 81.2 | Fable 5 86.6 | 第二 |
| Program Bench | 77.8 | GPT-5.6 Sol 77.6 | 第一(微弱) |
| SWE Marathon | 42.0 | Opus-4.8 40.0 | 第一 |
| GDPval-AA v2 (Elo) | 1668 | Fable 5 1760 / GPT-5.6 Sol 1748 | 第三 |
| BrowseComp | 91.2 | GPT-5.6 Sol 90.4 | 第一 |
可以看到 K3 的典型画像:在长程工程任务(SWE Marathon、Terminal Bench、Program Bench)上摸到第一或第二梯队,但在 GDPval 这类综合智能 Elo 上仍明显落后于 Fable 5 与 GPT-5.6 Sol——这与官方”整体仍逊于两家闭源旗舰”的自述一致。
API 定价(kimi-k3 模型名):缓存命中输入 $0.30/百万 token、缓存未命中输入 $3.00/M、输出 $15.00/M。官方称在编码工作负载下缓存命中率超过 90%,靠的是 Moonshot 的分离式推理架构。作为参照,这个输出价与 DeepSeek V4.1-Flash 高峰价($1.2/M)相比贵了一个数量级——K3 走的是”旗舰能力”而非”地板价”路线。
四、评测方法的口径偏差(必须读)
这一节是本文认为最有价值的部分,全部来自官方脚注:
- Harness 不统一:每个模型在不同 agent 框架下跑分——K3 用 Kimi Code、Claude 系用 Claude Code/Terminus、GPT 系用 Codex。官方自己承认”按各家最佳 harness 取分”,跨模型严格可比性因此打了折扣。
- Fable 5 含 fallback:Fable 5 由第三方评测,结果可能包含回退行为;在 SWE Marathon 上 35% 的任务触发了 fallback,官方提示这可能拉低了 Fable 5 的实测成绩。
- GPT-5.6 Sol 触发网络护栏:在 Kimi 自家的 KCB 2.0 基准上,10% 的任务触发了 GPT-5.6 Sol 的 cyber guard;图注也统一标注”All GPT-5.6 Sol results include potential cyberguards”。这意味着 GPT 系部分分数是在”被拒答/被拦截”约束下取得的。
- 硬件换了:PostTrain Bench 官方设定是 H100,K3/Fable 5/GPT-5.6 Sol 这三只是在 H20 上跑的;SWE Marathon 也用了 H20 校准过的任务分支(Docker 镜像与性能门限重标,正确性校验器不变)。
- BrowseComp 的 90.4 有前提:那是 1M 上下文、不做上下文管理时的分数;其余对比分采用了 300K token 触发的上下文压缩策略,口径并不完全一致。
换句话说,柱状图上 K3 的”领先”大多是微弱领先且建立在不同 harness 上,而”落后”的 Elo 类分数反而更接近真实差距。
五、官方自陈的局限
官方在 Limitations 一节写明三条,值得原样保留:
- 对思考历史敏感:K3 用”保留思考历史”模式训练。如果 agent harness 没有按要求回传完整历史思考内容,或在与其他模型同一会话中途切到 K3,生成质量可能变得高度不稳定。官方建议用经过兼容性验证的 harness(如 Kimi Code),并避免会话中途切换模型。
- 过度主动(excessive proactiveness):训练偏重长程难题,导致遇到小问题或模糊意图时,K3 可能替用户做出意外决定。若应用要求 agent 严守边界,必须在 system prompt 或 AGENTS.md 里加更显式的行为约束。
- 体验差距:官方原话——尽管综合竞争力很强,K3 在用户体验上仍与 Claude Fable 5、GPT 5.6 Sol 存在可感知的差距。
六、适用与不适用
适合:需要在本地/私有化环境跑 3T 级能力、长程编码与长上下文(1M)任务、愿意为顶级 agent 能力付费的团队;关注开源权重、可微调的研究机构。
不适合:要求 token 成本极致压到地板价的批量场景($15/M 输出并不便宜);在生产 agent 中频繁切换模型或混用 harness 的场景(受思考历史敏感所限);把 UX 丝滑度放在第一位、且不差钱的团队(闭源旗舰仍是更稳选择)。
七、它意味着什么
Kimi K3 的意义不在于某一个分数,而在于开源权重第一次站上 2.8T 规模,并且用 KDA 这类线性注意力变体去正面解决”长上下文推理成本”这个工程瓶颈。896 选 16 的极端稀疏 + MXFP4 量化感知训练 + 官方主动公开 fallback/护栏/换硬件等口径,说明月之暗面对”可复现、可部署”的重视。它没有宣称超越闭源旗舰,反而把差距写在明处——这种克制本身,比那些”全面超越 GPT”的发布稿更值得信任。