Kern:一个无守护进程、毫秒级启动的 rootless 容器沙箱
阅读时间: 大约 12 分钟
Kern:一个无守护进程、毫秒级启动的 rootless 容器沙箱
当大模型开始自动写代码、自动执行代码时,一个老问题被重新放大:你愿意把模型刚生成、你自己还没读过的脚本,直接 python3 在本机跑掉吗?rm -rf ~ 如果是幻觉出来的,后果是真实的。传统答案是 Docker,但 Docker 是一个常驻后台、需要守护进程、单次启动要数百毫秒的”引擎”——为每次工具调用都起一个容器,开销大到不划算。2026 年出现的 Kern 正是冲着这个缺口来的:它把容器运行时做成一个没有后台进程、永远 rootless、单次启动只要几毫秒的单文件二进制。本文基于 Kern 官方主页与公开的 BENCHMARKS.md,对其设计、性能与边界做一次严谨梳理。
一、出发点:给”没读过的代码”一个一次性容器
Kern 自我定位为”a fast, rootless container runtime and sandbox”。它的核心主张可以用三组数字概括:OCI 镜像、无 daemon、无 root;一个静态文件、无守护进程;两次运行之间 0 个进程在跑。
它瞄准的场景非常具体:
- Agent 的每次工具调用:模型写一段代码,Kern 让它在一个独立容器里跑,调用结束即销毁。官方称”一百次调用总共耗时 1.4 秒,且不留任何痕迹”;
- 用户/第三方提交的不可信代码:一个
--security-profile untrusted开关,一次性把 user、PID、mount、network、UTS、IPC 命名空间、pivot_root、默认拒绝的 seccomp 白名单、能力丢弃和 cgroup v2 限制全部配齐; - CI 与构建步骤:runner 上无需预先安装、无需启动任何后台服务,跑完即走;
- 本地开发栈:直接吃你现有的
docker-compose.yml,不需要 Docker Desktop。
二、它是怎么做到”几毫秒”的
没有 daemon,意味着没有东西需要”去问”、也没有东西需要”去等”。所有工作都在你启动的那个进程里、按固定顺序完成。官方在”how a box is built”一节给出了这个固定流水线:
- 先建命名空间:user、PID、mount、network、UTS、IPC 一次性 unshare。你的宿主机 uid 在盒子内映射为 root,且仅在盒子内,不在宿主机获得任何权限;
- pivot_root 进入新根:镜像以 overlay 组装或以只读方式挂载,再
pivot_root进入。官方称这段顺序在源码里被做成了”类型态(typestate)“——一个还没把根重新挂成只读就 pivot 的代码根本编译不过,让”挂载了可写根”这类 bug 在类型层面不可能存在; - 丢弃危险能力:exec 之前丢掉 16 个危险 capability,
untrusted配置文件则全部丢弃并把根挂成只读; - 默认开启 seccomp:用的是白名单而非黑名单——在 moby 默认集基础上,去掉 35 个被视为逃逸向量的系统调用并硬杀;白名单之外的系统调用返回
ENOSYS而不是直接 kill,这样普通镜像仍能在它下面正常工作; - cgroup v2 限制:内存、CPU、pid 写入盒子自己的 cgroup,
--require-limits若发现限制绑不上则干脆拒绝启动,而不是”假装生效”。
最后才是 exec。留下来的只有一个短命进程,kern ps 直接从内核读状态,而不是从一个可能与现实不一致的数据库里读。
三、性能数据:官方到底测了什么
Kern 官方 BENCHMARKS.md 的透明度值得称道——它不仅给数字,还反复强调”这是当天最好成绩”。以下数据均来自官方(测试机:Intel i7-14700KF,Linux 7.0.0):
| 运行时 | 单容器启动 | 200 个并行启动 | 说明 |
|---|---|---|---|
kern box --rootfs | 2.7 ms | 0.10 s | 命名空间+overlay+pivot_root+seccomp+内存/PID 上限 |
kern box --image | 3.6 ms(当天最优;中位数 4.05 ms) | 0.12 s | 同上,外加把 OCI 镜像解包进 overlay |
| bubblewrap | 2.7 ms | 0.15 s | 命名空间+bind mount,无 seccomp、无 cgroup 上限 |
| runc(rootless) | 13.2 ms | 0.32 s | OCI 运行时,通常由上层引擎驱动 |
podman run --rm | 288 ms | 43.6 s | 每次都 fork conmon 与整套 OCI 栈 |
docker run --rm | 294 ms | 16.6 s | client→daemon→containerd→runc 全程 |
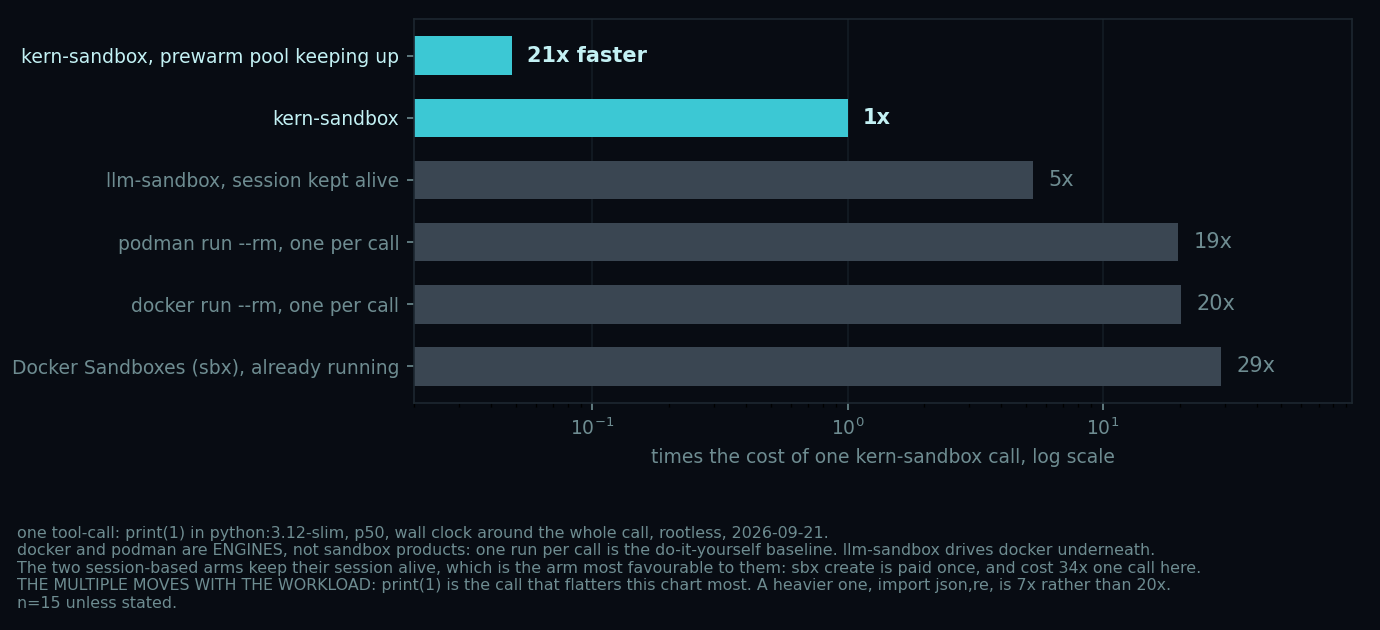
由此官方给出的对比结论是:单容器比 docker run --rm 快约 80 倍,200 个并行时快约 130 倍,比 rootless runc 快约 3.6 倍。并行差距反而拉大,官方的解释是:daemon 会把无 daemon 运行时本可以并行做的事串行化。
但官方也主动泼了冷水,这些口径必须一起看:
- 3.6 ms 是当天最好成绩:同批 34 次复现里中位数是 4.05 ms,最慢 4.31 ms,随机器负载在 3.65–4.31 之间波动。在一台”正在工作的机器”上,你更可能看到约 4 ms,而不是 3.6;
print(1)是最讨好这张图的负载:换成真正干活的import json,re,通过 kern-sandbox 要 45.4 ms,通过docker run --rm要 329.7 ms,差距收窄到约 7.3 倍而非 20 倍——因为剩下的耗时主要是 CPython 解释器自己启动,而不是盒子本身;- 一百次调用的真实成本:顺序跑 100 次
run_code(python:3.12-slim)墙钟 1.36 s,每次 13.6 ms,跑完后状态目录字节级不变、kern ps列出 0 个盒子;若按 docker 的 294 ms 算,同样一百次要约 29 秒。
四、客观优势与局限
优势:
- 启动成本低到可以”每次调用一个容器”:当单次隔离只要十几毫秒、且跑完什么都不留,“一步一个容器”就从奢侈品变成了默认选项,这对 Agent 循环里的故障隔离意义重大;
- 始终 rootless,而非可选:不像 Docker 的 rootless 模式是 opt-in,Kern 默认就是——你的 uid 在盒内是 root、在盒外什么都不是;
- 吃 Docker 生态格式:OCI 镜像、Dockerfile、docker-compose.yml 直接可用,没有转换步骤,也不需要 Docker Desktop;
- 安全边界写得很诚实:官方专门有 “What kern is not” 与 SECURITY.md/Pentest 章节,把每一处”协作式边界”及其绕过方式都列了出来。
局限与官方口径:
- 它不是 hypervisor:边界是 Linux 内核本身,因此一个内核提权漏洞对它就是逃逸。官方明说”不要把它用来给陌生多租户跑恶意代码”,那种场景该上 Firecracker 这类 microVM 或 gVisor;
- 逃不开 user namespace 的先天问题:它的隔离建立在非特权 user namespace 上,而这恰是内核 LPE(本地提权)bug 的高发区;
- bind mount 不是边界:你挂进来的目录是你的信任决策,Kern 不替你强制隔离;
--net host、--privileged需显式开启; - GPU 只能整块给:Kern 不做 GPU 切分,也不能按盒子限流;
- 不是 Docker Engine 替代品、也不是 K8s 运行时:它说 Docker 的格式但不说 Docker 的 API——没有 overlay 网络、没有插件、没有 Swarm、没有 CRI;compose 起来的栈是一个共享网络命名空间的 pod,两个服务不能同时监听同一容器端口;
- 无原生 macOS 版:macOS 没有命名空间和 cgroup,Kern 在 Mac 上只能跑在 Linux VM(colima/Lima/OrbStack)里,官方称”不会有原生移植”。
五、适合谁用
- 写 Agent 编码工具的团队:可以直接
pip install kern-sandbox拿到一个本地代码解释器,或通过自带的kern-mcp给 Claude Desktop、Claude Code、Cursor 挂上一个”不依赖云账号”的本地容器; - 想给 LLM 生成代码加一道便宜隔离墙的人:把
run_code()当作”你即将在终端里跑的脚本”的默认入口,幻觉出的rm -rf ~只会作用在只读的容器/root里; - CI/构建与本地开发:runner 上零安装、跑完零残留,现有 compose 文件直接搬。
反过来,如果你要的是多租户、面向陌生用户的高密恶意代码执行环境,或者需要 overlay 网络、K8s CRI、Swarm 这类生产编排,Kern 官方自己建议你回去用 Docker、containerd、CRI-O 或 Firecracker。