Karpathy 的 AutoResearch:让 AI Agent 在单卡上通宵做 LLM 训练实验
阅读时间: 大约 11 分钟
Karpathy 的 AutoResearch:让 AI Agent 在单卡上通宵做 LLM 训练实验
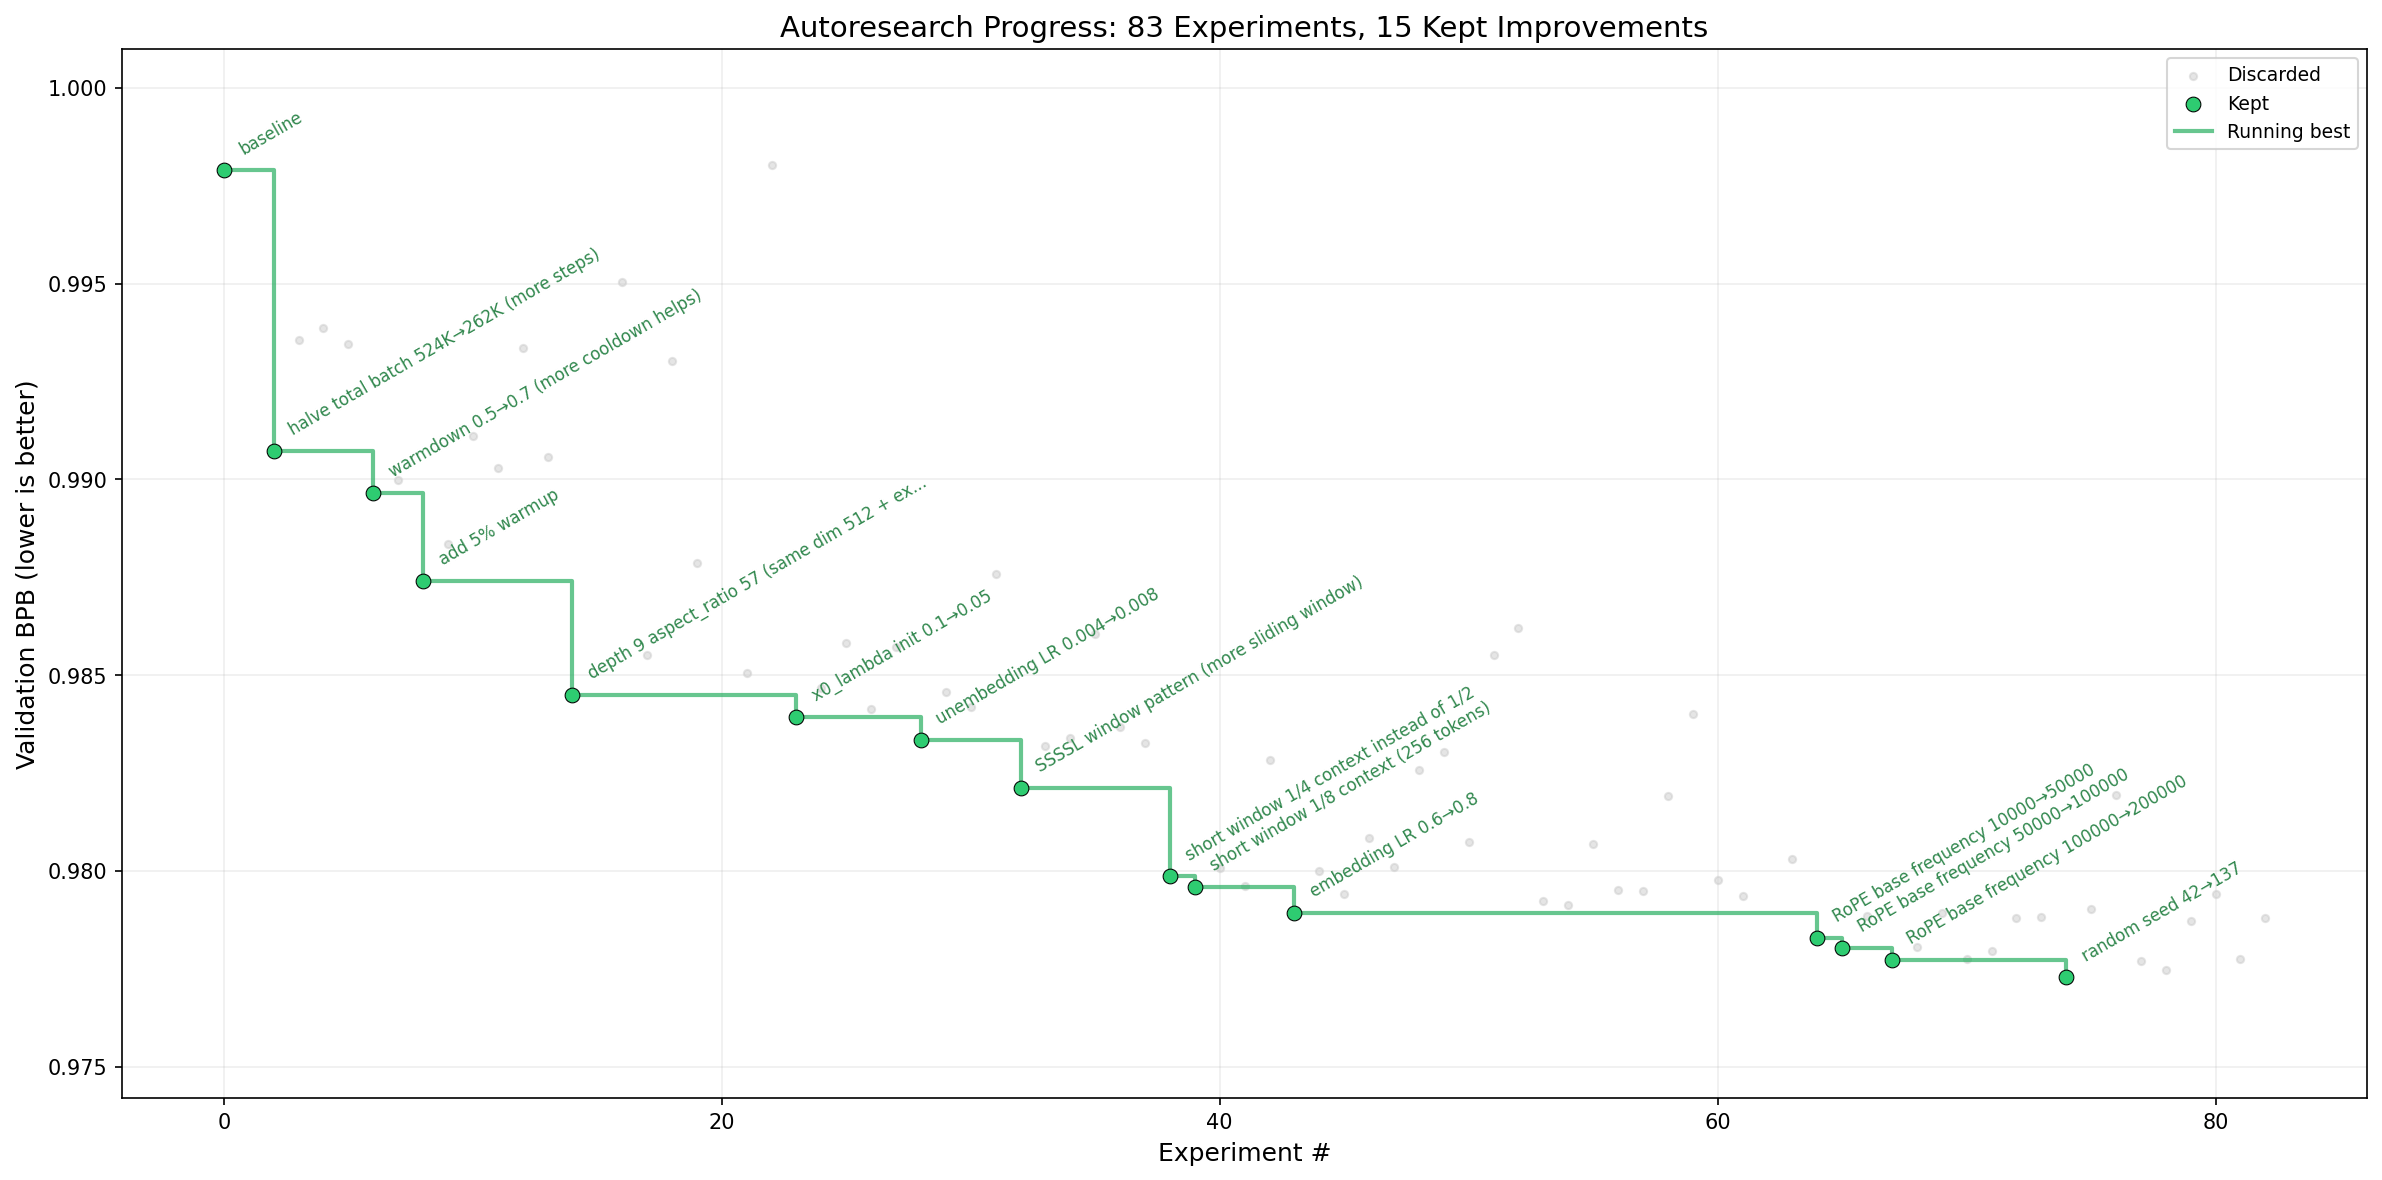
2026 年 3 月,Andrej Karpathy 在 GitHub 开源了 autoresearch。项目的开场引言带着他一贯的调侃:「 frontier AI 研究曾经由肉 computers 在吃饭睡觉开组会之间完成,那个时代早已过去……这个 repo 就是这一切如何开始的故事。」抛开玩笑,它的工程内核非常具体:给 AI agent 一套小而真实的单 GPU LLM 训练环境,让它通宵自主实验——自己改代码、训练 5 分钟、检查结果是否变好、保留或丢弃、循环往复。你早上醒来,面前是一份实验日志和(希望是)一个更好的模型。本文基于仓库 README 与官方 progress 图做一手拆解。
一、动机:把「研究」变成 agent 可循环执行的回路
传统超参/架构研究的循环是:人读论文→改代码→提交训练→等结果→分析→再改。瓶颈在于人的时间与判断力,而不是 GPU。autoresearch 把这个回路整体交给 agent,人只负责写一份「组织研究」的指令文件。
它的训练代码是 nanochat的单 GPU 简化版。关键理念是:人不再碰 Python 文件,而是去编程 program.md 这份 Markdown——它相当于给 agent 的上下文与「研究组织」设定。默认的 program.md 故意保持极简,留待后续迭代出「研究组织代码」。
二、是什么:三个文件,一条 5 分钟回路
仓库刻意保持极小,真正重要的只有三个文件(见下图的文件列表):
prepare.py:固定常量、一次性数据准备(下载训练数据、训练 BPE tokenizer)与运行时工具(dataloader、评估)。不允许 agent 修改。train.py:agent 唯一会改的文件。包含完整 GPT 模型、优化器(Muon + AdamW)与训练循环。架构、超参、优化器、batch size 全部开放。program.md:给单个 agent 的基线指令。由人来迭代修改,本质是一个「超轻量 skill」。
运行方式是把 Claude/Codex 这类 coding agent 丢进仓库(关掉所有权限确认),然后说一句「看一下 program.md,开个新实验」即可。
三、核心设计:固定时间预算 + 单一指标
autoresearch 有两个刻意的设计决策,理解了它们才能正确解读结果:
- 固定 5 分钟墙钟时间预算(不含启动/编译),无论你的 GPU 多强。这意味着每小时约能跑 12 个实验,睡一觉约 100 个实验。官方给出两个好处:一是无论 agent 改了什么(模型大小、batch、架构),实验之间都直接可比;二是它会在你的硬件上找到该时间预算下最优的模型。
- 单一指标
val_bpb(validation bits per byte,验证集每字节比特数),越低越好。之所以用 bpb 而不是 loss,是因为它与词表大小无关,架构改动可以公平比较。
四、关键数字:从官方 progress 图读出来的实测结果
官方仓库里的 progress.png(首图)是这一项目最有信息量的产物。它标题写明 83 次实验、15 次被保留为改进。从图上可核对的数字:
| 项目 | 数值 | 来源 |
|---|---|---|
| 实验总数 | 83 次 | 官方 progress 图标题 |
| 被保留的改进 | 15 次(保留率约 18%) | 官方 progress 图标题 |
| baseline val_bpb | 约 0.998 | 图中起点 |
| 最终最优 val_bpb | 约 0.977 | 图中台阶线终点 |
| 单次实验预算 | 5 分钟(墙钟) | README「fixed 5-minute time budget」 |
| 吞吐 | 约 12 实验/小时、约 100 实验/通宵 | README |
| 测试硬件 | 单张 NVIDIA H100 | README「tested on H100」 |
| 默认模型深度 DEPTH | 8 | README 调参建议 |
| 默认词表 | 8192 | README 调参建议 |
首图里被保留的改动很说明问题——agent 自己试出的方向包括:halve total batch 524K→262K (more steps)、warmdown 0.5→0.7、add 5% warmup、depth 9 aspect_ratio 57、unembedding LR 0.004→0.008、short window 1/4 context、embedding LR 0.6→0.8、RoPE base frequency 10000→50000→100000→200000,最后还有一步 random seed 42→137。灰色散点是被丢弃的实验——可见大多数改动并不带来改进,保留率并不高。
五、评测方法批判:哪些数字不能外推
这里必须把口径讲清楚,避免把这张图误读成「agent 自动把模型训好了」:
- 5 分钟预算下的 0.998→0.977 是相对改进,不是绝对质量。这是一个 nanochat 简化版、单卡、小数据上的相对曲线,BPB 绝对值和任何正式大模型不可比。
- 固定时间预算的代价是跨硬件不可比。官方原话:这样做的缺点是「你的运行结果和别人在别的计算平台上跑出来的结果不可比」。它优化的是「你的 H100 在 5 分钟内的最优」,不是通用最优。
- 83 次实验、15 次保留是这一次运行的样本,不是统计学结论;随机种子都被当作一个实验变量(42→137)保留下来,说明结果对噪声敏感。
- 它不是一个完整训练 pipeline:没有分布式、没有复杂配置、除 PyTorch 外几乎零依赖。官方把这称为「self-contained」。
六、局限与适用边界
平台局限:官方只支持单张 NVIDIA GPU(H100 测试)。作者明说不打算个人承担 CPU/MPS 支持,欢迎社区 fork。README 列出的知名 fork 有 macOS(miolini/autoresearch-macos、trevin-creator/autoresearch-mlx)、Windows RTX(jsegov/autoresearch-win-rtx)、AMD(andyluo7/autoresearch)。
小硬件调参建议(官方给 fork 作者的指南,可核对):换熵更低的数据集如 TinyStories;词表从 8192 降到 4096/2048/1024 甚至字节级 256;大幅降低 MAX_SEQ_LEN(可到 256);相应略增 DEVICE_BATCH_SIZE;降低 EVAL_TOKENS;主复杂度旋钮 DEPTH 从 8 降到 4;注意力窗口用 "L" 而不是 "SSSL"(后者的带状注意力在小卡上低效);TOTAL_BATCH_SIZE 降到 2 的幂如 2^14(约 16K)。
本质局限:这是一个「研究方法的脚手架」,不是产品。它演示的是「人写研究组织指令、agent 跑实验回路」这套范式能跑通;产出的模型本身没有任何部署价值。引言里「agent 们自称已到第 10,205 代代码、代码已成长为人类无法理解的自修改二进制」纯属玩笑,不要当真。
七、谁该关注
- 想验证「agent 自动做超参/架构搜索」到底能产出什么的研究者——这个 repo 是目前门槛最低的可复现样本;
- 想给自己的训练任务套一个「通宵实验循环」的工程师;
- 对 skill/agent 上下文工程感兴趣的人——
program.md本身就是一个极简范式。
对只是想训一个能用的模型、或没有单张 NVIDIA GPU 的人,现阶段更值得去看 fork 或父仓库 nanochat,而不是直接跑这个 baseline。