Jev 与 System One 模型:把"快决策"从大模型里拆出来
阅读时间: 大约 10 分钟
Jev 与 System One 模型:把”快决策”从大模型里拆出来
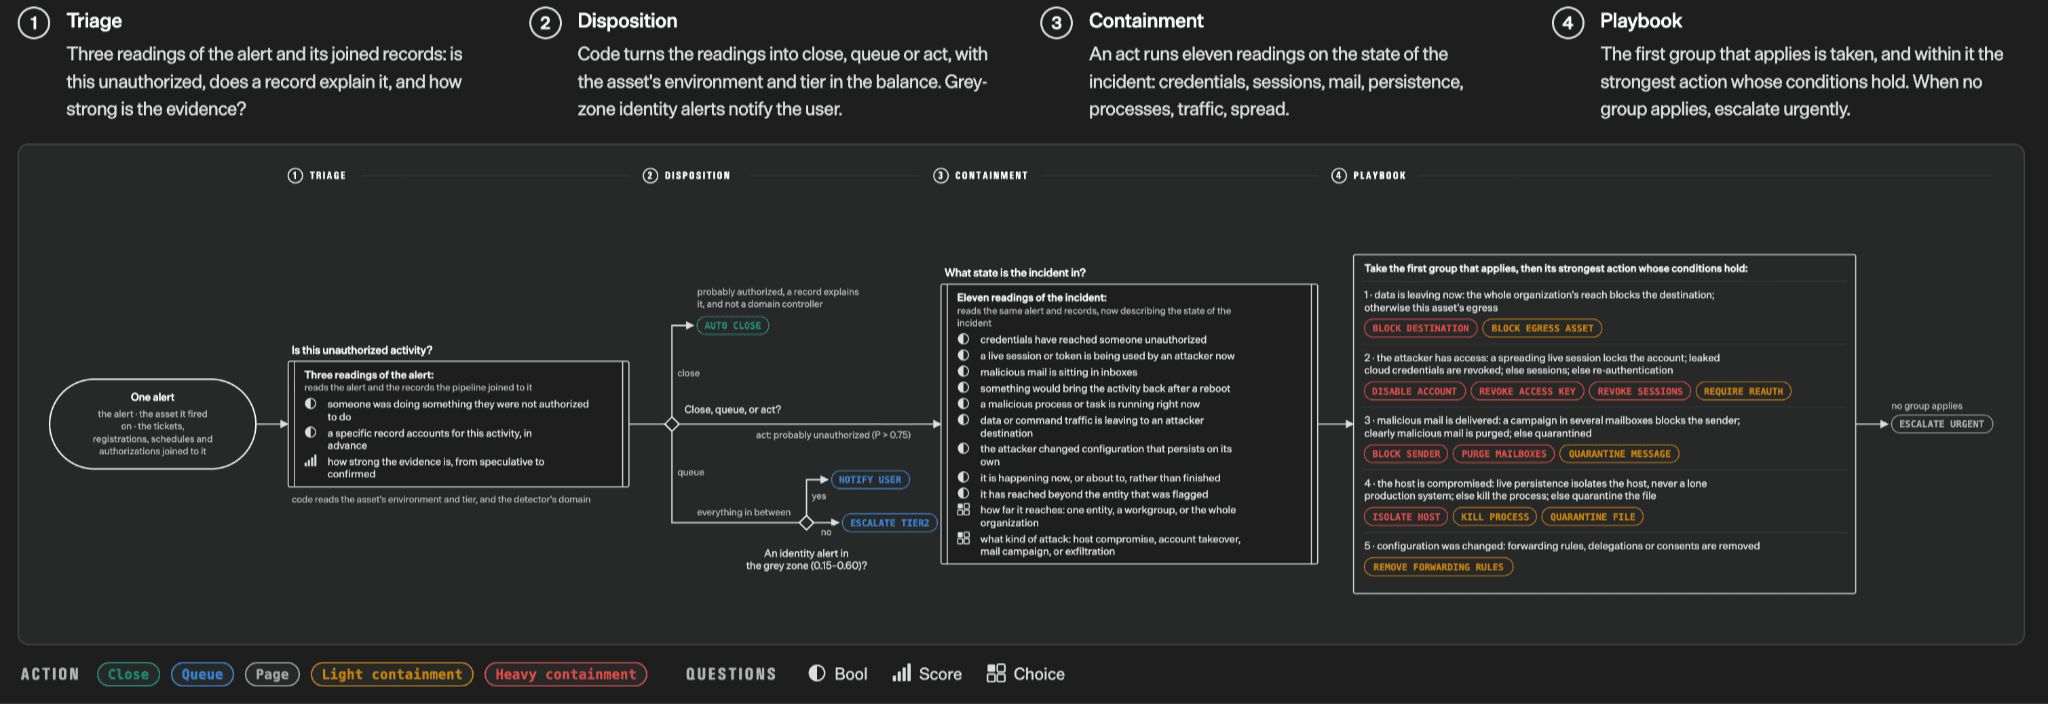
2026 年 9 月 15 日,由前 OpenAI 研究员 Diogo Almeida 创立的 TypeSafe AI 发布了首个 System One 模型 Jev,并开放早期试用。这不是又一个”更大的聊天模型”,而是一种刻意做减法的模型类别:它不生成字符串,输入非结构化状态,直接输出带校准置信度的、类型确定的结构化决策。本文基于 TypeSafe 官方公告与公开评测数据,对这一思路做一次严谨拆解。
一、出发点:聊天很”超人”,自动化在哪
Diogo Almeida 在 OpenAI 期间参与了让语言模型学会遵循指令、与人对话的核心方法研究,相关工作正是 ChatGPT 背后的技术之一。但他提出了一个尖锐的问题:模型在聊天上”超人”已经很多年,为什么真正的自动化没有随之到来?
他的判断是:通用聊天模型用”逐 token 自回归生成字符串”这一接口去承担一切任务,而字符串既灵活又不可靠——可以是聊天、代码,也可以是幻觉。对需要延迟保证、能被软件直接调用的自动化系统而言,一个幻觉出来的工具调用,在 Agent 里只是不方便,但如果它埋在依赖链深处、或处在有 SLA 的关键路径上,就是不可接受的。
System One 模型由此而来:它把大模型里那些”本不需要长篇推理”的快判断——分类、路由、打分、校验——单独拆出来,做成一个软件可以直接依赖的接口。
二、命名与定位:借喻”快慢思考”
两个名字都有出处:
- System One(系统一) 借自 Daniel Kahneman《思考,快与慢》:系统一是快速、直觉式的反应,系统二是缓慢、审慎的推理。TypeSafe 认为,系统一虽然常被认为”容易出错”,但可以通过专门设计使其比通用模型更可靠;
- Jev 命名自经济学家 William Stanley Jevons(杰文斯悖论):当蒸汽机效率提升反而推高煤炭消耗时,成本下降会解锁数量级更多的用途。TypeSafe 预期”智能成本每下降一个数量级,就会解锁一个数量级的新场景”。
从工程语义上,Jev 被描述为”一个前沿智能水准的函数调用”:非结构化状态进,带概率的类型化决策出。它牺牲了字符串生成能力,换来的是 schema 强约束、并行采样与数量级的效率。
三、技术栈:并行采样 + RLCD 训练
Jev 不是”一个小一号的 LLM”,而是围绕自动化重建的一整套栈:
- 新模型架构:面向结构化程序状态优化,而非面向多轮对话;
- 并行采样器:与逐 token 生成不同,Jev 一次性并行输出所有候选答案的概率,跳过了自回归的串行开销;
- RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习):这是它区别于 RLHF(按人类偏好优化写得好不好)和 RLVR(按可验证奖励优化)的关键——优化目标是”在系统一任务上,给出认识论上诚实的概率”。
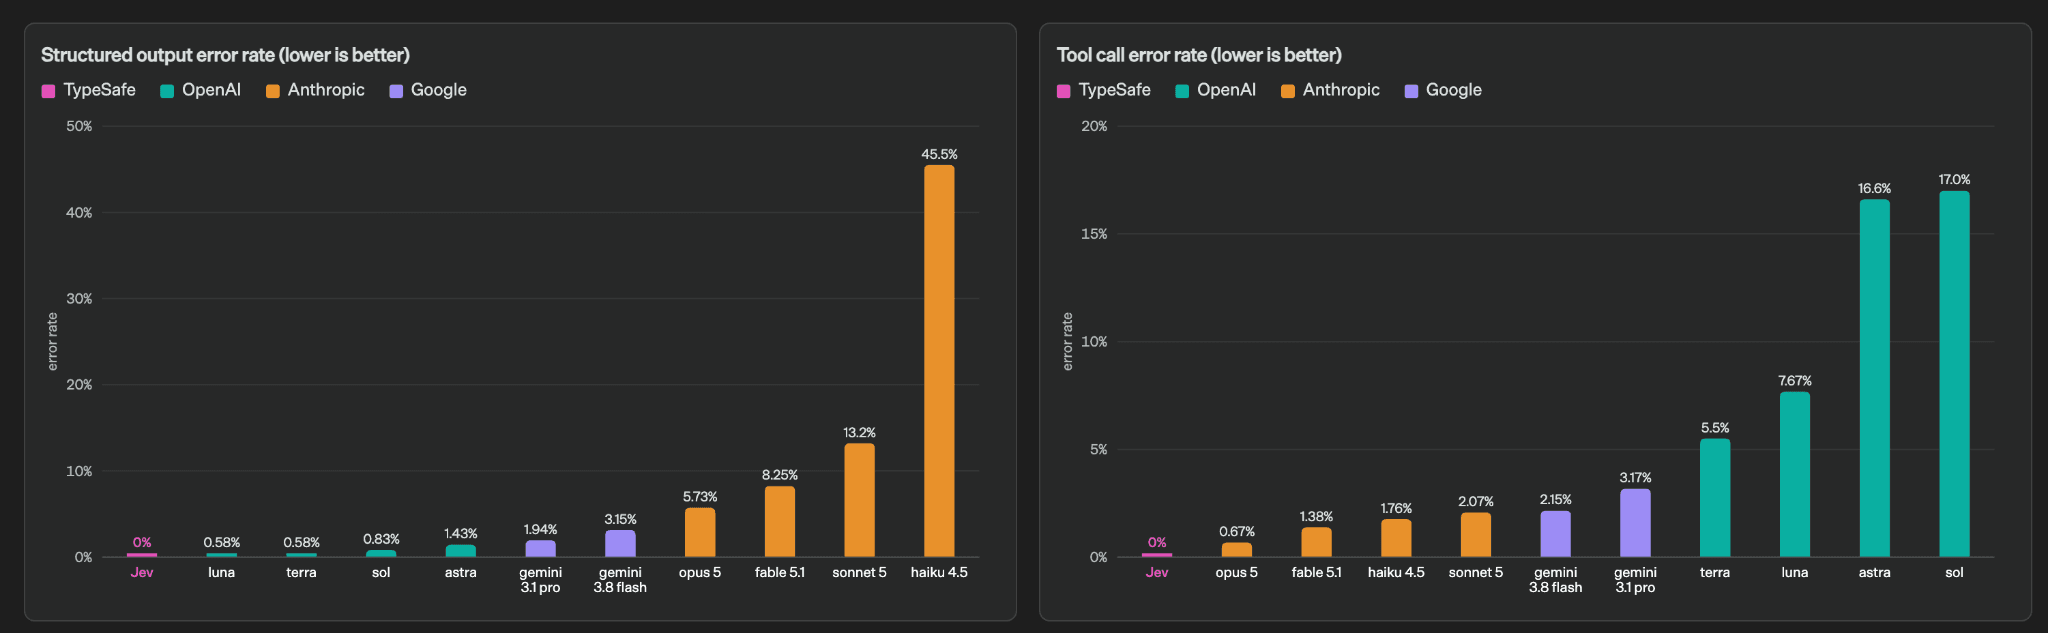
因为输出被 schema 限定在预设类型内,“类型错误”在数学上不可能发生;官方给出的结构化输出错误率为 0%。需要强调的是:这个 0% 是类型系统保证的结果,而不是在大规模真实数据上统计出来的——它意味着”不会输出一个不符合 schema 的东西”,并不等于”每次都选对选项”。
四、性能:速度、成本与错误率
官方公布的关键数据如下(均来自其早期服务,部署于美国西海岸):
| 指标 | Jev | 说明 |
|---|---|---|
| 单次决策时延 | 约 70–500 毫秒 | 并行采样,非逐 token |
| 官方宣称提速 | 最高约 193.6 倍 | 面向其工作负载评测,属上限区间 |
| 官方宣称降本 | 最高约 444.6 倍 | 同上 |
| 输入价格 | 约 $0.042 / 百万 token | 输出免费 |
| 最大选项基数 | 255 | 高基数时采用两阶段打分 |
| 结构化输出错误率 | 0% | schema 约束保证 |
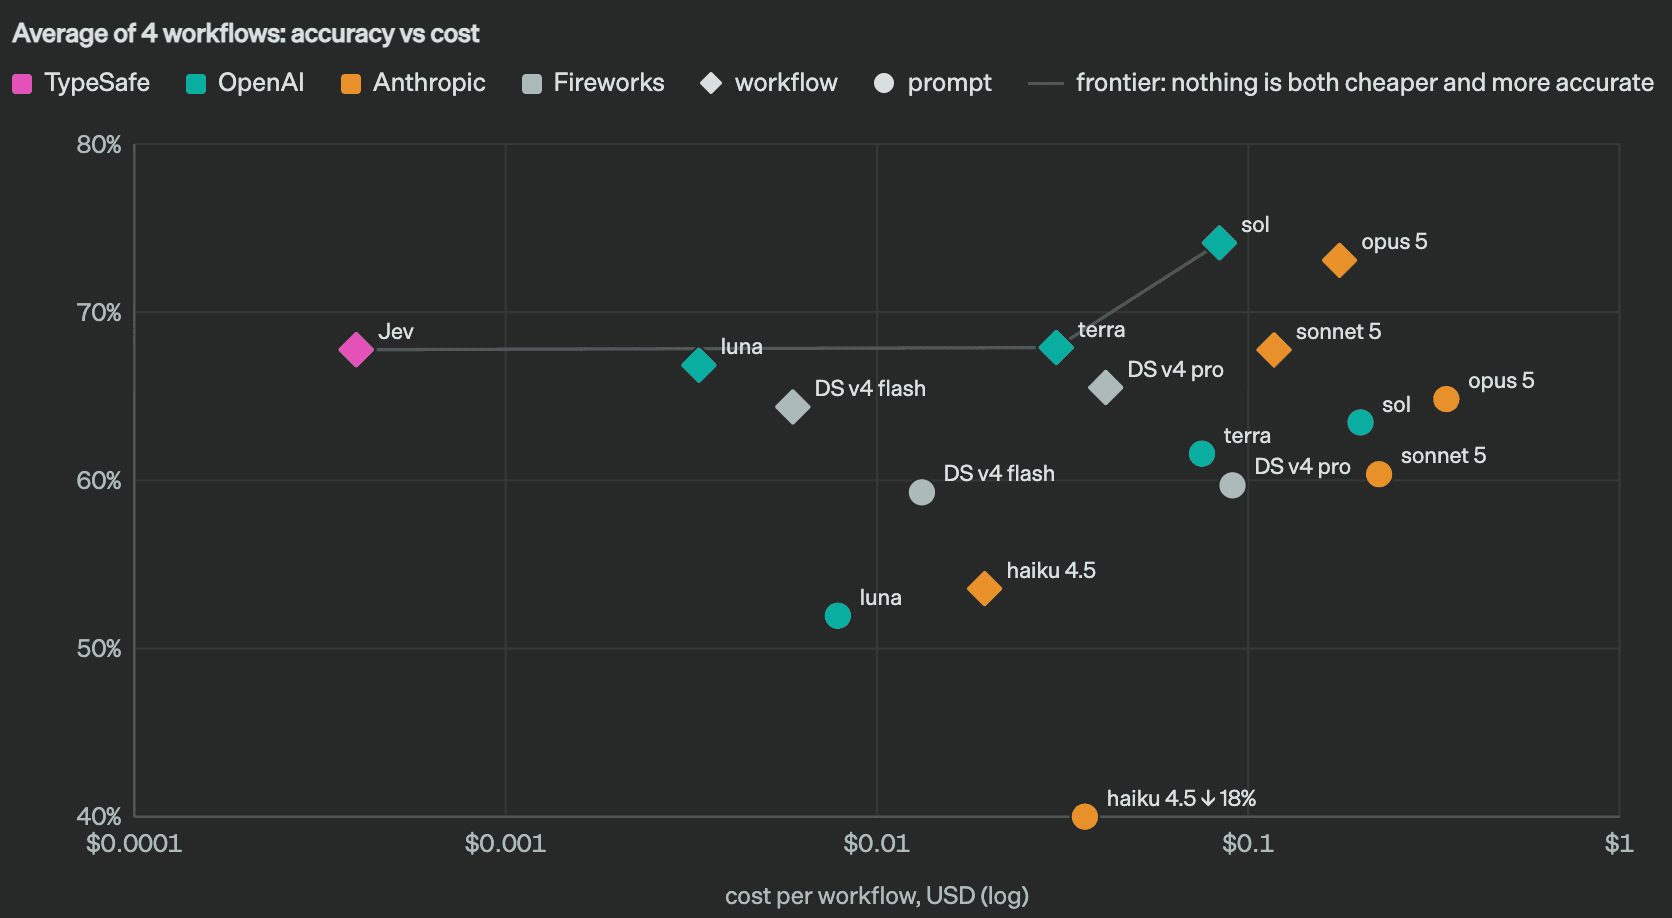
在官方的”4 个工作流平均准确率 vs 成本”图中,Jev(粉色菱形)落在横轴最左侧——成本比主流闭源模型低约两个数量级,而准确率(与最强外部模型的参考概率对齐)仍处于同区间;在结构化输出错误率上,Jev 为 0%,而对比模型最高达到 45.5%;在工具调用错误率上,Jev 同样为 0%,对比模型最高约 17%。
五、评测方法:用”最强模型”当裁判
值得专门指出它的评测设计。TypeSafe 没有用”给定标准答案做分类”这类容易被过拟合的基准,而是构造了带正确计算图(工作流)的评测:假设存在一段以代码表示的正确工作流,然后让最大、最贵的外部模型(其点名 Astra、Fable)在同一工作流上的预测概率作为参考答案,再比较各模型与这组参考的接近程度。
这一方法的好处是贴近真实生产负载:真实可靠的工作流往往由大量相互独立、可分解的小判断组成,最终才是离散分支。但它也有内在偏向——“接近最强模型的平均水平”并不等于”正确”,只是”接近强者”。官方自己也承认,对比用的 LLM 数据取自 OpenRouter,复杂请求可能被路由到更好的模型,存在偏差。
六、适合做什么、不适合做什么
适合的场景:
- 路由、分类、打分、审核、护栏、越狱检测——Agent 工作流里最贵最慢却本不需要长推理的判断环节;
- 实时应用:百毫秒级时延意味着可以放进对体验敏感的前端链路;
- 大规模 map-reduce:把海量数据压缩成特征与决策;
- 高基数选择:官方演示了实时玩《Doom》(约每秒 10 次查询,成本约 $7/小时)和 Wikiracing(在数百上千个维基链接中选路)。
不适合: 需要自由文本生成、长链路推理、开放式创作的任务——这些仍是通用大模型(系统二)的领地。
七、客观分析:优势与边界
优势:
- 接口正确:用类型化、带置信度的输出替代不可控字符串,正好击中 Agent 工程化最痛的”可靠性”问题;
- 效率/成本数量级领先:在快判断场景上把单次成本压到主流模型的约 1/100,使高频调用在经济上成立;
- 评测贴近工程现实:以工作流计算图而非静态题库来衡量,更接近真实自动化负载。
边界与存疑:
- 闭源且早期:仅早期访问、权重不开放,性能数据目前基本是一家之言;
- 0% 错误率的口径:是 schema 保证而非经验统计,“不选对”仍会发生,置信度是否真的校准需要第三方独立验证;
- 对比存在自利偏差:LLM 侧数据来自 OpenRouter,工作流评测以自家钦定的”最强模型”为参考,环境(西海岸时延)也利好自家;
- 定价可持续性未知:官方坦言无法证明当前价格没有补贴,长期能否维持要时间检验。
八、它意味着什么
Jev 的真正价值不在于”又一个模型”,而在于提出了一个被忽视的分工:系统一的快判断与系统二的慢推理,本就该是两种接口、两种成本结构。当 Agent 工作流里充斥着大量”这个工单要不要升级""这条消息是不是恶意”这类小决策时,用旗舰聊天模型逐 token 去做,既慢又贵还会幻觉。把这一层抽成一个便宜、快、类型安全的”决策函数”,是把 Agent 从”demo”推向”可托付生产系统”的关键一步。
对工程团队而言,现在更现实的姿态是:关注它能否在自己的路由/审核/打分场景上复现官方数据,并把它当作通用模型的互补层而非替代品——慢推理仍交给系统二,快判断交给系统一。
参考来源
- TypeSafe AI 官方博客:Introducing System One Models & Jev
- Koala 聊开源 科技周报:Jev|面向自动化的决策模型
- B 站视频:科技周报|面向自动化的决策模型;命令行邮件客户端;联邦 OIDC 身份认证(合集 6725872)