Google AX:把 Agent 当作一种新工作负载的开源运行时
阅读时间: 大约 9 分钟
Google AX:把 Agent 当作一种新工作负载的开源运行时
当各家框架忙着争论”怎么写一个 Agent”时,Google 把目光投向了更底层的问题:写出来的 Agent,到底该跑在什么上面? 2026 年年中,Google 将内部多年积累的 Agent 执行引擎经验整理为开源项目 AX(Agent Executor),以 Apache-2.0 协议发布在 github.com/google/ax,官网为 agentexecutor.io。它不打算再做一个”让你定义 Agent 行为”的框架,而是要做一个”让大量 Agent 任务被安全、高密度地调度执行”的运行时。
一、背景:Agent 既不是微服务,也不是批处理
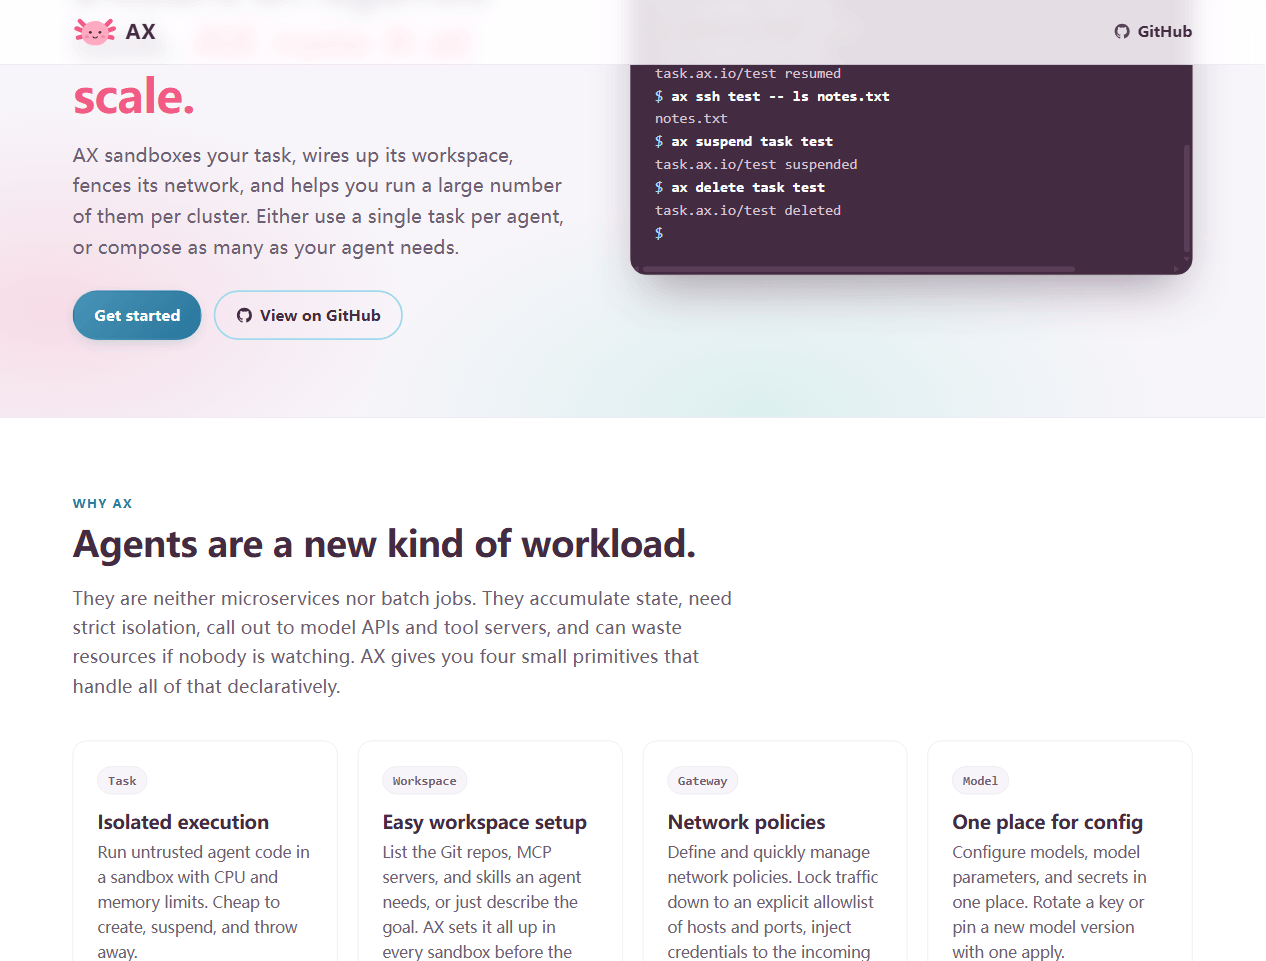
AX 官网对问题的定义相当直接:今天的 Agent 是一种全新的工作负载。它既有状态(持续累积上下文)、又天生”忽高忽低”——可能高强度计算一分钟,然后就在等模型响应、等工具返回、等人工审批中挂起几分钟甚至几天。
这带来一个传统编排系统解决不好的矛盾:
- 为无状态微服务设计的 Kubernetes 一类编排器,会让你为了”保持沙箱在线”而持续付费,却没有原生的”亚秒级挂起与恢复”能力;
- 为可预测批处理设计的系统,又扛不住 Agent 这种长尾、长驻、需要严格隔离的执行形态。
AX 官方称,它正是 Google 内部”agentic runtime 研究”(含 Google DeepMind 相关工作)与前沿算力实践相遇后的产物——先在 Google 内部经历了多年 Agent 执行引擎的建设与运维,才抽象成开源项目。
二、概念:一个任务用 YAML 声明,四个原语管全部
AX 的 API 风格明显借鉴了 Kubernetes:一个任务就是一段 task.yaml,带 apiVersion、kind、metadata、spec:
apiVersion: ax.io/v1alpha1
kind: Workspace
metadata:
  name: golang
spec:
  git:
    - repo: https://github.com/golang/go.git
      branch: "my-fix"
---
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: test
spec:
  workspaces:
    - name: golang
      goal: "Ensure that Go tool chain is available and built from source"
之后 ax apply -f task.yaml 即可拉起执行。围绕这段声明,AX 提供四个小而正交的原语:
| 原语 | 职责 | 关键能力 |
|---|---|---|
| Task | 隔离执行 | 在带 CPU/内存上限的沙箱里运行不可信 Agent 代码,创建、挂起、丢弃都很便宜 |
| Workspace | 环境准备 | 列出所需 Git 仓库、MCP server、技能;或直接用自然语言描述目标,由 Agent 首启时自动装配 |
| Gateway | 网络策略 | 把流量锁定到显式的主机/端口白名单,并在请求中注入凭证 |
| Model | 模型配置 | 模型、参数、密钥集中一处管理,轮换 key 或锁定模型版本只需一次 apply |
这种”把编排、网络、密钥、模型配置都收敛进声明式 API”的思路,和前面分析过的 Vercel Eve(文件即 Agent)属于同一波共识:Agent 需要一套属于自己的、而非从 Web 或数据中心借来的抽象。
三、技术机制:跑在 Agent Substrate 上
AX 本身跑在一个名为 Agent Substrate 的计算运行时之上(仓库为 github.com/agent-substrate/substrate)。官方强调它是”从头为高密密度与快速的有状态 actor 生命周期设计”的。三个关键设计点:
- 轻量 actor 模型:每个 Task 作为一个轻量 actor 运行,官方称单集群可扩展到”数十亿并发 Agent 会话”,不受传统编排器数量限制;
- 亚秒级恢复:在等待模型、工具或人工响应时,空闲 Agent 被 checkpoint、挂起,恢复时间官方称不到 1 秒,且无冷启动;
- 密集复用(dense multiplexing):多个 Task 共享 worker 资源,把”等待中的空闲时间”转化为”可调度的算力”,官方表述是”只在 Agent 真正思考和跑代码时才计费”。
此外还有”生成式工作区”:你用大白话描述一个就绪环境长什么样,AX 会在任务首次启动时把这个目标交给一个 Agent,由它去装好工具链、验证依赖。
四、可核对的数字与官方口径偏差
需要特别说明的是,AX 官网给出的几乎都是设计目标与官方自述,而非第三方实测基准:
- “单集群数十亿并发会话""亚秒级恢复""数十个 Task 共享 worker”均为官方在官网的宣传性表述,页面上没有给出对应的压测条件、硬件规格与对照实验;
- API 版本是
v1alpha1,按语义化惯例意味着接口仍可能破坏性变更,生产采用前要锁定版本并跟踪变更日志; - “传统编排器对空闲沙箱成本过高”是 AX 的立论前提,属于定位性论证,而非与 Kubernetes 的同场量化对比。
换句话说,AX 当前更准确的定位是:一个架构方向清晰、但仍在早期(alpha)的研究型运行时,其密度与恢复速度的实际收益需要部署方自行压测验证。
五、优势与局限
优势:
- 切中真实痛点:把”不可信代码隔离 + 环境装配 + 网络管控 + 凭证注入”这四件 Agent 刚需收敛成统一原语,避免每个团队重复造轮子;
- 安全分层干净:Gateway 在网络层做白名单与凭证注入,比把 key 塞进环境变量或 prompt 更接近”最小权限”;
- 对研究友好:可批量拉起可复现沙箱,用于采集轨迹、跑强化学习循环、做大规模评测。
局限:
- 成熟度低:alpha API、社区与文档尚在早期,生产落地有工程风险;
- 数字未独立验证:高密度、亚秒恢复等卖点缺第三方复现;
- 绑定较新栈:依赖 Agent Substrate,整条技术链都很年轻,排错资料少;
- 生态未形成:对比 Kubernetes 庞大的周边工具,AX 目前还只是核心运行时本身。
六、适合谁用
- 做 Agent 规模化调度的平台团队:需要同时跑成百上千个隔离 Agent 任务、且对空闲成本敏感;
- AI 研究团队:需要大量可复现沙箱来采集轨迹、做 RL 后训练与评测;
- 对”Agent 基础设施”感兴趣的架构师:可以把它当作”下一代 Agent 编排层”的参考实现来读。
但如果你只是想写一两个内部 Agent,现有框架 + 一台机器就够了,暂时不必背上一整套新运行时的学习与运维成本。