ForgeCode:长在 ZSH 里的开源 AI 终端编程助手
阅读时间: 大约 9 分钟
ForgeCode:长在 ZSH 里的开源 AI 终端编程助手
ForgeCode(仓库名 forge,命令行工具 forge)是 Tailcall, Inc. 推出的开源 AI 终端编程助手。它不做独立 IDE,而是直接寄生在 ZSH 里——你在熟悉的 shell 中敲一个 : 就能和 AI 对话,原有的 alias 与 Oh My Zsh 插件照常工作。官网首页赫然写着”World’s #1 Coding Harness”,并称其在 TermBench 2.0 上以 81.8% 准确率排名第一。本文基于官网、GitHub 仓库与官方博客的一手资料做一次克制的拆解。
一、它解决什么问题
过去一年里,“终端里的 AI 编程”赛道已经非常拥挤:Claude Code、Warp、OpenCode、Aider、Cursor CLI 等各有拥趸。ForgeCode 的差异化切入点有两个:
- 不另起炉灶,而是改造现有 shell:它构建在 ZSH 之上,开发者无需离开已经用了多年的终端环境,也无需把工作流迁到一个新的 TUI;
- 开源 + 多模型自由切换:底层用 Rust 编写(仓库内
crates/),Apache-2.0 协议,原生对接 OpenAI、Anthropic、Grok、DeepSeek、Gemini 等 300+ 模型,而不是绑定某一家。
Tailcall 这家公司此前以开源 GraphQL 编译器 Tailcall 闻名,ForgeCode 是其在 AI 工程工具方向的延伸。
二、核心机制
官网把它的能力拆成几块:
- Shell 内交互:在终端输入
:唤起 AI,支持问答、实现功能、修 Bug、代码审查、重构、数据库 Schema 设计、Git 操作; - 多模型分工:规划用 thinking 模型、写码用快速模型、看大文件用长上下文模型,可在同一会话内混搭而不重启;
- 多子 Agent 架构:由 FORGE、MUSE、SAGE 等专门子 Agent 分别负责研究、规划与执行,每一步只喂最小相关上下文,以降低上下文膨胀;
- ForgeCode Services:一个代码库上下文引擎,号称能快速导航大型代码库、用强工具纠正让本地小模型保持在正轨上,并可在数千个 skills 上扩展;
- 受限 shell 模式:限制文件系统访问范围,防止 AI 误改不该动的文件;
- 安全登录:首次运行通过
forge provider login交互式配置各模型提供商凭证。
安装方式是典型的一行脚本:curl -fsSL https://forgecode.dev/cli | sh。
值得对照的是它与 Claude Code 的定位差异:Claude Code 默认绑定 Anthropic 模型、以独立 TUI 体验取胜;ForgeCode 则刻意把自己做成”宿主 shell 的一层”,并把模型选择权完全交回给开发者。这种取舍决定了它的用户画像——更倾向于那些已经高度定制化自己终端环境、不愿为 AI 编程再学一套快捷键与目录结构的资深工程师,而不是想要开箱即用图形界面的新手。
三、关键数据(可核对)
以下数字来自官网与 GitHub 仓库页,访问时间 2026-09-30:
| 指标 | 数值 | 来源/口径 |
|---|---|---|
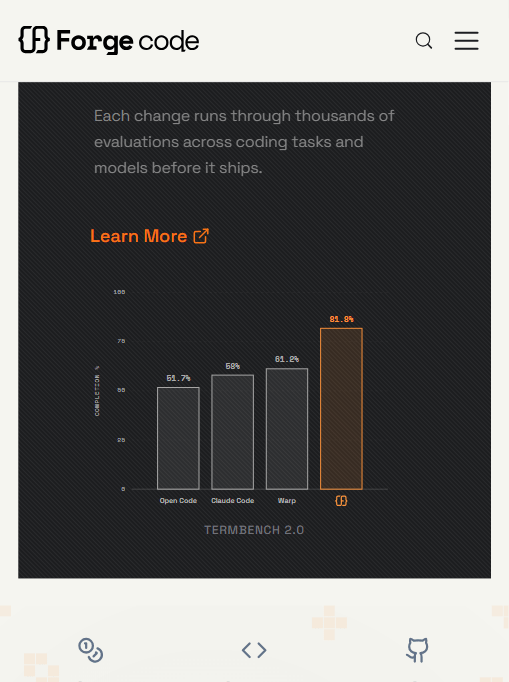
| TermBench 2.0 完成率 | 81.8% | 官网图表(官方自测) |
| 对比:Warp / Claude Code / Open Code | 61.2% / 58% / 51.7% | 官网同图 |
| GitHub Star | 约 7.6k | GitHub 仓库页 |
| GitHub Fork | 约 1.5k | GitHub 仓库页 |
| 开源协议 | Apache-2.0 | GitHub 仓库页 |
| 支持模型数量 | 300+ | 官网/README |
| 声称日调用量 | 38.1B+ tokens/天 | 官网自述遥测 |
| 声称日写码量 | 24.4M+ 行/天 | 官网自述遥测 |
四、评测方法批判:81.8% 该信几分
这是本文最想强调的一节。ForgeCode 的”第一”叙事建立在一张柱状图上,但需要拆开看方法学:
- Harness 与模型不可分:TermBench 测的是”编程框架/harness”完成任务的能力,但同一个 harness 换不同底座模型,分数天差地别。图中 Open Code、Claude Code、Warp 分别用的是什么模型、什么版本、什么提示词,官网这张图没有披露。因此 81.8% 是”ForgeCode + 它所选的模型配置”这一组合的成绩,不能直接等同于 ForgeCode 这个工具本身比竞品强 20 个百分点;
- 自测偏差:基准由产品方自己运行、自己挑对比对象,没有第三方复现。TermBench 2.0 的任务集、通过标准是否对各方一致,需要去 benchmarks 目录与官方 benchmark 仓库核对;
- 使用量数字是遥测自述:38.1B tokens/天、24.4M 行/天来自产品自身的聚合遥测,不是独立统计,且包含了 ForgeCode Services 云端的量,口径不透明;
- “World’s #1”是营销话术:在一个模型迭代以周计的赛道里,单点基准排名的半衰期极短,今天的第一可能在下个月换个模型就易主。
换句话说,这张图可以作为”ForgeCode 在某个受控对比里表现不错”的参考,但不能作为选型时的决定性依据。
五、优势与局限
优势:
- 对 ZSH 用户几乎零迁移成本:不改变终端习惯,alias、插件全保留;
- 真正多模型、不锁定厂商:300+ 提供商与同会话模型混搭,适合按任务选性价比;
- 开源 Apache-2.0 + Rust:可自审、可二次开发,受限 shell 模式提供了基本的防误操作边界;
- 多子 Agent + 有界上下文的思路,对大型代码库场景有工程意义。
局限:
- 绑定 ZSH:习惯 bash、fish、PowerShell 的用户无法原生享受,Windows 原生环境(非 WSL)支持受限;
- curl | sh 安装:一行脚本安装有供应链考量,企业环境通常需要审脚本后再装;
- 基准排名的方法论不透明:如上文所述,81.8% 的可比性需要独立验证;
- 服务化与开源的平衡:ForgeCode Services 提供云端上下文引擎,离线纯本地体验是否同样强,官方没有给出对等的本地基准;
- 项目仍在快速迭代:发布数 350+、提交 2700+(官网页脚数据)意味着 API 与配置可能频繁变动。
六、谁该用
- 重度 ZSH、想留在终端里做 AI 编程的开发者:尤其值得一试,迁移成本最低;
- 需要按任务切换不同模型、不希望被单一厂商绑定的团队:它的多模型路由有实际价值;
- 企业安全敏感场景:建议先在受限 shell 模式下灰度,并审计安装脚本与遥测上报;
- 把”TermBench 第一”当决定因素的人:请先去核对基准方法与模型配置,再下结论。