Files SDK:一个接口打遍 S3/R2/GCS/Azure 等 40+ 对象存储
阅读时间: 大约 8 分钟
Files SDK:一个接口打遍 S3/R2/GCS/Azure 等 40+ 对象存储
对象存储抽象层不是新赛道——aws-sdk、GCS client、Azure storage SDK 各管一摊,社区也早有 unstorage 之类的尝试。Files SDK(v2.6.2)是这个赛道里的新玩家,卖点是「Write once. Store anywhere」:一套小 API 统一 S3、R2、GCS、Azure Blob 以及 40 多个其他适配器,并且明显把 AI Agent 当成一等公民。本文基于其官网做分析。
一、它解决什么问题
同一个业务里,文件往往散落在不同存储:用户上传走 S3、静态资源在 Cloudflare R2、内部数据在 GCS、归档在 Azure Blob、本地开发用 MinIO。每个 SDK 的 API、分页、错误模型都不一样,切换厂商要改一堆调用点。
Files SDK 的做法是把操作收敛成一组固定方法:
import { Files } from "files-sdk";
import { s3 } from "files-sdk/s3";

const files = new Files({ adapter: s3({ bucket: "uploads", region: "us-east-1" }) });

await files.upload("hello.txt", "world");
const file = await files.download("hello.txt");
await files.head("hello.txt");
await files.list();
await files.delete("hello.txt");
换后端只换 adapter 配置,调用点不动——官网用 S3、R2、Vercel Blob、Netlify Blobs、MinIO 五个 provider 演示同一段代码。
二、能力面:不止 CRUD
官网列的操作比典型抽象层更全:
- 基础操作:upload、download、head、exists、copy、move、list、delete,所有 adapter 同形;
- 批量与流式:传数组即带并发上限的批量操作;list 是普通 async iterable,
listAll({prefix})逐页遍历; - 搜索:
search()按 glob(默认)、正则、子串、精确匹配找 key,结果流式返回,glob 的前缀会剪掉无关目录的遍历; - 传输细节:分片并行上传、实时进度、字节范围下载、生命周期钩子;
- 逃生舱:需要原生能力时可以拿到对应云厂商的原生 client——抽象层不把你锁死。
三、面向 AI Agent:这是它的真正差异点
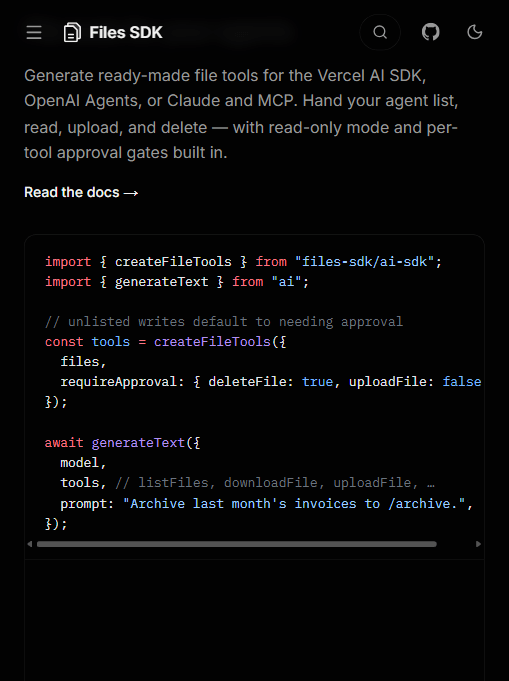
把它和传统对象存储抽象层区分开的,是「文件工具 for agents」这一节:
import { createFileTools } from "files-sdk/ai-sdk";

const tools = createFileTools({
  files,
  requireApproval: { deleteFile: true, uploadFile: false },
});
它能为 Vercel AI SDK、OpenAI Agents、Claude/MCP 直接生成 list/download/upload/delete 工具,并内置:
- 只读模式;
- 按工具粒度的审批门槛(如
deleteFile默认要求人工批准,uploadFile放行); - 未列出的写操作默认需要审批。
在 Agent 越来越频繁地读写文件(归档发票、整理下载、清理临时目录)的趋势下,「给 Agent 一个权限可控的文件系统」确实是个时机点。官网还提供一个 CLI:每个 SDK 方法都是一条命令,支持 stdin/stdout 流式、--provider 切后端、默认 JSON 输出,方便脚本与 CI。
四、必须自己评估的口径与风险
抽象层的固有代价:覆盖度 ≠ 能力对等。40+ adapter 听起来很美,但每个云厂商的专属特性(S3 的生命周期规则、R2 的定制域名、Azure 的分层归档)在统一接口下必然被裁剪。官网说有「escape hatch」拿原生 client——这本身就承认了:想用上高级特性,迟早要离开抽象层。
「同一套 API」下的语义差异是隐性坑。不同后端的最终一致性、列表分页语义、删除行为可能不同;抽象层抹平了签名,但没抹平底层行为。迁移时要对自己的关键路径做测试。
厂商绑定的是凭证而非 SDK。换 adapter 容易,但数据仍在各家云上,跨云复制、出口流量费才是真成本——Files SDK 让「换 SDK」变容易,不让「换云」变免费。
项目年轻:v2.6.2,适配器覆盖广意味着大量边缘 case 未打磨;社区案例与生产背书需要时间积累。
五、适用与不适用场景
适合: 同时对接多家对象存储、想要一套统一读写接口的后端/全栈团队;为 AI Agent 提供权限可控文件操作的开发者;需要 CLI 在脚本/CI 里跨 provider 传文件的人;想在 MinIO 本地与 S3 生产间无缝切换的项目。
不适合: 深度依赖某家云存储专属高级特性、抽象层会挡路的团队;对抽象层性能开销敏感的极高频热路径;需要跨云数据复制/一致性保证的场景(它是操作抽象,不是存储网格)。
六、客观分析:优势与意义
优势: 统一 API + 40+ adapter 覆盖广;async iterable、glob 搜索、分片/进度/字节范围这些工程细节做全了;面向 Agent 的只读模式与按工具审批是真正的差异化;CLI 与逃生舱设计务实。
局限: 抽象层必然裁剪厂商专属能力;底层语义差异仍需自测;跨云真实迁移成本不在 SDK 内;项目年轻。
Files SDK 的时机判断是准的:当 Agent 开始频繁处理文件,「一个权限可控、接口统一、能接 MCP 的文件工具层」就成了刚需。它不解决多云存储最难的数据治理与成本问题,但把「让代码和 Agent 都能用同一种方式碰文件」这件事做顺了——这正是抽象层该干的活。