Entire:让"这段代码为什么这么写"直接回到 Git 历史里
阅读时间: 大约 6 分钟
Entire:让”这段代码为什么这么写”直接回到 Git 历史里
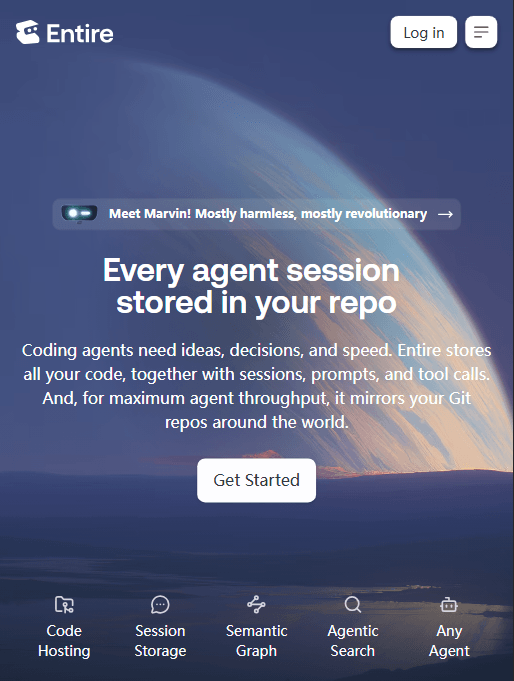
AI 生成代码有个长期痛点:提交记录里只有 diff,没有”为什么这么写”。三个月后回看一个 commit,你不知道当时 Agent 经历了什么对话、做了哪些取舍。Entire(内部代号 Marvin)的思路是:把每次 Agent 会话和对应的代码改动绑定,一起存进你的仓库。本文基于其官网分析。
一、它是什么
官网定位:“Every agent session stored in your repo.” 它把代码与 sessions、prompts、tool calls 存在一起,并为了 Agent 吞吐把 git 仓库全球镜像。它自称是一个”新的开发者平台”,能力覆盖 Code Hosting、Session Storage、Semantic Graph、Agentic Search、Any Agent 接入。
二、核心机制:commit 即 checkpoint
官网 Sessions 一节讲得很清楚:“Every commit an agent makes becomes a checkpoint: the code change paired with the conversation behind it.” 也就是说,Agent 每做一个提交,就生成一个检查点——代码 diff + 背后那段对话串起来就是 session。这样你可以把任意改动追溯回它的推理,也能把历史喂给新 Agent 让它”站在前面的肩膀上”。
从官网示例看,session 记录标注了来源(Claude Code / Fable 5、Codex / GPT-5.5)、检查点数与时间。
三、关键数字与口径
- “比竞品快 89 倍”是自测口径:官网称 Agent clone/push 可比竞品快最多 89 倍,但紧接着注明 “All results were measured with forgemark, our open source Git benchmark”——这是它自己写的开源基准,测试环境、对比对象都由它定。89x 是营销数字,需在自己仓库规模下复核。
- 全球镜像换吞吐:多区域已上线(美国东、欧盟中部、澳洲、印度),“data resident by design”;去中心化全球布局标注为 “SOON”。
- CLI 优先:第一原则是”所有功能都能通过 CLI 完成,不必离开 Agent”,Web app 是补充——这是为”Agent 是主力用户”设计的。
四、口径偏差与风险(结合项目库点评)
- 会话数据膨胀:把完整对话存进 git 历史,仓库体积会快速膨胀;项目库点评明确点了这一隐患——不是所有会话都值得长期留存。
- 隐私敏感信息泄露:对话里常含密钥、内部链接、客户数据,把它们纳入 git 历史(哪怕是私有仓)意味着敏感面扩大。官网 commit 里出现的 “redaction-scanner-selection” 说明它自己也意识到要做脱敏,但脱敏是否默认开启、是否可靠需自验。
- 它是托管平台:虽然数据”存进你的 repo”,但 Entire 本身是一个商业开发者平台(项目库称其靠六千万美元种子轮出名),迁移锁定与长期成本要评估。
- 早期产品:官网仍是 “A new developer platform is coming”,功能与稳定性需以实际体验为准。
五、适用 / 不适用
适合:
- 重度依赖 AI 编码、迫切需要”改动可追溯到决策过程”的团队;
- 想给新 Agent 提供历史上下文、避免重复踩坑的工作流;
- 有多区域团队、需要仓库就近访问的组织。
不适合:
- 对对话内容里的密钥/敏感数据有强合规要求、又不想自建脱敏的团队;
- 仓库体积敏感、不愿历史被会话记录撑大的项目;
- 已经在 GitHub/GitLab 工作流里很顺、迁移意愿低的团队。
六、它意味着什么
Entire 押注的判断是:AI 时代的代码历史,不该只有 diff,还要有决策过程。把 prompt 会话写进 git,确实比单独建一个知识库更自然——上下文就在改动旁边。但它把”可追溯”和”数据膨胀/隐私暴露”这对矛盾一起端了出来。这个方向代表了 AI 编程工具的下一步竞争:不只是写得快,而是让生成的代码可解释、可继承。能不能成,取决于它把脱敏和存储成本这两件脏活干得够不够干净。