DuckLake 1.0:把元数据塞进 SQL 数据库的 Lakehouse 格式
阅读时间: 大约 10 分钟
DuckLake 1.0:把元数据塞进 SQL 数据库的 Lakehouse 格式
2026 年 4 月 13 日,DuckDB 团队发布 DuckLake v1.0,随 DuckDB v1.5.2 一同推出。它不是又一个查询引擎,而是一个 lakehouse 表格式规范——与 Delta Lake、Apache Iceberg 同属一个赛道,但哲学截然相反:Iceberg/Delta 把表元数据分散成对象存储里一堆 JSON 快照与 Avro 清单文件,DuckLake 则把全部元数据存进一个会说 SQL、有主键、能持久化的数据库。本文基于官方公告,拆解这套「SQL 即元数据」的思路到底解决了什么、又主动放弃了什么。
一、背景:Iceberg 的复杂度门槛
过去两年,Iceberg 标准化是数据栈最热的话题之一,但它最大的门槛也随之暴露:要正确读写 Iceberg 表,你得理解 snapshot、manifest list、manifest file、data file、schema evolution、并发提交协议……本质上是在对象存储上手工实现了一个分布式事务子系统。Koala 的点评很直接:小团队跑 Iceberg 约等于运维一个分布式系统。
DuckLake 在 2025 年 5 月的 manifesto 里押了一个判断:九成 lakehouse 用户其实不需要 Iceberg 那套分布式扩展性,他们需要的是「数据放在对象存储上、能像数据库一样查」。既然如此,把元数据交给一个成熟的 SQL 数据库去管(事务、锁、查询优化全部白嫖),自己只管数据文件,反而更简单可靠。v1.0 就是这个思路走向生产就绪的标志。
二、是什么:规范 + 参考实现
DuckLake 官方定位:把数据存在对象存储上、当数据库访问,类似「Delta Lake + Unity Catalog」或「Iceberg + Lakekeeper」。关键差异在于 catalog(元数据库):
- catalog 可以是任意会说 SQL、支持主键、能持久化的数据库;
- 参考实现(DuckDB 的
ducklake扩展)目前支持三种 catalog:SQLite、PostgreSQL、DuckDB 自己; - 数据文件仍是开放的 Parquet,可与现有 Parquet 生态互通。
也就是说,一次提交不再是「写一个新的 JSON 快照文件」,而就是 catalog 数据库里的一条 SQL 事务。并发写靠 Postgres 的事务隔离来协调——这正是其「多 DuckDB 实例通过中心 Postgres catalog 共享同一份 DuckLake」多人协作模型的基础。
采用度上,官方称 ducklake 扩展已按下载量跻身 DuckDB 核心扩展前 10;已有 DataFusion(Hotdata)、Spark(MotherDuck)、Trino(两个社区实现)、Pandas 的客户端;MotherDuck 提供托管 DuckLake 服务;官方称已有「数十家公司」在生产使用,并已有 O’Reilly 书籍在撰写中。附录披露:自 2025 年底以来合并了 108 个 PR,其中 68 个聚焦可靠性与正确性、12 个性能、12 个内部重构——可见这个版本的主题是「做稳」。
三、v1.0 的四个新特性
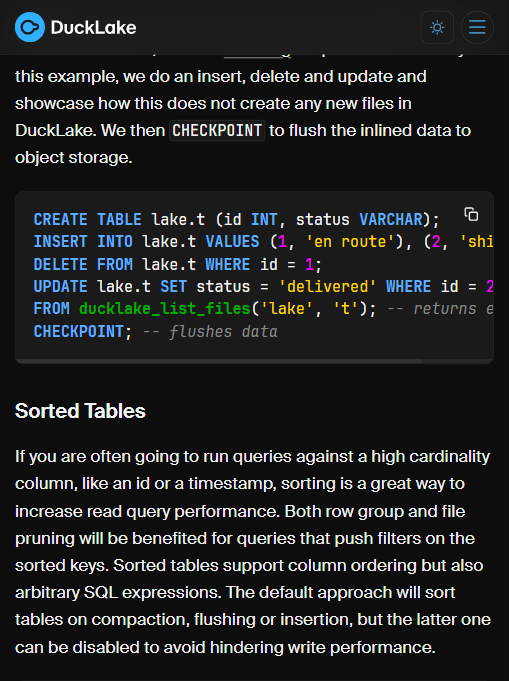
Data Inlining(数据内联,旗舰特性):小的 insert/delete/update 直接写在 catalog 数据库里,避免数据湖最头疼的「小文件问题」。v1.0 默认开启,阈值为 10 行——上图那段 SQL 做了增删改后,
ducklake_list_files返回空,直到CHECKPOINT才把累积的小改动 flush 成 Parquet。官方称这让「流式写入数据湖」成为可能。Sorted Tables(有序表):可对高基数列(id、时间戳)排序,利用 row group 与文件级裁剪加速带过滤的查询;支持任意 SQL 表达式作为排序键。
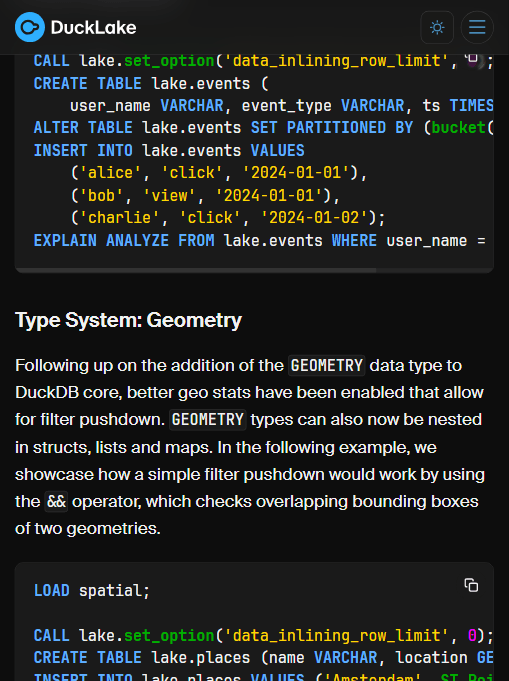
Bucket 分区:对高基数列做哈希分桶(采用 murmur3,与 Iceberg 完全兼容),作为普通范围分区之外的补充。
类型系统增强:随 DuckDB core 引入的 GEOMETRY 类型获得更好的统计信息与过滤下推(
&&包围盒相交判断),可嵌套在 struct/list/map 中;同时支持 VARIANT 半结构化类型。
四、官方自己标注的口径偏差与路线缺口
这一节必须写,因为官方 roadmap 直接承认了 v1.0 还没有什么:
分支(branching)与角色权限要等 v2.0,且 v2.0「短期内不会来」。官方原话:git 式分支合并、基于权限的角色控制目前都不在 v1.0——权限只能靠你自己把 Postgres 和 S3 配置好来兜底,DuckLake 本身不管。这对需要「数据分支做实验」「细粒度行列权限」的团队是硬缺口。
增量物化视图也在 v2.0 愿望清单——目前物化视图只能全量重算。
VARIANT inlining 有 catalog 依赖:官方在 v1.1 计划中明确写道,当前 variant inlining 只在原生支持 Variant 类型的 catalog(如 DuckDB 自身)上生效;如果 catalog 不支持 Variant,这张表永远不会被 inlining。也就是说,用 Postgres 当 catalog 时,带 VARIANT 列的表享受不到小写入优化。
「生产就绪」是规范层面的承诺:v1.0 保证向后兼容,但 DataFusion/Spark/Trino 客户端多为社区或厂商早期实现,成熟度不一;官方把「数十家公司生产使用」作为佐证,却没有公开的对比基准(与 Iceberg/Delta 的吞吐、压缩率对比),这类数字属于「官方称」,需自行压测。
五、适用与不适用场景
适合: 中小数据规模、想用对象存储当数据湖又不想运维 Iceberg 复杂度的团队;需要本地/单机友好(SQLite catalog)的数据分析与 ML 场景;已有 DuckDB 技术栈、想要多人共享同一份数据的团队;流式小批量写入(inlining 专治小文件)。
不适合: 已有成熟 Iceberg/Delta 治理体系、强依赖分支、时间旅行精细语义与统一权限目录的大数据平台;跨引擎大规模并发写、需要细粒度行列权限即开即用的场景;期待官方给出跨格式性能对比的团队——目前没有。
六、客观分析:优势与意义
优势: 用成熟 SQL 数据库承担事务与元数据,把 lakehouse 的认知负担降到「会 SQL 就会」;inlining 直击小文件痛点;Parquet 开放格式 + 多引擎客户端避免了二次锁定;规范版号化、向后兼容,工程姿态克制。
局限: 放弃了 Iceberg 式的分布式元数据扩展性,catalog(尤其 Postgres)会成为写路径上的中心依赖与单点;分支/权限/增量视图等「数据仓库级」能力仍在路线图上;客户端生态年轻。
DuckLake 的真正信号是:lakehouse 世界正在分裂成「超大规模分布式治理」与「中小团队极简数据栈」两个市场。前者继续押注 Iceberg,后者或许更愿意接受「一台 Postgres 管元数据」的朴素方案。它不是 Iceberg 的替代,而是给那批「我只是想在对象上跑 SQL」的用户一个不必背上分布式系统的选择。