DuckDB 官方本地 UI 界面:一个扩展把浏览器变成 SQL 工作台
阅读时间: 大约 10 分钟
DuckDB 官方本地 UI 界面:一个扩展把浏览器变成 SQL 工作台
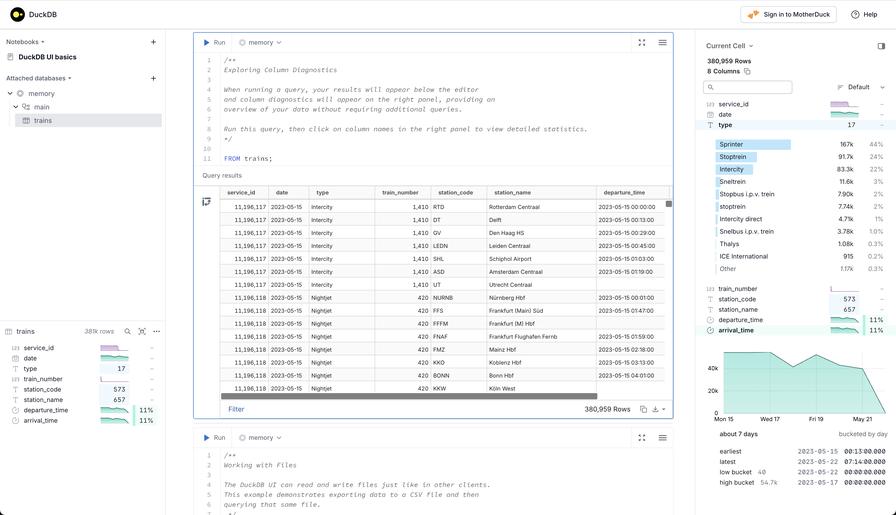
2025 年 3 月 12 日,DuckDB 核心团队(Jeff Raymakers、Gábor Szárnyas)联合 MotherDuck 发布公告:自 DuckDB v1.2.1 起,随 ui 扩展内置一套完整的本地 Web UI。一条 duckdb -ui 命令或一句 CALL start_ui(); 即可在浏览器里打开一个 Notebook 式 SQL 工作台。这件事看似只是”补了个界面”,背后却是 DuckDB 对自己”简单优先”定位的一次落地——此前用户想用 GUI,必须自己在第三方工具里挑、装、配。
一、背景:CLI 够用,但不够”开箱即用”
DuckDB 的长期定位是”进程内分析型数据库”:嵌入在 Python、R、Java 等宿主进程里跑,默认交互入口是命令行 CLI。CLI 支持多行编辑、自动补全和进度条,但官方自己也承认两个痛点:写长 SQL 时终端体验局促;数据探查能力(看列分布、看统计量)很弱。
生态里并非没有第三方 GUI——DBeaver、DataGrip、DuckDB 社区衍生工具都能连——但”选哪个、怎么装、怎么连到本地文件”对新手并不友好。官方 UI 的动机很直白:用 DuckDB 应该像用 CLI 一样简单,不该为了一个表格视图先做一轮技术选型。
二、是什么:本地 Notebook + 列探查器
UI 的交互模型是”Notebook”:把工作组织成命名笔记本,每个单元格可执行一条或多条 SQL,支持语法高亮与自动补全,可整格运行也可选中片段运行。结果表格自带排序、过滤与导出控件。
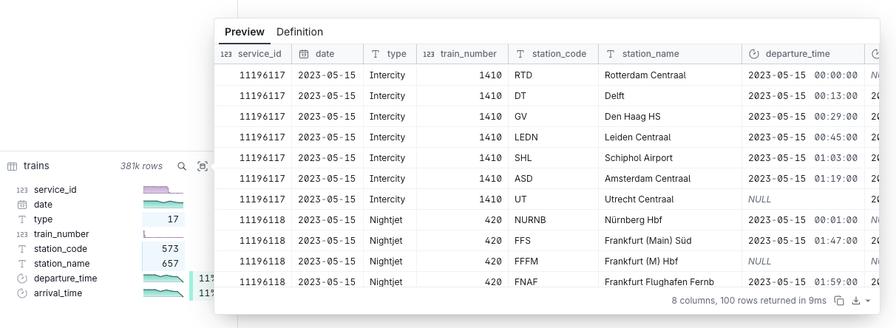
围绕 Notebook,官方给出的功能矩阵如下(依据发布博客 Features 一节整理):
| 模块 | 能力 | 说明 |
|---|---|---|
| 数据库树 | 浏览已 attach 的库/表/视图 | 含内存库、本地文件,以及 URL 直挂(如 blobs.duckdb.org 上的远端 .duckdb 文件) |
| 表摘要 | 行数、列名与类型、列画像 | “Preview data” 按钮查看前 100 行,可切到 Definition 看建表 SQL |
| Notebook 单元格 | 多语句 SQL、高亮、补全 | 支持整格或选区执行 |
| 列探查器(Column Explorer) | 直方图 + 分位数统计 | 对查询结果集的每列自动出图出数 |
| MotherDuck 集成 | 登录后可连云端数仓 | 默认关闭,需显式登录授权 |
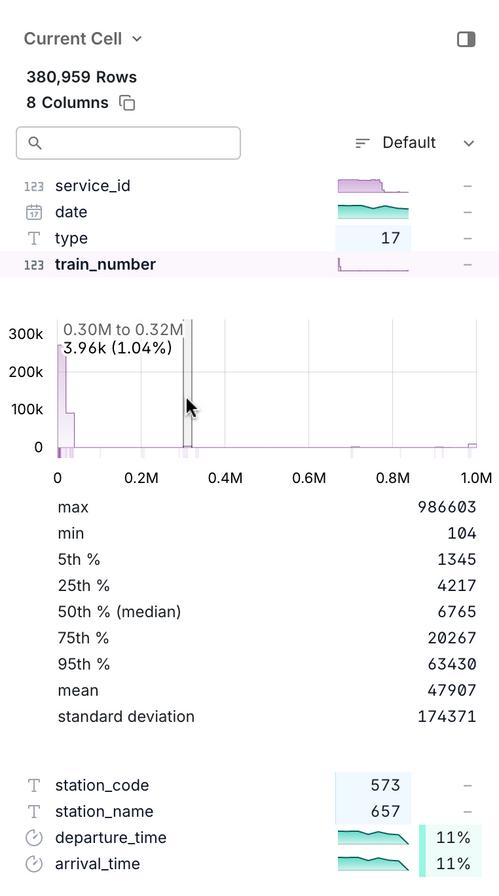
列探查器是这套 UI 里最有信息量的一块:任一查询结果返回后,右侧自动列出每列的迷你直方图;点开某列即展开完整画像——示例截图里 train_number 一列就给出 max 986603、min 104、5%/25%/50%(中位数 6765)/75%/95% 分位、均值 47907、标准差 174371,顶部还有一个可拖拽范围的直方图刷选器。官方示例里一次查询返回 380,959 行、8 列,表预览接口显示”100 rows returned in 9ms”——这类数字是示例数据集上的瞬时表现,不构成性能声明。
三、技术机制:一个扩展内嵌 HTTP 服务
UI 不是独立安装包,而是 DuckDB 的一个扩展(extension)。首次执行 duckdb -ui 或 CALL start_ui(); 时自动下载并加载 ui 扩展,随后:
- 扩展在本地嵌入一个 localhost HTTP 服务器,既托管前端浏览器应用,也暴露与 DuckDB 通信的 API;
- 该服务复用启动它的那个原生 DuckDB 实例——也就是说,UI 里查的就是你进程内那份内存、计算与文件系统,不经过第二个数据库;
- 查询结果以接近 DuckDB 内存中表示(DataChunk)的二进制格式返回,减少序列化开销;
- 用 Server-Sent Events 推送 attach 新库等增量通知,官方称由此带来”低延迟、不打断思路”的体验。
落地痕迹很轻:状态文件放在 home 目录 .duckdb/extension_data/ui/ 下,笔记本与界面状态持久化在一个 ui.db 里;导出剪贴板/文件时会生成 ui_export.csv 之类的临时文件,导出完成后数据被清空,仅留近空占位文件。
四、评测方法批判:没有 benchmark,只有设计声明
需要清醒看到,官方博客对性能的全部表述是定性的——“low-latency experience""efficient binary form”——没有给出任何时延、吞吐、内存占用的对比测试。其”低延迟”论证链条是工程直觉(零拷贝二进制结果 + SSE),而非实测数字。这与 DuckDB 主项目动辄发布 TPC-H 对比图的风格形成反差,本身说明 UI 团队把它当作工具性发布,而非性能竞赛。
另一处方法论上的偏向值得点名:界面截图里那些统计量(中位数、标准差等)是 DuckDB 对查询结果集现场计算的画像,属于 OLAP 扫描的强项;把它展示为”列探查”亮点,隐含了”你的表足够大能被 DuckDB 扫得动”这一前提——对真正的巨型外表,画像本身的扫描成本并不会被 UI magically 消除。
五、口径偏差与官方自陈的局限
这一节是本文最想强调的部分——官方在正文与一周后的更新(2025-03-20)里亲口承认的三件事:
- “开源”的口径要打折。博客称”UI extension is also open source”,并链接
duckdb/duckdb-ui仓库。但紧接着一句:仓库不包含前端源码(HTML/JS),前端目前未开源,是否开源”正在考虑中”。也就是说,你能看到后端扩展如何起 HTTP 服务、如何接线,却看不到界面本身的实现。 - 离线(air-gapped)环境首发不支持。官方在更新中明说正在努力支持离线使用,难点在于如何做版本升级通知——即发布时 UI 仍然依赖网络做扩展下载与版本检查。
- 客户端-服务端协议首发不开放。官方承诺后续开放协议,让第三方 UI 也能复用”后端那部分”;发布当下,这个 localhost API 是 DuckDB UI 专用的。
此外,MotherDuck 云集成是显式 opt-in:官方反复强调”你的查询和数据永不离开本机”,但同时把”Sign in to MotherDuck”按钮放在右上角——这是商业公司(MotherDuck 是 DuckDB Labs 的商业化实体)做开源产品时常见的取舍,理解即可,不必过度解读。
六、优势与局限
优势:
- 零配置:v1.2.1 起一条命令起界面,消灭了”挑 GUI”的决策成本;
- 真本地:直连进程内实例,数据不出本机,比把本地文件导到外部 GUI 工具少一道数据复制;
- 列画像开箱即用:直方图与分位数对快速摸数据分布非常顺手,省去手写
approx_count_distinct等探查 SQL; - Notebook 可持久化:工作成果存在
ui.db,下次打开还在。
局限:
- 前端闭源,审计/二次开发界面无从下手;
- 不支持离线环境(首发);
- 无协作者、无云端分享(除非登录 MotherDuck);
- 无性能基准,“快”只能信工程直觉;
- 功能仍在快速迭代,官方原文即”The DuckDB UI is under active development”。
七、谁该关注
- DuckDB 现有用户:日常在 CLI / Python 里摸数的人,升级到 v1.2.1 后值得花十分钟试一下列探查器,尤其做数据清洗前置检查时;
- 教学与演示场景:本地 Notebook 形态适合课堂讲 DuckDB、讲 SQL;
- 对”完全开源”敏感的团队:如果合规要求 UI 层也可审计,需等前端开源或继续用第三方 GUI;
- 重度云端数仓用户:该 UI 定位是本地工具,不是 BI 平台,别拿它替代 Superset/Looker。