Dream 7B:港大与华为诺亚把扩散语言模型做到新量级
阅读时间: 大约 10 分钟
Dream 7B:港大与华为诺亚把扩散语言模型做到新量级
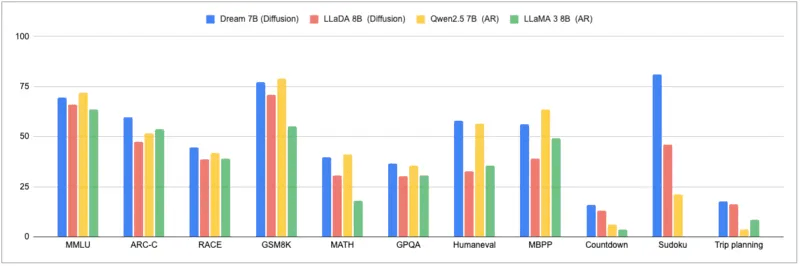
当 GPT-4、DeepSeek、Claude 几乎清一色采用「从左到右逐 token 生成」的自回归(AR)架构时,香港大学 NLP 团队联合华为诺亚方舟实验室,在 2025 年 4 月 2 日发布了 Dream 7B——一个基于离散扩散(discrete diffusion)的开源推理语言模型,并自称是「迄今为止最强的开源扩散大语言模型」。它的意义不只在于又一个 7B 权重,而在于给「AR 之外的下一代架构」提供了一个可复现、可下载的大规模样本。本文基于其官方博客与披露的评测表做一次系统梳理。
一、为什么要用扩散来生成文本
自回归模型逐 token 左到右生成,在规模化后暴露出一些固有短板:复杂推理、长程规划、长上下文一致性,这些在具身智能、自主 Agent、长时序决策系统中尤为关键。离散扩散模型则走了一条完全不同的路:从「全序列被噪声覆盖」的状态出发,并行地、迭代地去噪、精整整段序列。
官方把这条路的优势概括为三点:双向上下文建模(信息双向流动,全局一致性更好)、天然的可控生成(迭代精整带来灵活的生成顺序控制)、以及潜在的采样加速(可直接从噪声映射到数据)。此前 DiffuLLaMA、LLaDA 已把扩散语言模型推到 7B 量级,Dream 7B 正是在这条线上的继续放大。
二、训练配方:站在 AR 模型的肩膀上
Dream 7B 采用 mask diffusion(掩码扩散)范式,但它有两个让训练得以稳定放大的关键设计:
- AR 权重初始化:团队在 1B 规模上实验发现,用已有 AR 模型(Qwen2.5、LLaMA3)的权重做初始化,比从零训练扩散模型更有效——尤其在训练早期。Dream 7B 最终用 Qwen2.5 7B 的权重初始化,并精挑学习率:太高会把初始权重里的「从左到右」知识冲掉,太低又妨碍扩散训练。
- 上下文自适应的 token 级噪声重调度(context-adaptive token-level noise rescheduling):传统离散扩散在句子级采样一个时间步 t 决定噪声强度,但真正的学习发生在 token 级。Dream 会按每个被掩码 token 所蕴含的上下文信息量,重新为它分配一个 token 级时间步,给不同难易程度的 token 更精细的学习指导。
训练数据覆盖文本、数学与代码,主要来自 Dolma v1.7、OpenCoder、DCLM-Baseline,经清洗后合计 5800 亿(580B)token 预训练。据 Koala 项目库记载,预训练使用了 96 台 NVIDIA H800 GPU、约 256 小时。后训练方面,团队从 Tulu 3 与 SmolLM2 中整理了 180 万对(1.8M) 数据,做了 3 个 epoch 的监督微调(SFT)。权重已开源:Base 模型 Dream-org/Dream-v0-Base-7B,SFT 模型 Dream-org/Dream-v0-Instruct-7B。
三、关键评测:扩散模型里最强,但通用仍略逊 Qwen2.5-7B
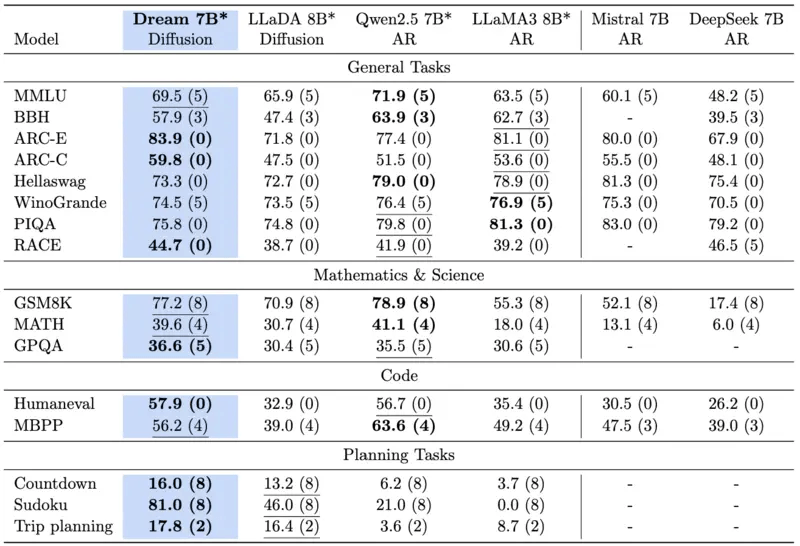
官方评测表把 Dream 7B(扩散)与 LLaDA 8B(扩散)、Qwen2.5 7B(AR)、LLaMA3 8B(AR)放在同一协议下对比,关键数字摘录如下:
| 基准 | Dream 7B(扩散) | LLaDA 8B(扩散) | Qwen2.5 7B(AR) | LLaMA3 8B(AR) |
|---|---|---|---|---|
| MMLU | 69.5 | 65.9 | 71.9 | 63.5 |
| GSM8K | 77.2 | 70.9 | 78.9 | 55.3 |
| MATH | 39.6 | 30.7 | 41.1 | 18.0 |
| GPQA | 36.6 | 30.4 | 35.5 | 30.6 |
| HumanEval | 57.9 | 32.9 | 56.7 | 35.4 |
| MBPP | 56.2 | 39.0 | 63.6 | 49.2 |
| Countdown | 16.0 | 13.2 | 6.2 | 3.7 |
| Sudoku | 81.0 | 46.0 | 21.0 | 0.0 |
| Trip planning | 17.8 | 16.4 | 3.6 | 8.7 |
这张表传递的信息必须准确理解,不能只看「扩散最强」的宣传语:
- 对同类扩散模型是碾压级:Dream 在几乎所有项目上大幅领先 LLaDA 8B;
- 对同量级 AR 模型是「各有胜负、总体略逊」:在 MMLU、GSM8K、MATH、MBPP 上,Dream 都排在 Qwen2.5 7B 之后(第二位),只是在 GPQA、HumanEval 上反超;
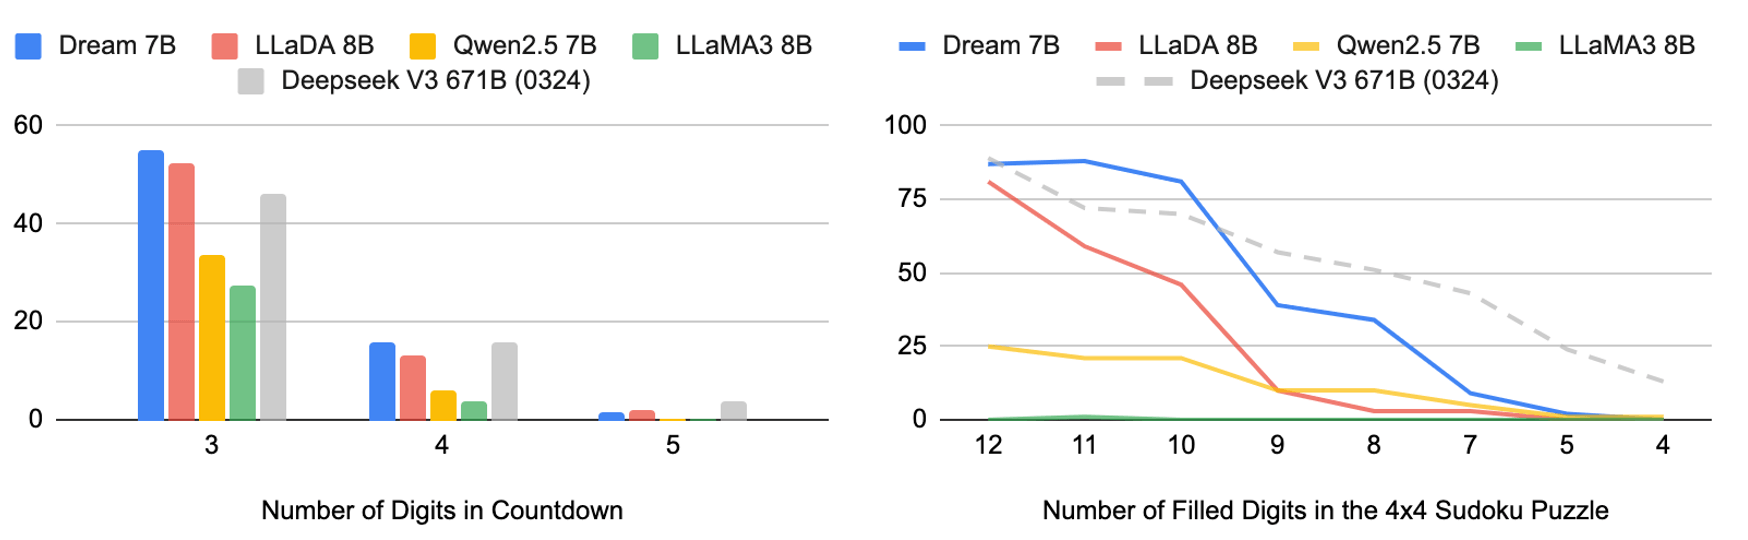
- 真正拉开差距的是规划类任务:Countdown、Sudoku、Trip planning 这三项多约束 / 目标导向任务上,Dream 显著领先所有同量级 AR 模型。官方还提到,在这些任务上扩散模型有时甚至能超过参数量大几个数量级的 DeepSeek V3 671B(0324)。
四、评测方法的偏向要说清楚
需要指出,上述规划任务评测采用的是 few-shot、且未在这些任务上做任何专门训练 的设置——这对扩散模型是「扬长」的赛制:Countdown(用给定数字凑目标算式)、Sudoku(填数独)本质上是「给定约束、求满足」的问题,恰好命中扩散并行去噪、双向推理的甜区。把同一套任务搬到开放式写作、长文档理解上,扩散模型的优势未必成立。换句话说,Dream 7B 证明的是「扩散架构在规划类问题上有结构性优势」,而不是「扩散模型全面超越 AR」。
此外,官方也承认后训练(post-training)配方目前还只是「初步探索」——180 万对数据、3 epoch SFT 远不如主流 AR 模型成熟的 RLHF/RLVR 体系完善。因此它在指令遵循、对话体验上与顶尖 AR Instruct 模型仍有差距。
五、扩散带来的独有灵活性
Dream 7B 展示了 AR 架构给不了的几种推理时能力:
- 任意顺序生成:不必从左到右,可以做补全(completion)、也可以做「给定结尾句的填空(infilling)」;
- 解码行为可控:调节超参数,可以在「更像 AR 的从左到右」到「完全随机顺序」之间连续切换;
- 质量-速度可调:每步生成的 token 数由扩散步数控制——步数少、快但粗,步数多、慢但精。这给了推理时一个额外的扩展维度,与 o1 / r1 这类「长思维链」互补而非替代。
六、适用与不适用
值得关注:
- 研究人员:这是目前少有的、可下载权重的大规模扩散 LLM,是研究「AR 之外架构」的现成实验台;
- 多约束规划 / 约束求解类 Agent(数独式、算式凑数式、行程规划):扩散架构在此类问题上有结构性优势;
- 需要 infilling、任意顺序生成的写作 / 代码补全场景。
暂不适合直接投产:
- 追求开箱即用对话体验的产品——后训练成熟度不足;
- 通用知识问答、长文本生成——同价位 Qwen2.5-7B 这类成熟 AR 模型在 MMLU/GSM8K 上仍略优;
- 对推理延迟敏感的在线服务——扩散需要多步去噪,单步并行但总步数带来的时延特征与 AR 不同。
七、客观分析:优势与局限
优势: 在扩散语言模型这条线里做到了当前开源最强;AR 初始化 + token 级噪声重调度的训练配方可复现、可借鉴;规划类任务对同量级 AR 形成明显优势;权重与代码完全开放。
局限: 通用与数学能力总体仍略逊于成熟的同量级 AR 模型(如 Qwen2.5 7B);后训练体系(SFT 数据量、无 RL)尚浅;推理时步数-质量的权衡需要工程调参;作为 2025 年 4 月发布的研究模型,生态与工具链远不及主流 AR 模型完善。