DiceDB:从 Go 自研引擎到 Valkey 分支,一家内存数据库的转向
阅读时间: 大约 9 分钟
DiceDB:从 Go 自研引擎到 Valkey 分支,一家内存数据库的转向
DiceDB 在科技周报里常被一句话带过:“Go 写的响应式内存数据库,比 Redis 快”。但只要翻开它现在的官网与 GitHub README,就会发现这个描述已经过时——DiceDB 当前的代码库是 Valkey(Redis 的社区分叉)的一个 C 语言分支,那个”Go 自研、主打响应式与更高吞吐”的原始引擎已经被官方归档为 dice-legacy。本文基于 dicedb.io 官方文档与 dicedb/dice README,厘清它现在到底是什么、靠什么差异化,以及哪些历史宣传不能再当真。
一、它现在是什么
官方文档(“What is DiceDB?”)的定义是:一个快速、高性能的数据结构服务器,带查询订阅(query subscriptions)与分层存储(tiered storage)。它直接 fork 自 Valkey,而 Valkey 本身又是 Redis 的分叉,因此 DiceDB 对外完全兼容 Redis/Valkey 生态:
- 兼容所有语言的 Redis/Valkey SDK 与客户端;
- 兼容 Redis 命令与数据结构(string、hash、list、set、sorted set、HyperLogLog 等);
- 兼容现有 Redis 的部署与运维模式;
- 协议端口仍为默认 6379,
dicedb-cli与redis-cli用法一致(ping/set/get/incr)。
授权为 BSD-3-Clause。官方坦言:因为架构直接建立在 Valkey 之上,日志、监控指标、代码库里你仍会看到大量 Valkey 字样——这不是没改干净,而是它本来就是 Valkey 的超集。
二、两大差异化能力
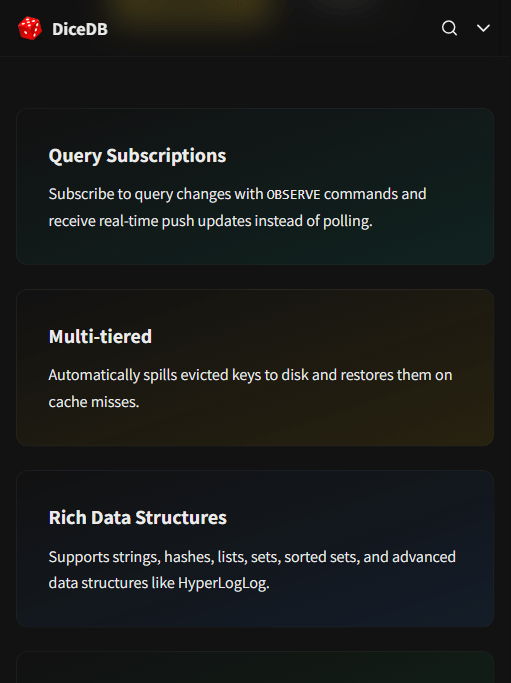
在 Redis 兼容基线之上,DiceDB 目前真正额外做的事情有两件:
| 能力 | 机制 | 解决的问题 |
|---|---|---|
| dicedb-spill(磁盘溢出) | 被 LRU 淘汰的 key 自动持久化到磁盘(RocksDB),缓存未命中时再透明加载回内存 | 固定内存预算下塞下比 RAM 更大的工作集 |
| OBSERVE 查询订阅 | 客户端用 OBSERVE 命令订阅一条查询,结果集一变就实时推送,无需轮询 | 实时应用(看板、游戏状态)省去反复 polling |
spill 的默认配置很说明问题:官方 Docker 镜像 dicedb/dicedb 默认就启用 spill 模块,后端 RocksDB,最大内存上限 250MB。你也可以显式覆盖——README 给的定制例子是 --maxmemory 500mb,同时 spill 内存阈值 250MB。也就是说,DiceDB 想讲的故事是:热数据留在内存、冷数据沉到 RocksDB,应用代码零改动,把”Redis 内存不够”这个老问题变成一个配置项。
OBSERVE 则是它从 Go 老引擎继承下来的灵魂:传统 Pub/Sub 是”发消息”,而 OBSERVE 是”订阅一条查询,结果变了才推”——更接近数据库视角的 reactivity,而不是消息队列视角。
三、怎么跑起来
最短路径是 Docker:
docker run --name dicedb-001 -p 6379:6379 -v $(pwd)/data:/data/ dicedb/dicedb起来后 docker exec -it dicedb-001 dicedb-cli 即可交互。从源码构建支持 Linux、macOS、OpenBSD、NetBSD、FreeBSD,大小端、32/64 位都在支持矩阵里——这一长串操作系统名单是从 Valkey 继承来的移植性承诺,不是 DiceDB 自己新做的。
四、评测方法批判与口径偏差
这一节必须写重一点,因为 DiceDB 的历史宣传和现状之间存在结构性口径偏差:
- “Go 自研、更高吞吐”是 archived 引擎的故事,不是现在的代码库。README 原文:“DiceDB originally started as a Golang-based storage engine and offered reactivity and higher throughput as its core offering. That implementation is now archived: dice-legacy.” 网上但凡能搜到的”DiceDB 1.5M QPS、比 Redis 快多少”之类对比图,测的都是那个已经归档的 Go 实现,不能套用到现在这个 Valkey(C) 分支上。当前 fork 的性能基线就是 Valkey 的基线,DiceDB 自己也没在新文档里给出任何吞吐/时延数字。
- 官网首页仍写”low-latency”,但无 benchmark。这是一句定位口号,不是实测结论;真正决定延迟的是它基于的 Valkey 版本与 spill 是否命中磁盘。
- “in-memory performance for hot data”有前提:spill 只对热数据保内存速度;一旦命中被溢出到 RocksDB 的冷 key,这次读要走磁盘,尾延迟必然高于纯内存。官方没给磁盘层的 P99 数字。
- 响应式特性仍在”移植中”。文档明说 legacy 引擎的特性会”gradually ported into the current codebase”——也就是说,老 Go 引擎上你听说过的那套 reactivity 语义,在新 fork 里未必 1:1 都在,用之前要核对当前
OBSERVE文档。 - thin fork 的维护风险:一个直接 fork Valkey 的项目,其长期价值取决于它能否把 spill / OBSERVE 做成上游不愿收、自己又能持续维护的差异化层;否则它只是 Valkey 上挂了个 RocksDB 模块。
五、优势与局限
优势:
- 零迁移成本:Redis 客户端、工具、运维经验全复用,
-p 6379起一个就能接; - 内存超配:spill 让固定 RAM 跑更大工作集,对缓存成本优化是实打实的;
- 订阅式推送:OBSERVE 对实时看板/协同场景比轮询省请求;
- BSD 开源,可商用。
局限:
- 差异化特性(spill / OBSERVE)相对 Redis 的成熟生态仍是单点实验;
- 冷数据读延迟依赖 RocksDB 磁盘,无公开尾延迟数据;
- 文档与代码大量继承 Valkey,排查问题时要在两套文档间跳;
- 历史营销口径混乱,选型时必须以当前 Valkey fork 的文档为准。
六、谁该关注
- 缓存场景但内存预算紧张的团队:spill 模块正好打”工作集大于 RAM”的痛点;
- 想上 reactivity 但不想离开 Redis 生态的人:OBSERVE 是比轮询更优雅的方向,但请先在当前版本里验证命令完整度;
- 被历史文章种草”DiceDB 比 Redis 快三倍”的人:先冷静——那是归档引擎的数字,当前 fork 请自己压测;
- 想要强一致持久化数据库的人:别找错门,它仍是内存优先的 KV,不是 SQLite/PostgreSQL 的替代品。