DeepSeek-V4.1-Flash-1017:一次"更短、更快、更省"的小版本更新,与 DeepSeek 开放的 Search/Fetch 基础设施
阅读时间: 大约 16 分钟
DeepSeek-V4.1-Flash-1017:一次”更短、更快、更省”的小版本更新,与 DeepSeek 开放的 Search/Fetch 基础设施
在首篇 V4.1-Flash 分析(2026 年 9 月 10 日发布的基础版本)之后,DeepSeek 又以一个”小版本号”的形式放出了 DeepSeek-V4.1-Flash-1017:权重以 MIT 协议登上 Hugging Face,官网、App 与 API 同步更新,调用方式与价格均未改变。表面看这只是一次 patch,但模型卡披露的基准变化、输出长度收缩,以及同期开放的自研 Search/Fetch 接口,才是这次更新真正值得拆开看的部分。本文基于 Hugging Face 模型卡与 DeepSeek 官方 API 文档做一手分析,区分”官方称”与”可核对事实”。
一、背景:为什么要做一个”1017”小版本
V4.1-Flash 首发主打新架构(552B MoE、输入激活 8B / 输出激活 16B、原生多模态、1M 上下文)与地板价 API。但在 Agent 真实工作流里,“分数涨了”不等于”账单降了”:Agent 每完成一个任务要多轮调用,输出 token 直接计费,冗长的推理链与重复解释会把单价优势吃掉。
1017 的官方定位(模型卡原文)是:a minor update to DeepSeek-V4.1-Flash, delivering substantial improvements across reasoning, coding, agentic tasks, and visual benchmarks;同时 reduces task execution time and output length,advancing the performance–cost Pareto frontier across multiple agent harnesses。即:不是换架构,而是在同一个权重底座上,用带自我反馈的强化学习把”从零开发完整项目”这类 Agent 任务的完成质量抬上去,同时把任务耗时和输出长度压下来。
二、模型本身:参数、上下文与采样口径
模型卡可核对的工程事实:
- 模型规模 763B 参数(Safetensors,FP8 等多种精度),与首发版同属 V4.1-Flash 家族,并非新架构;
- 上下文窗口 1M tokens,模型卡推荐
max_tokens ≥ 256K; - 推荐采样参数:
temperature 1.0、top_p 1.0; - 许可证 MIT,权重可自由商用与二次开发;
- 本版本未提供 Jinja 格式 chat template:模型卡
encoding目录附带自包含 Python 参考实现encoding.py(覆盖多轮对话、工具调用、思考模式、数值推理强度、对话中途插入 system 消息、图文交错),生产环境可使用官方配套的deepseek-recipe(Rust 库 + Python 绑定)做协议转换。
最后这一点容易被忽略:没有现成 chat template 意味着自行接入的开发者必须自己按 encoding.py 拼 prompt,否则工具调用与思考模式可能跑偏。
三、基准数据:涨在哪里,又输在哪里
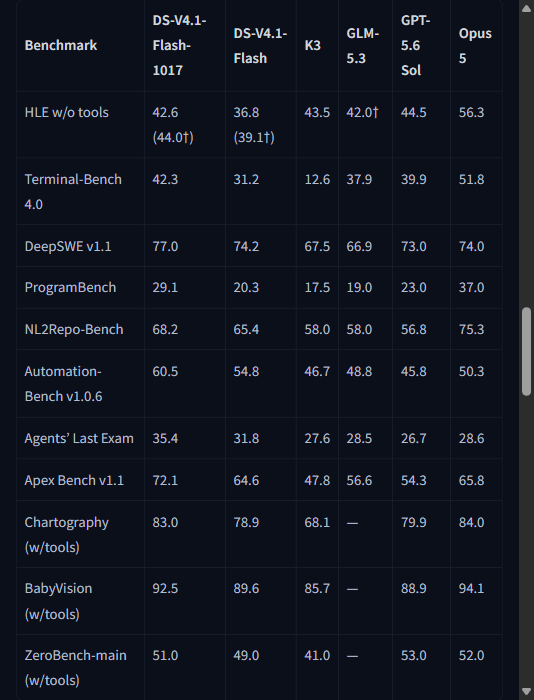
模型卡给出 1017 与首发 V4.1-Flash、K3、GLM-5.3、GPT-5.6 Sol、Opus 5 的同表对比(官方数据,非第三方复测):
| 基准 | V4.1-Flash-1017 | V4.1-Flash | K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE w/o tools | 42.6(44.0†) | 36.8(39.1†) | 43.5 | 42.0† | 44.5 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 12.6 | 37.9 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 67.5 | 66.9 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 17.5 | 19.0 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 58.0 | 58.0 | 56.8 | 75.3 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 46.7 | 48.8 | 45.8 | 50.3 |
| Agents’ Last Exam | 35.4 | 31.8 | 27.6 | 28.5 | 26.7 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 47.8 | 56.6 | 54.3 | 65.8 |
| Chartography(w/tools) | 83.0 | 78.9 | 68.1 | — | 79.9 | 84.0 |
| BabyVision(w/tools) | 92.5 | 89.6 | 85.7 | — | 88.9 | 94.1 |
| ZeroBench-main(w/tools) | 51.0 | 49.0 | 41.0 | — | 53.0 | 52.0 |
读这张表要分三层:
- 相对自家首发版全线上升:11 个基准没有一项回落,Agent 类提升最明显——Terminal-Bench 4.0 从 31.2 到 42.3(+11.1)、ProgramBench 从 20.3 到 29.1(+8.8)、Automation-Bench 从 54.8 到 60.5、Apex Bench 从 64.6 到 72.1。
- 横向对比有胜负,不是全场领先:Terminal-Bench 4.0 上 Opus 5 为 51.8,仍高于 1017 的 42.3;HLE(无工具)Opus 5 为 56.3,1017 为 42.6;NL2Repo-Bench Opus 5 为 75.3,1017 为 68.2。视觉类 BabyVision、Chartography 上 Opus 5 也略高。
- Agent 基准反超部分闭源模型:Automation-Bench 60.5 高于 Opus 5 的 50.3 与 GPT-5.6 Sol 的 45.8;Agents’ Last Exam 35.4 为全表最高;DeepSWE v1.1 的 77.0 高于 Opus 5 的 74.0 与 GPT-5.6 Sol 的 73.0。
四、评测口径批判:分数离开 harness 就不能直接比
模型卡脚注明确标注了两条口径,读分时必须带上:
†表示 HLE 的纯文本子集(text-only subset),44.0 与 39.1 是该子集分数,与 42.6 / 36.8 的全量口径不是同一把尺子;- Terminal-Bench 4.0 使用 Claude Code harness 测得,DeepSWE v1.1 使用 Mini-SWE-V2 harness 测得。
这意味着:同一模型在不同 Agent 框架(系统提示、工具集、重试策略、预算上限都不同)下分数会显著漂移,42.3 是”在 Claude Code 框架里跑出来的 Terminal-Bench 成绩”,不能直接等同于任意终端 Agent 里的表现;第三方若换 harness 复测,数值可能明显不同。此外表中 GLM-5.3 在 Chartography/BabyVision/ZeroBench 上为”—“(未提供数据),并非零分。
五、真正的新东西:自研 Search / Fetch API 对外开放
与模型更新同期,DeepSeek 开放了自研搜索引擎的两个原始 JSON 接口(官方 API 文档):
| API | Endpoint | 作用 |
|---|---|---|
| Search | POST https://api.deepseek.com/v1/tools/search | 按 query 搜索网页,返回结构化结果 |
| Fetch | POST https://api.deepseek.com/v1/tools/fetch | 抓取单个网页,以 Markdown 文本返回 |
两者使用与 DeepSeek API 相同的 Bearer 鉴权。Search 请求字段包括 query(1~128 个 Unicode 字符)、count(1~50,默认 10)、ori_question(原始用户问题,辅助意图理解)、localization(按 IP 本地化)、need_content(是否回传网页正文,默认 false)。响应每条结果含 rerank_score(0~3,≥1.5 为优质)、title、url、snippet(约 100~200 字符短摘要)、summary(约 600~800 字符长摘要,供模型阅读)、content、site_name、site_icon、date、authority(0~4,≥3 为极权威)。
Search 还支持操作符语法:site:、-site:、-(排除关键词)、-"..."(排除短语)、"..."(精确短语)、lang:、after:、before:,可在一个 query 内组合。Fetch 请求仅需 url(≤8192 字符,必须含 host 的 HTTP/HTTPS,不能带用户名密码),返回 title 与 Markdown content。
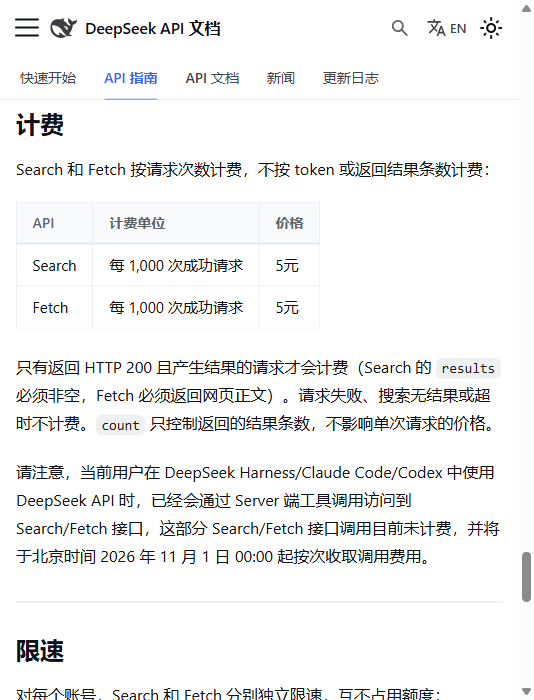
定价(官方文档口径,人民币):Search 与 Fetch 均为 每 1,000 次成功请求 5 元,按请求次数计费,不按 token、不按返回条数。只有返回 HTTP 200 且产生结果才计费(Search 的 results 必须非空,Fetch 必须返回正文);请求失败、搜索无结果、超时均不计费,count 不影响单价。限速上,Search 为 100 QPS、Fetch 为 25 QPS(账号粒度,与模型并发独立;Fetch 另有目标域名级 QPS 限制)。
这里需要修正一处二手口径:Koala 项目库条目称”每千次调用 0.75 美元”,而官方文档以人民币计价为 5 元/千次,0.75 美元更像是折算后的约数,正式报价应以官方人民币价为准。
官方自己标注的隐藏节点:当前用户在 DeepSeek Harness / Claude Code / Codex 中使用 DeepSeek API 时,已通过 Server 端工具调用间接访问 Search/Fetch,这部分调用目前未计费,并将于北京时间 2026 年 11 月 1 日 00:00 起按次收费。已把联网检索内建进工作流的团队,需要在这个日期前后重新核算成本。
六、客观分析:优势与局限
优势:
- 同架构内的帕累托改进:11 项基准全线上扬的同时压缩任务耗时与输出长度,Agent 场景下”输出更短 = 账单实打实下降”,这比单纯刷榜更贴近生产;
- Agent 工作流外溢能力强:Automation-Bench、Agents’ Last Exam、DeepSWE 三项反超表中部分闭源模型,适合多轮工具调用型任务;
- 搜索基础设施补位:Search/Fetch 把联网检索做成按次计费的独立 API,提供结构化摘要、权威性打分与操作符语法,Agent 与 RAG 团队不必再集成 Exa、Tavily 等第三方;
- MIT 开源 + 计价透明:权重开放,接口只对成功结果收费,失败不计费的口径对调试期友好。
局限:
- 顶级推理仍有差距:HLE、Terminal-Bench、NL2Repo-Bench 上 Opus 5 仍领先数个到十几个百分点,追求推理上限的任务不能只看 1017;
- harness 依赖性强:官方分数绑定 Claude Code / Mini-SWE-V2 框架,换框架复测可能明显回落,选型时应以自己的 Agent 框架实测为准;
- 无 Jinja chat template:自部署与第三方框架接入需要额外做 prompt 编码适配;
- 搜索计费存在切换点:2026-11-01 起 Harness/Claude Code/Codex 内建调用转为按次收费,存量成本模型会变;Fetch 25 QPS 且带域名级限速,大规模抓取要评估吞吐。
七、谁该关注
- 跑 Agent / 自动化工作流的团队:1017 的短输出现金流效应直接体现在月账单上,值得在自有 harness 里 A/B 复测;
- 需要联网检索的 RAG / Agent 产品:可以把 Search/Fetch 作为独立检索层评估,重点对比摘要质量与权威分排序;
- 自部署用户:注意自行实现 chat template,763B FP8 的显存门槛仍然不低;
- 追求闭源旗舰推理上限者:HLE、长仓库构建类任务仍建议与 Opus 5 等对比后再定。