DeepSeek 大模型的分析
阅读时间: 大约 10 分钟
DeepSeek 大模型的分析
DeepSeek(深度求索)是过去两年全球开源大模型领域最具冲击力的玩家之一:从 V3 系列的价格屠夫式定价,到 V4 系列把百万 Token 上下文做到白菜价,再到 2026 年 9 月 10 日发布的最新 V4.1-Flash,它始终在用”顶级性能 + 行业地板价 + 完全开源”的组合拳重塑市场格局。本文基于 DeepSeek 官方公告、API 文档与公开评测,对 DeepSeek 大模型做一次系统分析。
一、发展脉络:V4 → V4.1
- 2026 年 4 月:DeepSeek-V4 预览版发布并同步开源,主打”可负担的百万 Token 上下文”,纯文本模型;
- 2026 年 7 月 31 日:DeepSeek-V4-Flash 正式版(0731)上线,性能对标预览版 Pro;
- 2026 年 8 月 13 日:DeepSeek-V4-Pro 正式版(0813)上线,百万上下文旗舰进入 GA 时代;
- 2026 年 9 月 10 日:DeepSeek-V4.1-Flash 发布——新架构家族的第一个模型,原生支持多模态视觉理解,多项评测超越 V4-Pro,同时大幅下调 API 价格。
也就是说,DeepSeek 的迭代节奏已经从”半年一个大版本”加快到”一个月一个正式版”,并且始终保持边发布、边开源。
二、V4.1-Flash:新架构,更聪明更便宜
V4.1-Flash 的核心亮点(官方数据):
- 552B 参数 MoE,采用新的 Causal Encoder–Decoder 非对称架构:输入仅激活 8B 参数、输出激活 16B 参数;
- 原生多模态:首个支持视觉理解的主流 V4 系列模型(V4 基础版为纯文本);
- 上下文 1M(约 75 万字),最大输出 384K;
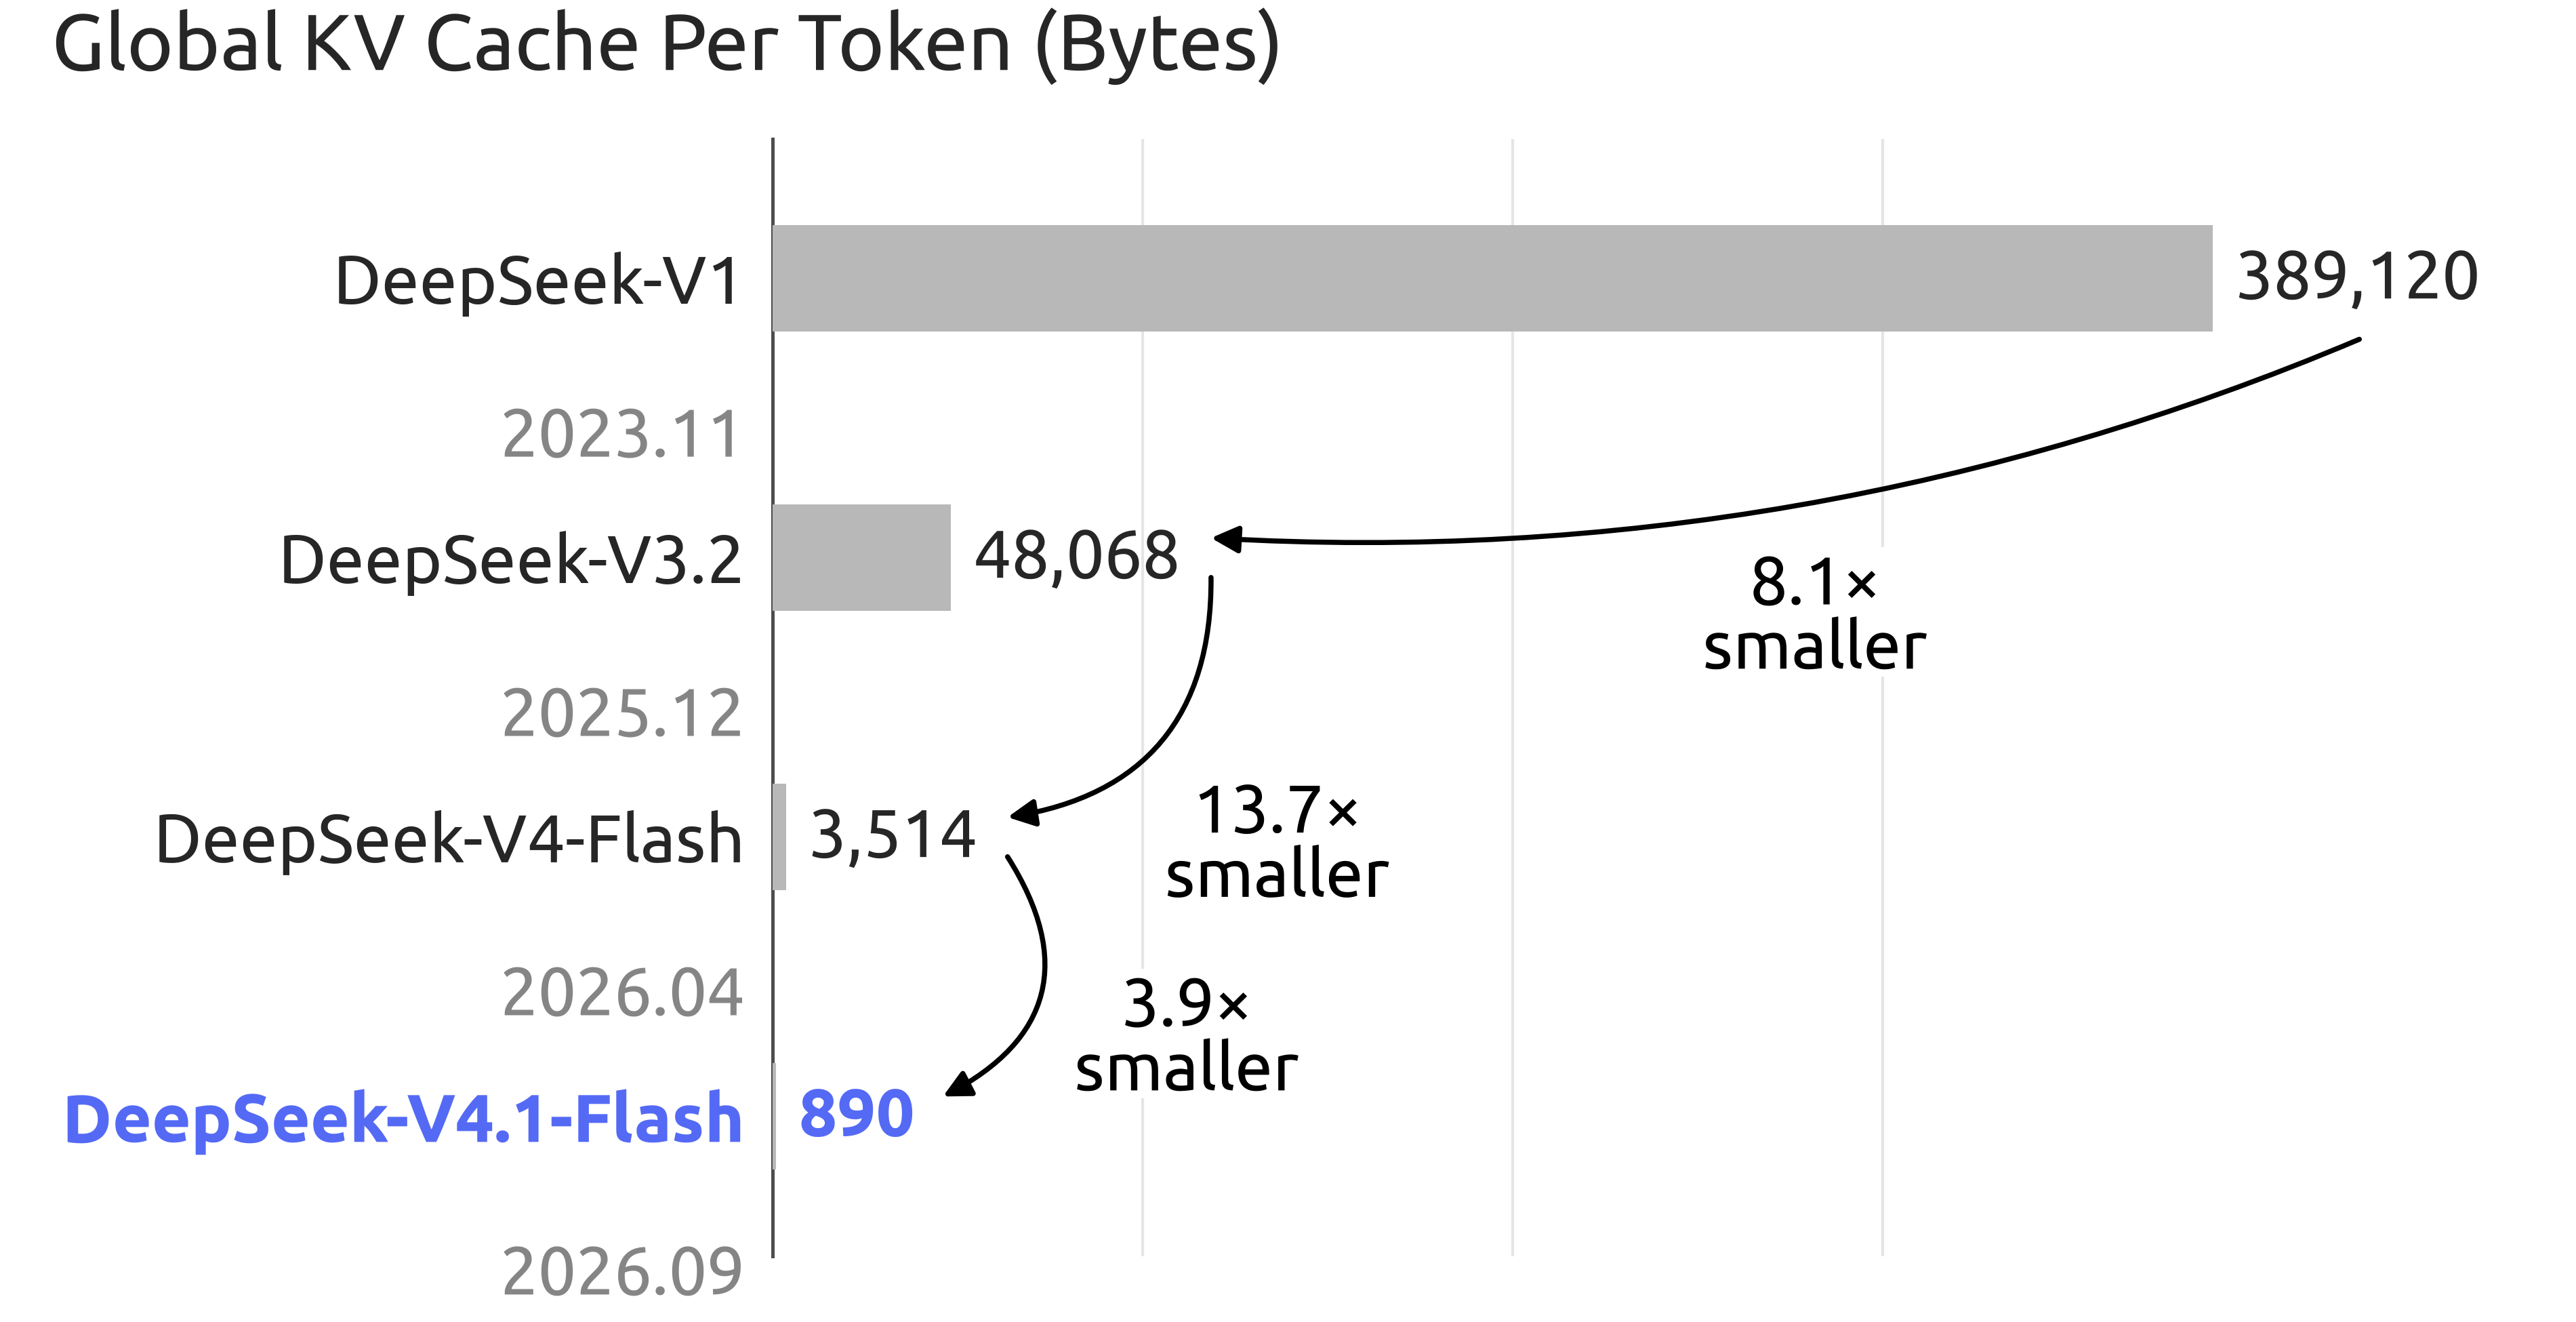
- KV 缓存大幅压缩:相比前代,HBM 占用降至 1/4、SSD 存储降至 1/8,全局每 Token KV 缓存从 V1 的 389,120 字节一路降到 V4.1-Flash 的 890 字节(约 437 倍压缩);
- 权重 MIT 协议完全开源,社区可自由二次开发与商业化。
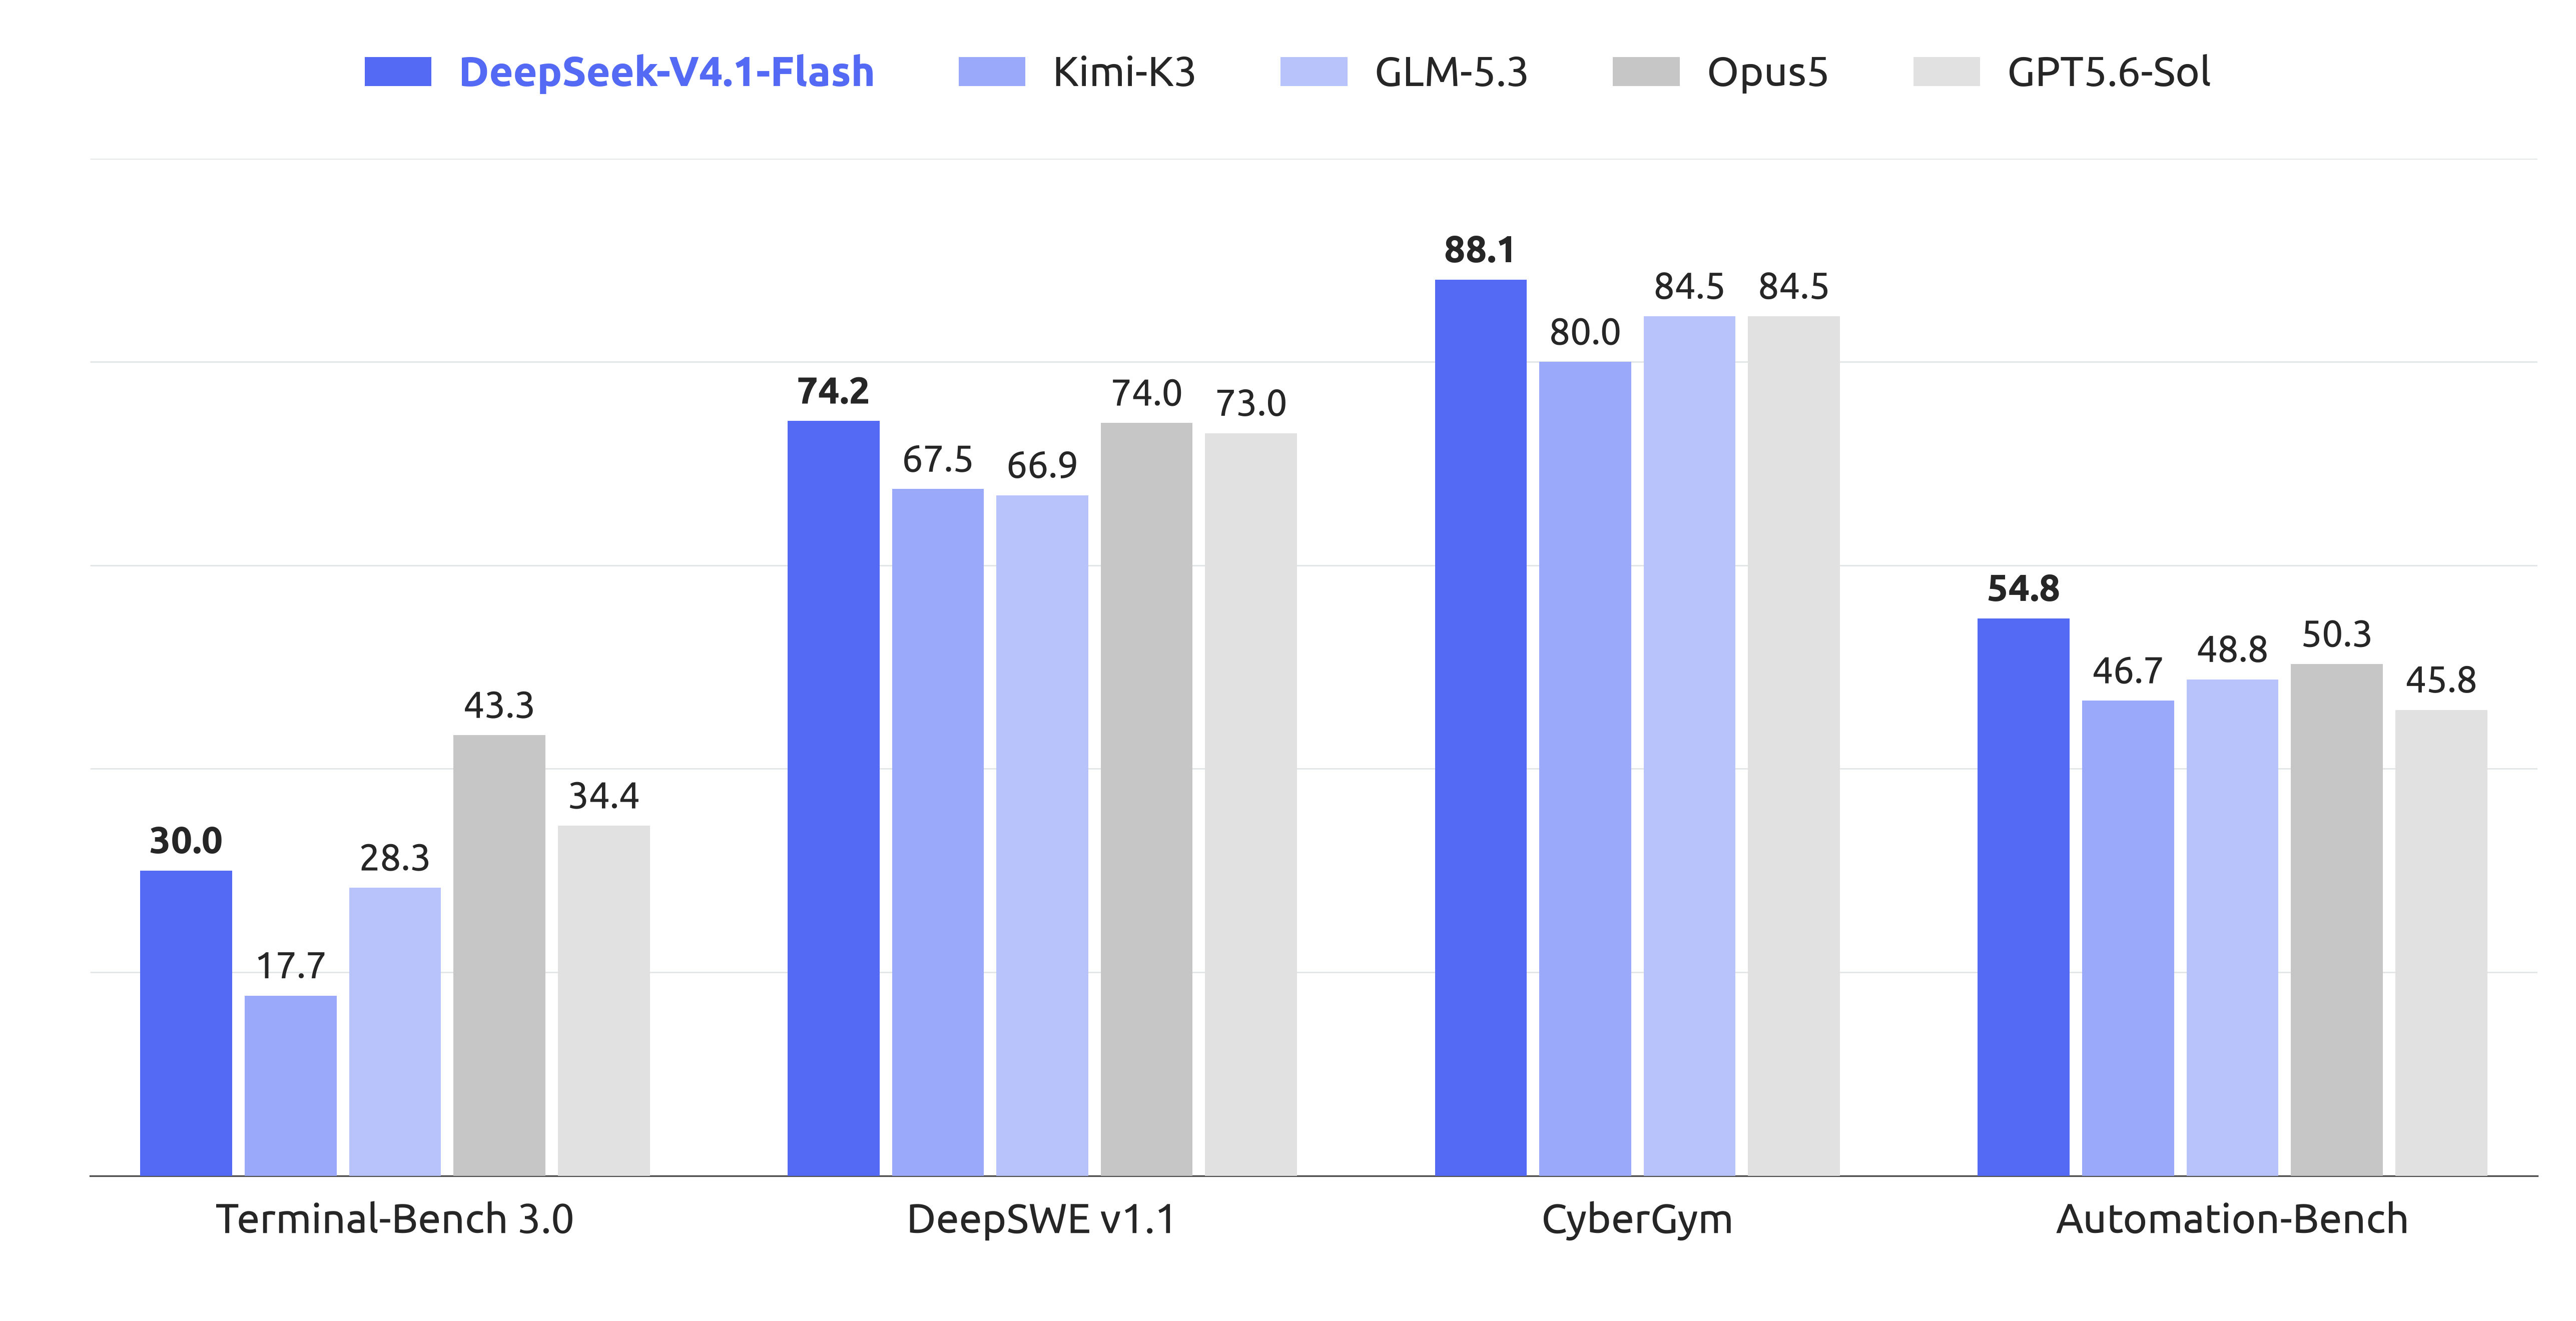
在官方公布的基准中,V4.1-Flash 在多类任务上超过了自家旗舰 V4-Pro,并在与 GPT-5.6 Sol、Claude Opus 5、GLM 5.3、Kimi K3 的同场对比中各有胜负:Codeforces 评分 3471(全场最高)、CyberGym 88.1(全场最高)、Automation-Bench 54.8(领先 GPT-5.6 Sol 的 45.8)、DeepSWE v1.1 74.2(与 Opus 5 并列)——而在 GPQA Diamond、HLE 等纯知识推理类基准上仍略逊于 GPT-5.6 Sol 与 Claude Opus 5。
三、API 定价:行业地板价再刷新
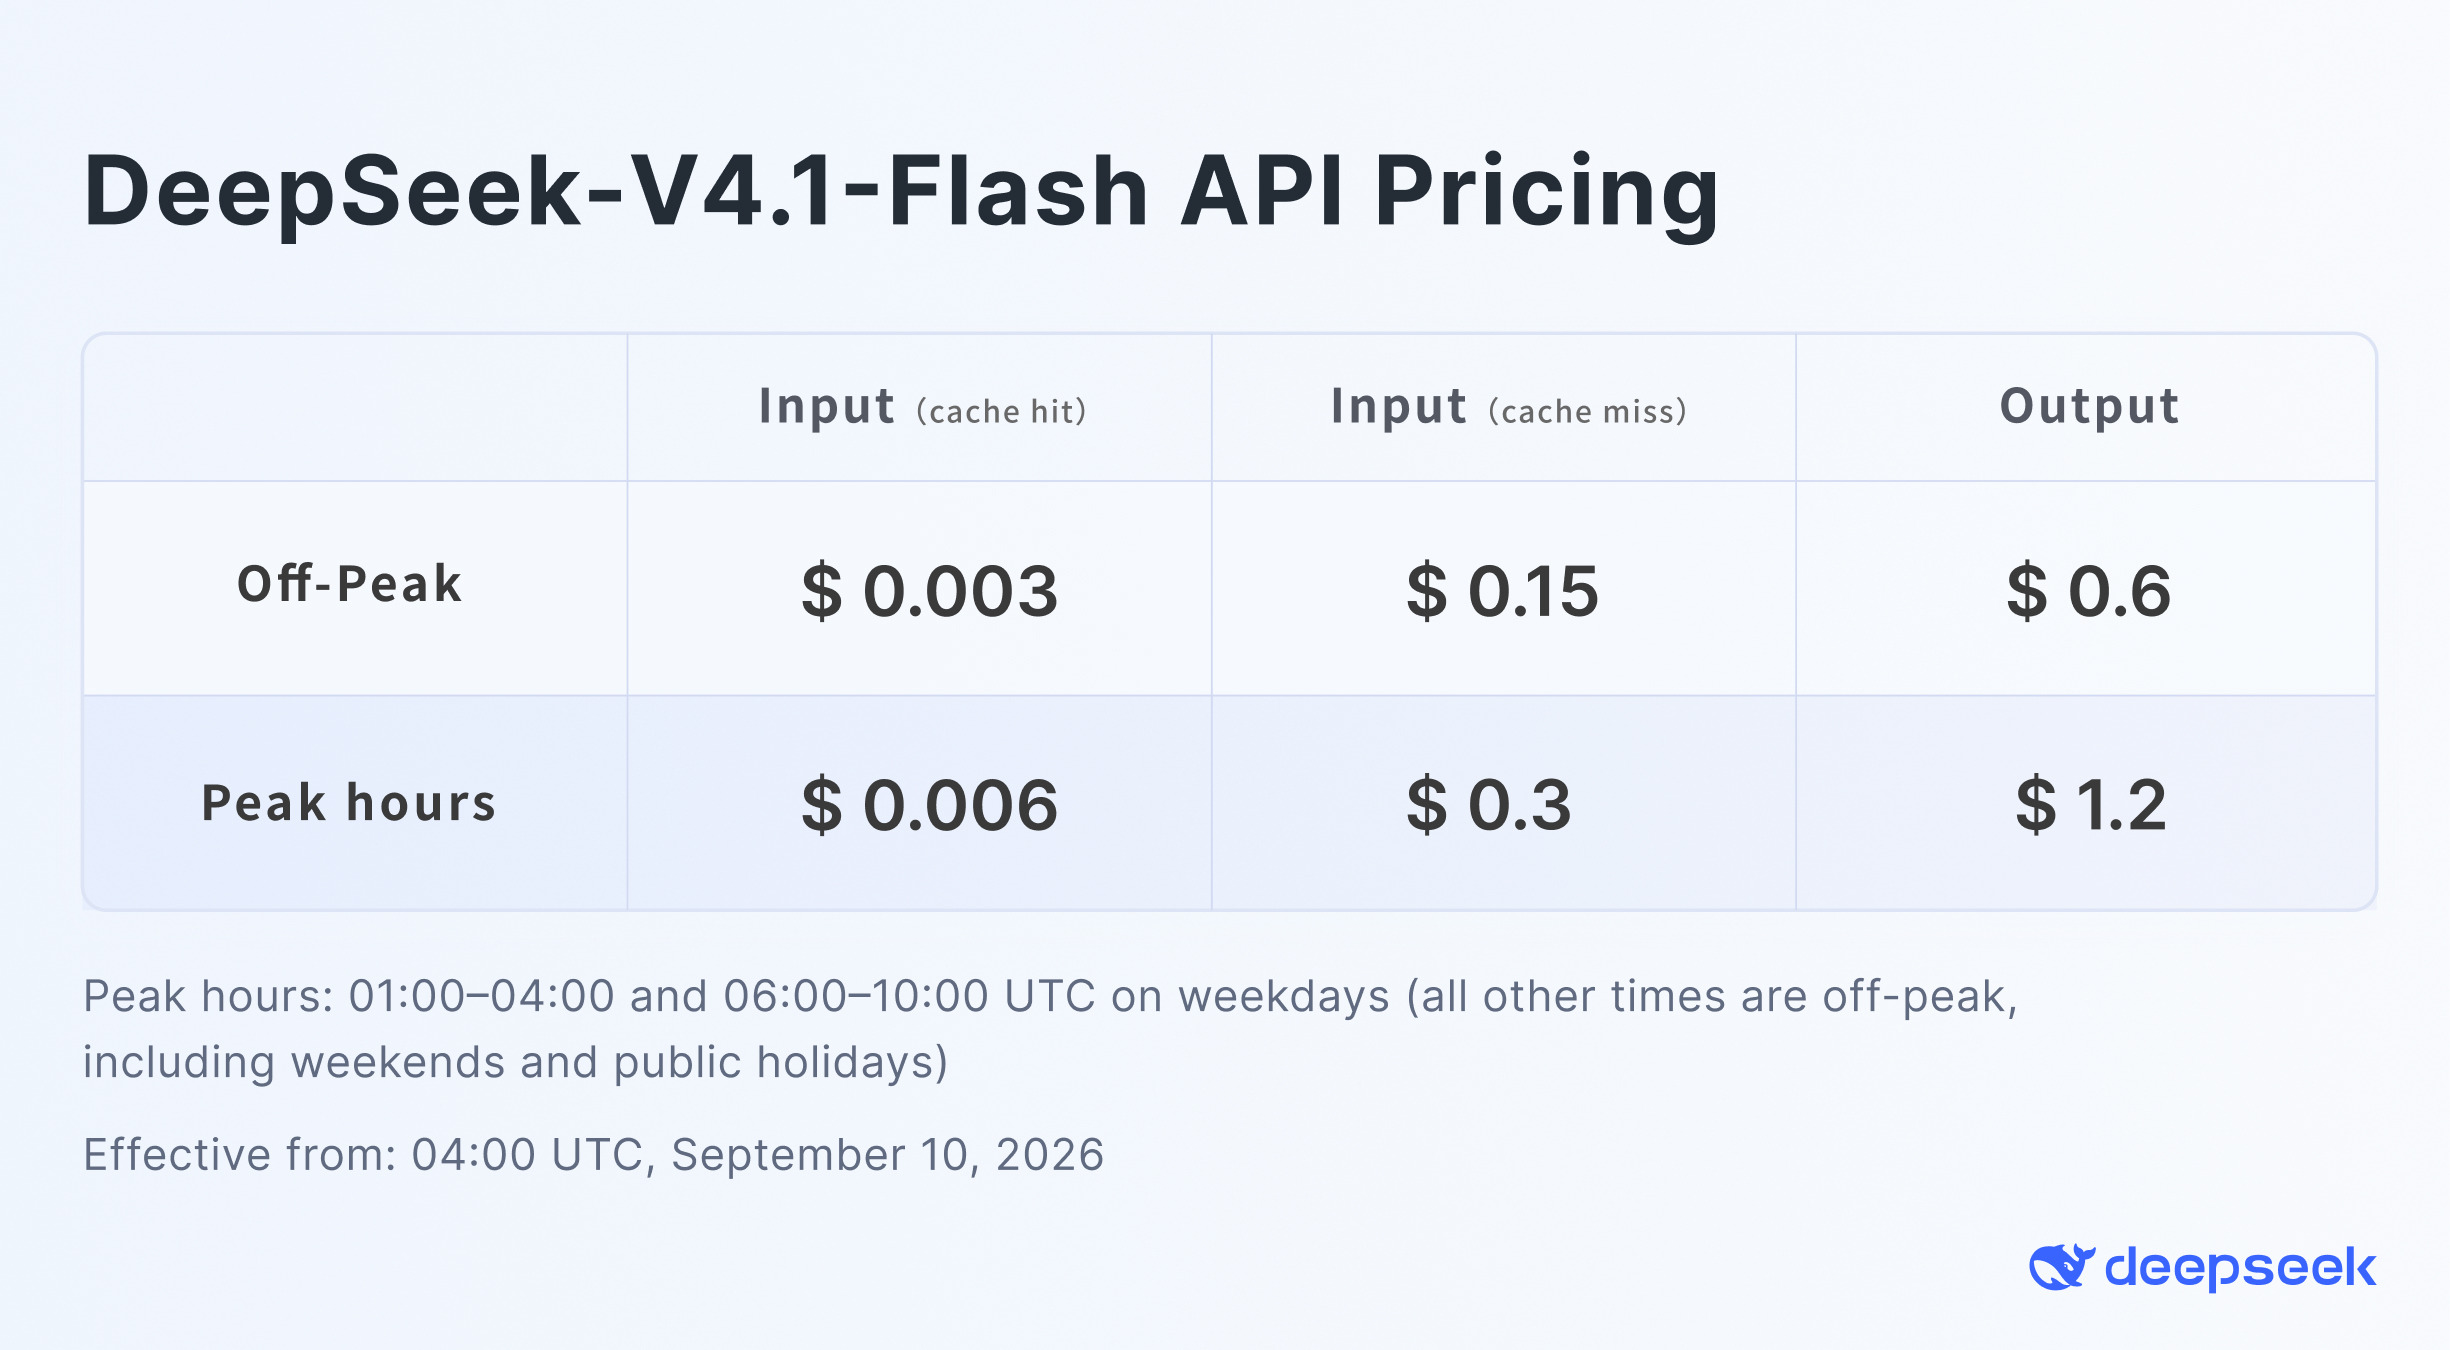
2026 年 9 月 10 日起,DeepSeek-V4.1-Flash 在 API 平台以 deepseek-flash 模型名提供服务,启用高峰/非高峰分时计价(高峰时段为工作日 UTC 01:00–04:00 与 06:00–10:00,其余时间含周末/节假日为非高峰,非高峰价为高峰价的 50%):
| V4.1-Flash 价格(美元/百万 tokens) | 非高峰 | 高峰 |
|---|---|---|
| 输入(缓存命中) | $0.003 | $0.006 |
| 输入(缓存未命中) | $0.15 | $0.30 |
| 输出 | $0.60 | $1.20 |
对比一下:GPT-5.6 Luna(OpenAI 最便宜的主流模型)标准输出价为 $1.20/M,DeepSeek V4.1-Flash 高峰输出价恰好也是 $1.20/M,但非高峰只要 $0.60/M;而它的评测成绩在多个基准上还领先 Luna 一个身位。国产模型的价格优势依然显著。
按人民币计价的国内充值价(以官方控制台实时价格为准):DeepSeek-V4-Flash 此前为输入 ¥1/M(缓存命中 ¥0.02/M)、输出 ¥2/M;V4-Pro 为输入 ¥3/M(缓存命中 ¥0.025/M)、输出 ¥6/M。新版本上线后,deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 会临时路由到 V4.1-Flash;自 2026-09-14 04:00 UTC 起,所有 deepseek-v4-pro 请求也按 V4.1-Flash 的价格路由到 V4.1-Flash,直到 V4.1-Pro 发布——官方明确表示正在逐步淘汰 V4-Pro。
四、接口生态:一鱼两吃
DeepSeek API 同时兼容两套主流接口规范:
- OpenAI 格式:Base URL
https://api.deepseek.com,OpenAI SDK 改个 base_url 即可用; - Anthropic 格式:Base URL
https://api.deepseek.com/anthropic,可接入 Claude Code 等原生工具。
模型支持思考/非思考双模式(deepseek-chat / deepseek-reasoner 两个旧模型名已于 2026-07-24 弃用,分别映射到 V4.1-Flash 的非思考与思考模式),并支持 JSON Output、Tool Calls、对话前缀续写、FIM 补全(Beta)等工程能力。配合官方合作伙伴 WorkBuddy(含 CodeBuddy)、OpenCode 的完整支持,从”换个底座”到”迁移工具链”都相当顺滑。
五、客观分析:优势与局限
优势:
- 性能/价格比全球领先:用接近最低档的定价提供旗舰级能力,Agent、批处理、长文本场景成本优势尤其明显;
- 完全开源:MIT 协议 + 开放权重,可自部署、可微调、可商用,不受单一厂商锁定;
- 百万上下文 + 长输出:1M 上下文与 384K 输出上限,非常适合长文档、代码仓库级分析;
- 非对称架构的工程红利:输入 8B/输出 16B 的激活参数显著降低推理成本,且新架构为其后续更大规模模型铺路。
局限:
- 多模态起步晚:V4 基础版为纯文本,V4.1 才加入视觉理解,多模态成熟度(图像生成、视频、语音)与 GPT 系列仍有差距;
- 部分顶级推理基准仍落后:GPQA、HLE 等纯知识推理项目上,与 GPT-5.6 Sol、Claude Opus 5 尚有数个百分点的差距;
- 生态工具链仍在追赶:虽然 OpenAI/Anthropic 双兼容降低了迁移成本,但官方 IDE 插件、Agent 框架的深度集成仍在建设中;
- 分时计价需要规划:高峰/非高峰价差 2 倍,工作负载若不调度,实际成本优势会打折扣。
六、适合谁用
- 创业公司与中小团队:用 1/10 甚至更低成本做出接近旗舰效果的产品;
- 长文本与 Agent 场景:百万上下文 + 低缓存价,Agent 多轮调用成本可控;
- 需要自部署的机构:MIT 开源权重可私有化部署,满足数据合规要求;
- 追求极致推理上限的用户:知识推理类任务上,旗舰闭源模型仍值得对比后再选。