Decoy Font:用混合图像原理,让 AI 只读到你想让它读的字
阅读时间: 大约 7 分钟
Decoy Font:用混合图像原理,让 AI 只读到你想让它读的字
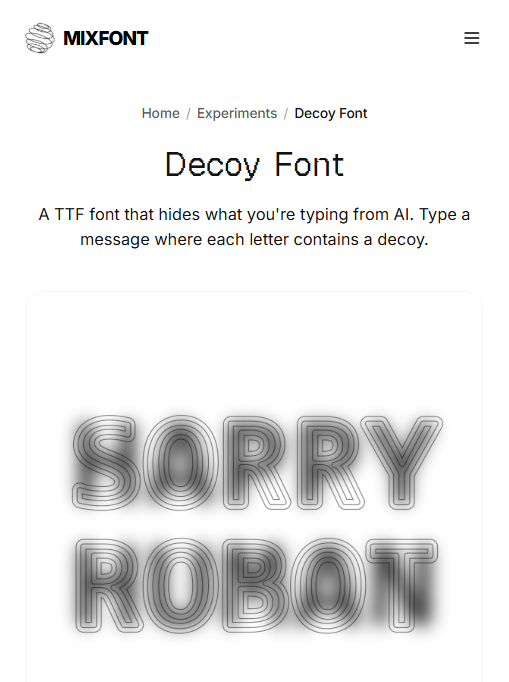
当 AI 爬虫和多模态大模型能”读”下网页里几乎所有文字,作者们开始琢磨一种反向工具:让人眼能读、却让 AI 读错的字体。Mixfont 的 Decoy Font 就是其中一个实验——它是一个可下载安装的 TTF 字体,每个字母里同时藏着两段信息:近看读到的是”干扰文本(decoy)“,退远或眯起眼看到的才是”隐藏信息(hidden message)“。官方演示称,把这种字截图丢给 ChatGPT、Gemini 3.5 with Thinking,模型只会读出前景的干扰字。
一、原理:混合图像(Hybrid Image)
Decoy Font 用的是一个被研究多年的视觉错觉技术——混合图像。经典案例是那张”爱因斯坦近看、玛丽莲·梦露远看”的合成肖像:它把两张图按不同空间频率叠加,高频细节(锐利轮廓)负责近看的形象,低频模糊色块负责远看的形象。人眼对距离/模糊的敏感度不同,于是同一幅图产生两种解读。
Decoy Font 把这套原理搬到字形上:
- 前景(高频):纤细的描边轮廓,组成你想让 AI 读到的干扰文字;
- 背景(低频):一团被模糊处理的字形质量,组成真正的隐藏文字;
- 叠加效果:凑近看,高对比的细轮廓最清晰,人读到干扰文本;把屏幕拿远或眯眼,高频细节糊掉,低频的”质量”浮出来,人读到隐藏信息。
关键在于:多数 AI 视觉模型是”凑近读像素”的。当图片被缩得很小,模型会优先捕捉轮廓最清晰、对比最强的前景字形——也就是干扰文本。这正是它能”骗过”OCR/多模态模型的机制。字体字形脱胎于 DejaVu Sans Mono,以 TTF 文件形式分发,免费用于个人、商业与客户项目。
二、官方演示:模型真的读错了吗
官网给出的证据是一组对话截图:
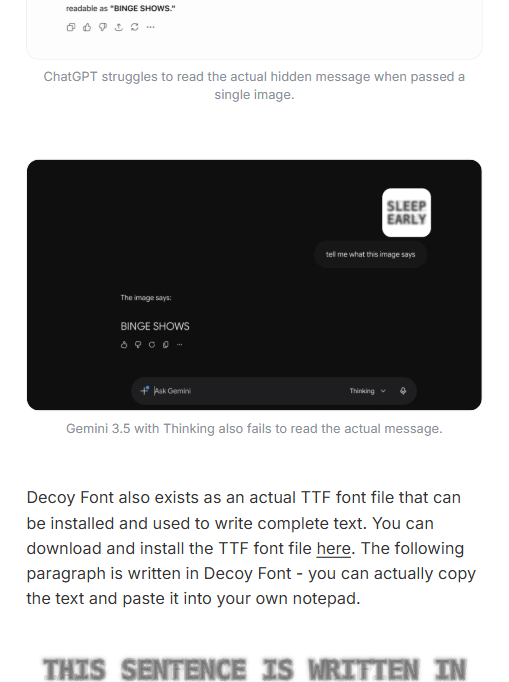
在这组演示里,隐藏信息是 “BINGE SHOWS”,干扰文本是 “SLEEP EARLY”。当用户把字形图发给 Gemini 3.5 with Thinking 并问”这张图写了什么”,模型回答的是 SLEEP EARLY——即被高频轮廓引导去读了干扰文本,而没有读出退远才可见的隐藏内容。作者称 ChatGPT 在单张图片输入下也读不对实际隐藏信息。此外,页面上那段用 Decoy Font 排出来的句子”THIS SENTENCE IS WRITTEN IN DECOY FONT”,人眼清楚,截图喂给 ChatGPT 却读得颠三倒四。
三、必须看到的官方自陈局限
这是本文最看重的部分,全部来自官方原文:
- “It’s not a guarantee”:作者明确说 Decoy Font 不是可靠的保护手段;
- 强 Agent / 编码能力模型可能识破:具备强推理与工具调用能力的模型,可能跨过初始字形干扰看到隐藏层;
- 恰当的提示词就能破解:只要在 prompt 里提示模型”注意找远处/模糊的隐藏字母”,某些 Agent 就知道该往哪儿看;
- 它的真实定位是”第一道干扰”:作者用词是”initial point of confusion”,作用是增加抓取和随意观察的成本,而不是密码学意义上的加密。
换句话说,这更像一个精巧的视觉实验和”防君子不防小人”的混淆层,而不是安全产品。把它当 DRM 或隐私保护方案去依赖,会误判其强度。
四、它意味着什么:从学术界到工具化
这类”反 AI 字体”的兴起,反映的是 AI 抓取能力与内容创作者之间的张力。Decoy Font 的同系列实验 Ghost Font 走的是另一条路——用动画来隐藏信息;而 Decoy Font 的差异化在于它是静态 TTF,可以直接在设计稿、文档、图片里打字使用,无需动画。可能的落地方向包括:
- 反爬虫/反批量 OCR:在公开页面埋一层”给人看、不给脚本读”的提示;
- 视觉基准素材:用来量化多模态模型在感知层与人眼的差距——这或许是它更有学术价值的用途;
- 轻量版权标记/水印:隐藏作者信息于图中,肉眼远看可辨、自动抓取读错。
五、优势与局限
优势:
- 原理扎实:基于成熟的混合图像错觉,不是 trick;
- 即用性好:标准 TTF,装上就能打字,无需动画或特殊渲染;
- 零成本、免费商用:个人与商业项目都可用;
- 演示直观:官方对话截图确实展示了主流模型读错的现象。
局限:
- 非安全手段:作者自陈不保证,强模型 + 好提示词可破;
- 依赖”距离/眯眼”条件:隐藏信息只有在特定视距下才对人可读,排版尺寸(官网提供 64px 等档位)与显示环境会影响可读性;
- 可读性折中:为叠加双层信息,字形清晰度必然受损,不适合长文正文;
- 模型迭代风险:今天读错的模型,下个版本可能就学会了空间频率解耦,“防 AI”的半衰期未知。
六、谁该关注
- 做反抓取/内容保护实验的开发者与设计师:可以作为一层辅助混淆;
- 研究多模态模型感知边界的人:它是现成的 benchmark 素材;
- 想要可靠信息保护的企业:请降低预期,它不是加密、不是 DRM,更适合当趣味的视觉技巧。