Dask:让 pandas/NumPy 跑出集群规模的 Python 并行计算库
阅读时间: 大约 10 分钟
Dask:让 pandas/NumPy 跑出集群规模的 Python 并行计算库
数据分析师和科学家在单机上把 pandas、NumPy 用得很熟,但数据一旦超过内存、或者需要上千核一起算,要么手写多进程,要么被迫迁去 Spark——而 Spark 的 API 是另一套心智,调试也不在 Python 里。Dask 走的是中间路线:保留你已经会的 pandas/NumPy 写法,在后台把它自动拆成可以在多核、集群上并行跑的任务图。本文基于 dask.org 官网与官方文档,拆解它的机制、可核对数字与官方宣传里需要打折扣的地方。
一、背景动机:单机 Python 数据栈的天花板
pandas/NumPy 是 Python 数据生态的事实标准,但它们默认单进程、单台机器、数据要放进内存。当数据从 GB 涨到 TB、PB,团队要么垂直升级大内存机器(贵),要么上 Hadoop/Spark(重、且要写 Scala/SQL 另一套)。Dask 的作者 Matthew Rocklin 等提出:与其再造一个新 API,不如把 pandas/NumPy 本身切分成小块(chunk),在小块之间做并行与调度。它是 NumFOCUS 赞助的开源项目,背后有 Anaconda 与商业化公司 Coiled 支撑。
二、是什么:两层 API 设计
Dask 分两层:
- 高层集合(High-level collections):
dask.dataframe(模仿 pandas)、dask.array(模仿 NumPy ndarray)、dask.bag(处理非结构化/半结构化数据),外加dask-ml(并行机器学习)。你写的代码长得跟 pandas/NumPy 几乎一样,官网示例里dd.read_parquet("s3://...").base_passenger_fare.sum().compute()就是典型; - 低层调度器(Low-level scheduler):把高层操作编译成一张任务图(task graph)——一堆带依赖关系的小函数节点,再由本地线程/进程池或分布式集群调度执行。
三、技术机制:分块 + 任务图调度
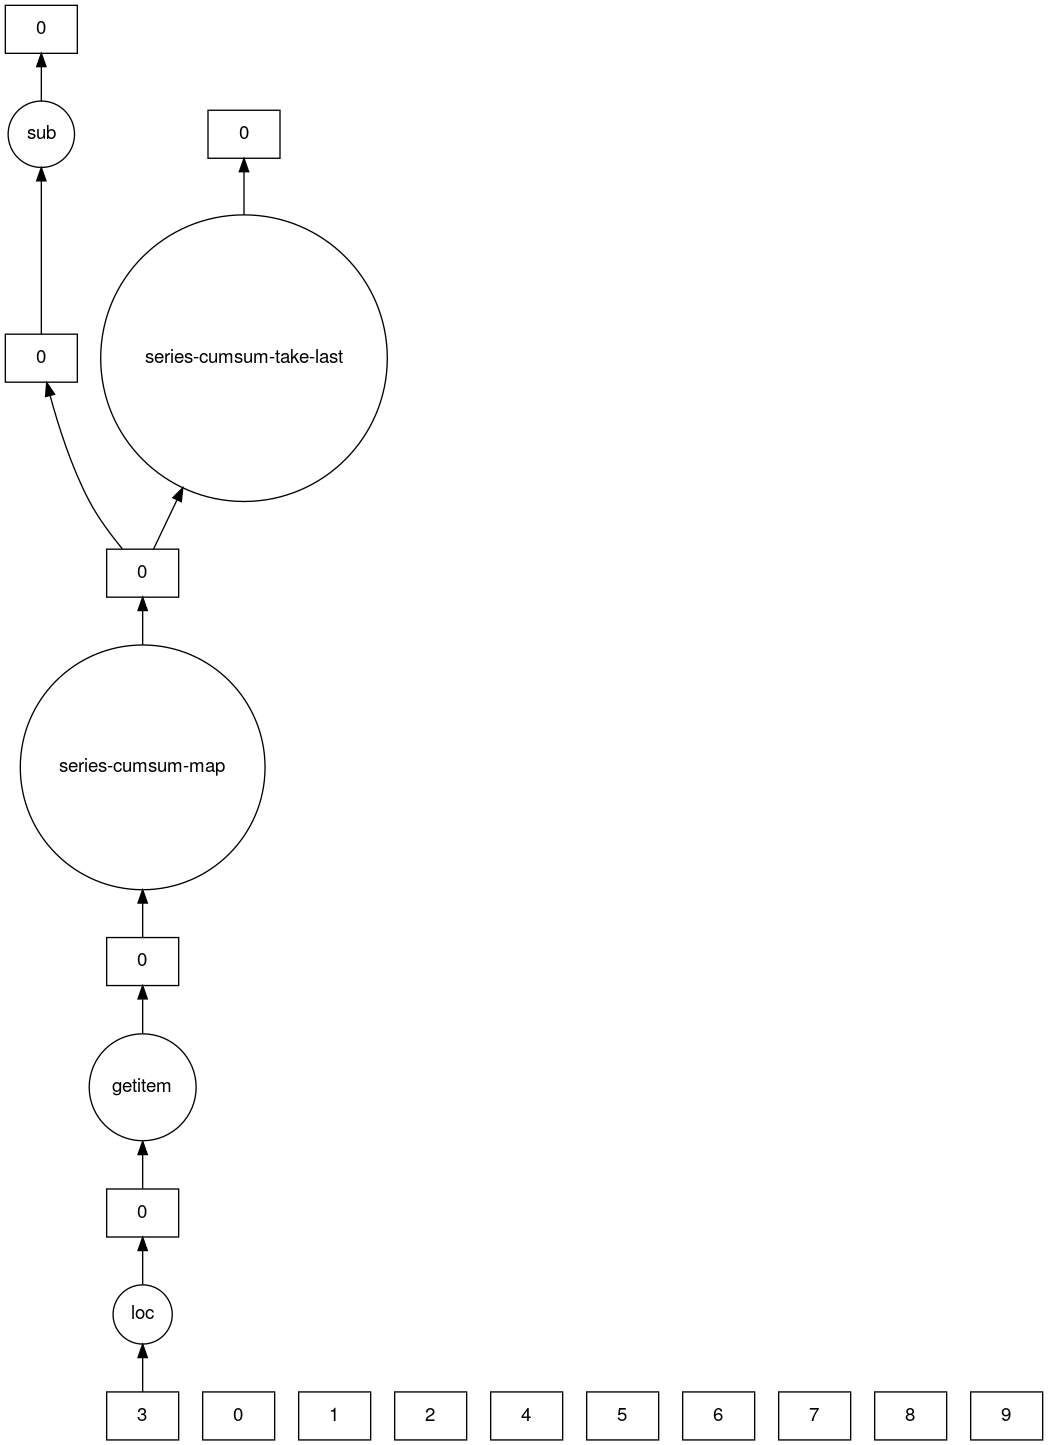
以 DataFrame 为例:一个逻辑上很大的表,被 Dask 沿索引切成很多个小 pandas DataFrame 分区(图中底部的 0–9)。你调用 cumsum 这类操作时,Dask 并不立刻计算,而是先构建一张 DAG:每个分区各自算一部分,再通过 loc、getitem、series-cumsum-map、series-cumsum-take-last 等底层节点串起跨分区的依赖,最后在 .compute() 时才真正调度执行。这张图就是上面那张官方任务图。
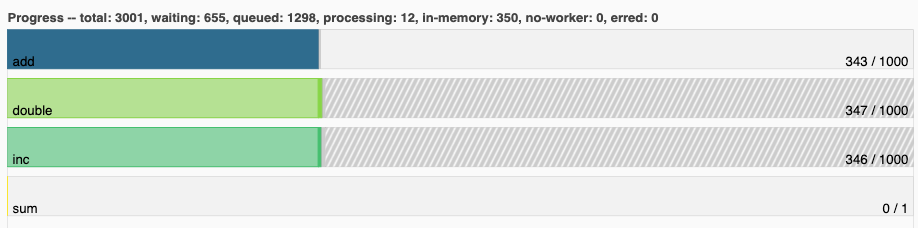
这种设计的好处是:调度器能看到全局依赖,可以在数据本地性允许的地方调度、跨节点流水线执行、遇到慢任务自动重试,而不是把整个 DataFrame materialize 出来。配合 Web Dashboard(进度、任务流、内存、worker 状态),用户能直观看到集群在干什么——这是 Dask 反复强调的”Made for Humans”。
部署上它极轻量:笔记本上 LocalCluster() 几行代码就能起本地并行;同一套代码可以原封不动搬到 Kubernetes、HPC 调度器或云托管服务上。
四、关键数据:官方口径
| 项目 | 官方口径 |
|---|---|
| 开源协议 | BSD-3,NumFOCUS 项目 |
| 兼容 API | pandas、NumPy、原生 Python 循环、scikit-learn 风格 |
| 运行环境 | 笔记本、K8s、HPC、云托管、遗留 Hadoop/Spark 集群 |
| 对比 Spark | 官网称”在标准 benchmark 上比 Spark 快约 50%”、“比 Spark 更快也更简单” |
| 处理成本 | 官网称用户常以”每 TiB 约 $0.10”处理云数据 |
| 客户证言 | Capital One 称数月内把模型训练时间缩短 91% |
| 展示用户 | Microsoft、NASA、NVIDIA、Shell、US Air Force、DE Shaw、Grubhub |
五、评测方法与口径偏差
- “比 Spark 快 50%“是选择性主张:这句话限定在”standard benchmarks”,且是在 Dask 自己擅长的、Python 生态内、内存友好的工作负载下。Spark 在超大规模批 SQL、稳定管线、多语言(Scala/Java)生态上仍有工程优势;Dask 的优势在于”不用离开 Python”,而不是绝对碾压;
- “$0.10/TiB”是示意成本:它描述的是云对象存储 + 空闲 spot 实例的理想账,不含人力运维、存储冗余与失败重试成本,不能当成真实 TCO;
- “你的 pandas 代码几乎直接能跑”有水分:Dask DataFrame 只覆盖 pandas API 的一个子集,某些操作(尤其是会改变分区索引的全局排序、复杂逐行 apply)要么不支持、要么代价很高;
- 91% 训练加速是单一客户证言:Capital One 的数字是其内部特定管线改造前后对比,前提是”早期实现、数月开发投入”,不可直接外推;
- 官方网站把”已处理行数 1e12、成本 $0.00”做成动画,这是营销隐喻,不是实测账单。
六、适用 / 不适用场景
适用: 已经在用 pandas/NumPy、数据略大于内存但不想换语言的数据团队;Xarray 多维科学计算(气候、地球科学);在 K8s/HPC 上跑并行 Python 计算与轻量分布式 ML;需要交互式、可观察的调试体验。
不适用: 已经有成熟 Spark/SQL 数仓管线、团队需要多语言与稳定批处理 SLA;数据规模需要严格的 SQL 优化器与增量/流处理语义;强依赖 pandas 中 Dask 未覆盖的边缘 API;不想自己操心集群内存与分区调优的纯业务团队(可考虑其托管云 Coiled)。
七、客观分析:优势与局限
优势:
- 学习成本低:直接复用 pandas/NumPy/原生 Python 心智,不需要学一套新的分布式 API;
- 轻量、随处可跑:从笔记本到 K8s/HPC 同一套代码,无虚拟化、无额外编译器;
- 任务图 + Dashboard 可观察:把分布式计算的黑盒打开,方便调优;
- 科学计算生态好:与 Xarray、scikit-learn、Ray 等衔接自然,气候/天文/生物领域用得多。
局限(官方隐含或需警惕):
- 不是 Spark 的等价替代品:API 是子集,超大规模批 ETL 与多语言生态不如 Spark;
- Python 开销与内存调优:任务粒度、分区大小、worker 内存都需要经验,调不好会 OOM 或反序列化爆炸;
- 强一致/事务/SQL 优化能力弱:它是计算库,不是数据库;
- 生产运维要自己扛:开源版集群调度、扩缩、高可用需要自行部署,商业支持靠 Coiled。
八、它意味着什么 / 谁该关注
Dask 的意义在于证明了”在不改变 Python 数据科学体验的前提下,并行计算是可以被透明地加上去的”。对已经深陷 pandas 生态、又被迫面对超内存数据的团队,它是迁移成本最低的分布式化路径;但如果你的目标是构建公司级、跨团队、多语言的数据湖仓管线,Spark/Flink 这类成熟引擎仍更稳妥。正确的姿势是:把 Dask 当作 Python 侧的”向外扩展(scale-out)补丁”,而不是万能数据操作系统。