CozoDB:用 Datalog 查询的事务型嵌入式关系-图-向量数据库
阅读时间: 大约 10 分钟
CozoDB:用 Datalog 查询的事务型嵌入式关系-图-向量数据库
当大家谈论”下一代嵌入式数据库”时,目光通常落在 SQLite 的各路重写(见本系列关于 Limbo 的文章)或专用向量库上。CozoDB 走了一条不太一样的路:它是一个通用、事务型、可嵌入式的数据库,查询语言不是 SQL,而是 Datalog;它同时把关系模型、图算法和 HNSW 向量搜索揉进同一个引擎里,官方给自己的定位是”AI 的海马体(hippocampus for AI)“。本文基于 CozoDB 官方 GitHub 仓库与在线文档,梳理它的设计动机、技术机制、官方性能口径与真实局限。
一、背景动机:为什么要在关系库里写图查询
数据本质上是相互关联的,但传统关系模型要求你把多对多关系拆成关联表,写递归(比如”从法兰克福出发经任意转机可达的机场”)时只能靠 SQL 嵌套 WITH RECURSIVE,越写越像代码高尔夫。而传统图数据库(如 Neo4j 的属性图模型)又要求你先把数据塞进”带标签属性图”这套里,丢失了关系表的代数可组合性。
CozoDB 的判断是:关系模型本身是一种代数,完全可以表达图查询,没必要把数据搬到属性图里。于是它保留关系表存储,用 Datalog 的递归规则来表达图运算,并把 PageRank、最短路这类常用图算法做成内置算子。
二、概念定位:什么叫”可嵌入式”
CozoDB 官方对”embedded”有一个很具体的判据:如果你能在一台永远不连网的手机上跑它,它就是嵌入式的。SQLite 是嵌入式;MySQL/Postgres 是客户端-服务器。嵌入式数据库跑在你程序的同一进程里,不需要单独部署。
CozoDB 刻意用”embeddable(可嵌入)“而非”embedded(已嵌入)“这个词,因为它同时提供客户端-服务器模式(独立 HTTP 服务),以便在高并发下更好地利用服务器资源。它用 Rust 编写,当前以 MPL-2.0 协议开源。
三、技术机制:三层架构 + 多存储后端
CozoDB 在 README 里把自己画成三层,每层只调用下一层:
(用户代码)
语言/环境封装层
查询引擎
存储引擎
(操作系统)- 存储引擎层定义了一个键值存储 trait(要求支持范围扫描),实现包括:纯内存(非持久)、SQLite、RocksDB、Sled,以及分布式的 TiKV 后端。其中 SQLite 后端比较特殊——它同时被用作备份文件格式,方便不同后端之间交换数据;但因为存储层采用自有的 row-oriented memcomparable 二进制格式,SQLite 后端生成的数据文件无法用普通 SQL 直接查询,必须经过 Cozo 的解码过程。
- 查询引擎层是代码主体:函数/聚合/内置算法、schema、事务、查询编译与执行。它在并发写保护上采用 MVCC,支持多语句事务。
- 语言封装层把 Rust API 翻译到各语言:Python、Node.js、Java、Clojure、Android、iOS/macOS(Swift)、Go、C/C++,甚至通过 WASM 在浏览器里跑一个近原生速度的完整实例。
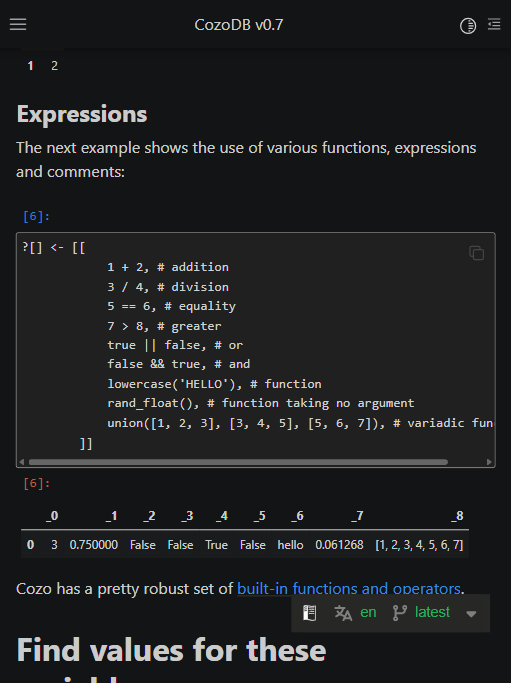
它的查询语言叫 CozoScript(Datalog 方言)。上图是官方在线文档里的真实片段:用 ?[] <- [[ ... ]] 内联一组表达式,引擎直接返回一张结果表。Datalog 的递归规则对图查询特别自然——“从 FRA 出发一站可达""任意转机可达""最短路径”都只是几行规则,而且规则像函数一样可拼接。
版本演进上:v0.6 在 Datalog 里内置了 HNSW 向量索引,且向量搜索可以和递归 Datalog、即席连接混用;v0.7 又加入了 MinHash-LSH 近重复搜索、全文检索和 JSON 值支持。这意味着向量召回不再需要外挂一个向量库,可以直接和关系/图查询在一条语句里完成。
四、官方性能口径
以下数字全部来自官方 README,测试条件是”一台 2020 款 Mac Mini + RocksDB 持久化后端”:
| 场景(官方称) | 数据规模 | 指标 |
|---|---|---|
| OLTP 混合读写事务查询 | 单关系 160 万行 | 约 10 万 QPS |
| 只读查询 | 同上 | >25 万 QPS |
| 数据库峰值内存 | 同上 | 约 50 MB |
| 备份速度 | — | 约 100 万行/秒 |
| 恢复速度 | — | 约 40 万行/秒 |
| OLAP 全表扫描 | 160 万行 | 约 1 秒(±2 倍) |
| 两跳图遍历 | 160 万顶点 / 3100 万边 | <1 ms |
| PageRank | 1 万顶点 / 12 万边 | 约 50 ms |
| PageRank | 160 万顶点 / 3200 万边 | 约 30 秒 |
五、评测方法批判:这些数字怎么读
需要清醒地认识到,上表是作者自测、官方公布的口径,不是第三方独立 benchmark:
- 机器是 2020 款 Mac Mini,不是服务器级 SSD,也没有说明 CPU 具体型号、内存、是否预热;
- 只测了 RocksDB 后端,内存后端、SQLite 后端、Sled、TiKV 的数字没有给出;
- OLTP 的”混合读写” workload 没有公开分布比例,QPS 对读写比极其敏感;
- “扫描 160 万行约 1 秒(±2 倍)“这种带浮动区间的表述,本身说明结果对具体算子组合很敏感;
- HNSW 向量性能一句”基础向量操作本身已成为瓶颈(连同 memcpy)“是工程化描述,没有给出与 FAISS、HNSWlib 等专用向量库的对比数字。
换句话说:这些数字适合用来建立”CozoDB 不慢、嵌入式里算能打”的量级直觉,不适合用来和 Postgres、Neo4j、专用向量库做精确性能选型对比。
六、口径偏差与官方自己承认的局限
这一节是 CozoDB README 里白纸黑字写明的 nuance,值得单独拎出来:
- “CozoDB 还很年轻(still very young)“,并且明确承诺:1.0 之前的版本不保证语法/API 稳定,也不保证存储格式兼容。这意味着跨版本升级可能需要导出再恢复,生产升级要留足迁移成本。
- 时间旅行(time travel)不是默认能力:它采用 per-relation 按需开启,因为”每多一份能力就多一份开销”,不用就别付这个价。
- SQLite 后端文件不可直接 SQL 查询(见前文),把它当成”一个能被 Datalog 读的 SQLite 文件”是误解。
- Datalog 有学习曲线:它不是 SQL 的方言,团队如果只会 SQL,迁移成本主要在思维方式而不是语法替换。
- RocksDB 调优”对 95% 的用户没必要”,剩下 5% 的人如果乱改
options文件,“会让数据库行为异常”。
七、优势与适用人群
优势:
- 一个引擎同时覆盖关系、图递归、向量(HNSW)、近重复(MinHash-LSH)、全文检索,少装一个组件;
- 真正可嵌入式——手机、浏览器 WASM、桌面端都能跑,同时又能切到客户端-服务器模式;
- MVCC 事务 + 多存储后端,从内存到分布式 TiKV 都能选;
- Rust 实现,嵌入式场景下内存占用低(官方称 160 万行峰值约 50 MB)。
局限:
- 1.0 之前不保证 API/存储兼容,生产长线使用有风险;
- 性能数字来自官方自测,缺第三方对照;
- Datalog 生态远小于 SQL,DBA 与运维工具链薄弱;
- 文档与案例相比主流数据库仍少,遇到问题主要靠 GitHub Discussion。
适合谁: 需要在进程内同时做”关系数据 + 图遍历 + 向量召回”的 AI 应用(比如记忆层、RAG、知识图谱嵌入式场景)、想在浏览器/手机端跑完整数据库的开发者,以及愿意接受新查询语言以换取递归表达力的团队。如果你只是要一个稳定、SQL 生态成熟的 OLTP 嵌入式库,SQLite 仍然是更稳妥的选择。